
O imposto do token persa: o custo de LLMs fora do inglês
O persa consumiu 1,53× os tokens do inglês no tokenizador do GPT-4o e 3,26× no do GPT-4, em 1.012 frases paralelas. Método, resultados e o que testar.
Texto em persa (farsi) custa mais tokens que texto em inglês para o mesmo conteúdo. Esse acréscimo é o imposto do token persa, e seu tamanho depende mais do tokenizador do que do alfabeto. Contei os tokens das mesmas 1.012 frases do benchmark FLORES-200, em inglês e em persa. O persa precisou de 1,53× a contagem do inglês no o200k_base, o encoding que a biblioteca tiktoken da OpenAI associa ao GPT-4o, e de 3,26× no cl100k_base, o que ela associa ao GPT-4. Esses dois foram os extremos entre os quatro tokenizadores usados por modelos de geração de texto; o bge-m3, tokenizador de um modelo de embedding, ficou em 1,10×. Claude e Gemini não entram nesta medição: a Anthropic não publica o tokenizador do Claude, e não testei o tokenizador local que o SDK da Google oferece para o Gemini. Os dois fornecedores contam os tokens dos próprios modelos por uma API.
Estes números são um retrato datado, medido em 17 de setembro de 2026 com versões fixadas dos tokenizadores.
Por que o persa (farsi) gasta mais tokens: bytes, merges e dados de treino
APIs de modelos de linguagem cobram por token. Em 2023, Ahia e colegas encontraram indícios de que “falantes de um grande número dos idiomas suportados pagam a mais e obtêm resultados piores”. Petrov e colegas mostraram que o mesmo texto traduzido para idiomas diferentes pode variar no comprimento da tokenização “até 15 vezes em alguns casos”. Um estudo de 2025 sobre mais de duzentos idiomas relata “com frequência, razões de RTC de 3 a 5 vezes maiores” para idiomas de alfabeto não latino e morfologia complexa, em que RTC é o “Relative Tokenization Cost” dos autores.
É esse o imposto do token: o mesmo significado, uma conta maior.
Todo tokenizador em nível de byte começa pelos bytes
Um tokenizador BPE em nível de byte (byte-pair encoding), o tipo que está por trás do GPT-4o, do Qwen3 e do DeepSeek-V3, parte dos bytes do texto em UTF-8 e funde sequências frequentes de bytes em tokens. Uma letra latina sem acento ocupa um byte; as letras do iorubá com marca de tom e ponto subscrito ocupam dois ou mais. Uma letra persa ocupa dois, e o zero-width non-joiner usado dentro das palavras persas ocupa três. No FLORES, o arquivo em persa ocupou 1,69× os bytes do arquivo em inglês em UTF-8, com 0,94× os caracteres. O persa não é mais longo em caracteres. Ele é mais pesado de codificar.
O que acontece depois depende dos merges que o tokenizador aprendeu com os próprios dados de treino. Passar do cl100k_base para o o200k_base cortou 53,5% dos tokens do persa e 1,1% dos do inglês. O vocabulário mais novo mudou o persa, não o inglês.
O iorubá escreve em alfabeto latino e paga mais
Se o alfabeto decidisse o imposto, os idiomas de alfabeto latino quase não o pagariam. Um artigo de workshop de Roy, Roy e Patel (aceito em um workshop da IJCAI 2026, no arXiv desde agosto de 2026) constatou, na auditoria que fizeram, que “o iorubá, apesar de usar o alfabeto latino, apresenta o maior prêmio de tokenização do GPT-4o”, em 2,37×. Os autores apontam para os diacríticos e para a cobertura do vocabulário. Nesse artigo, o iorubá é uma comparação exploratória: suas traduções foram geradas por máquina e inspecionadas manualmente, enquanto o bengali e o hindi são os casos validados.
Minha medição aponta na mesma direção. O iorubá custou mais que o persa em quatro dos cinco tokenizadores, e o árabe custou menos que o persa em quatro dos cinco. A exceção do árabe é o bge-m3, um modelo de embedding construído sobre o XLM-RoBERTa e seu vocabulário. O XLM-R foi treinado em cem idiomas tirados do CC-100: 13.259 milhões de tokens de persa contra 2.869 milhões de árabe, e o iorubá não estava entre eles. Isso é consistente com a participação nos dados de treino pesar mais que o alfabeto. Não é prova disso.
Resultados: persa, árabe e iorubá contra o inglês
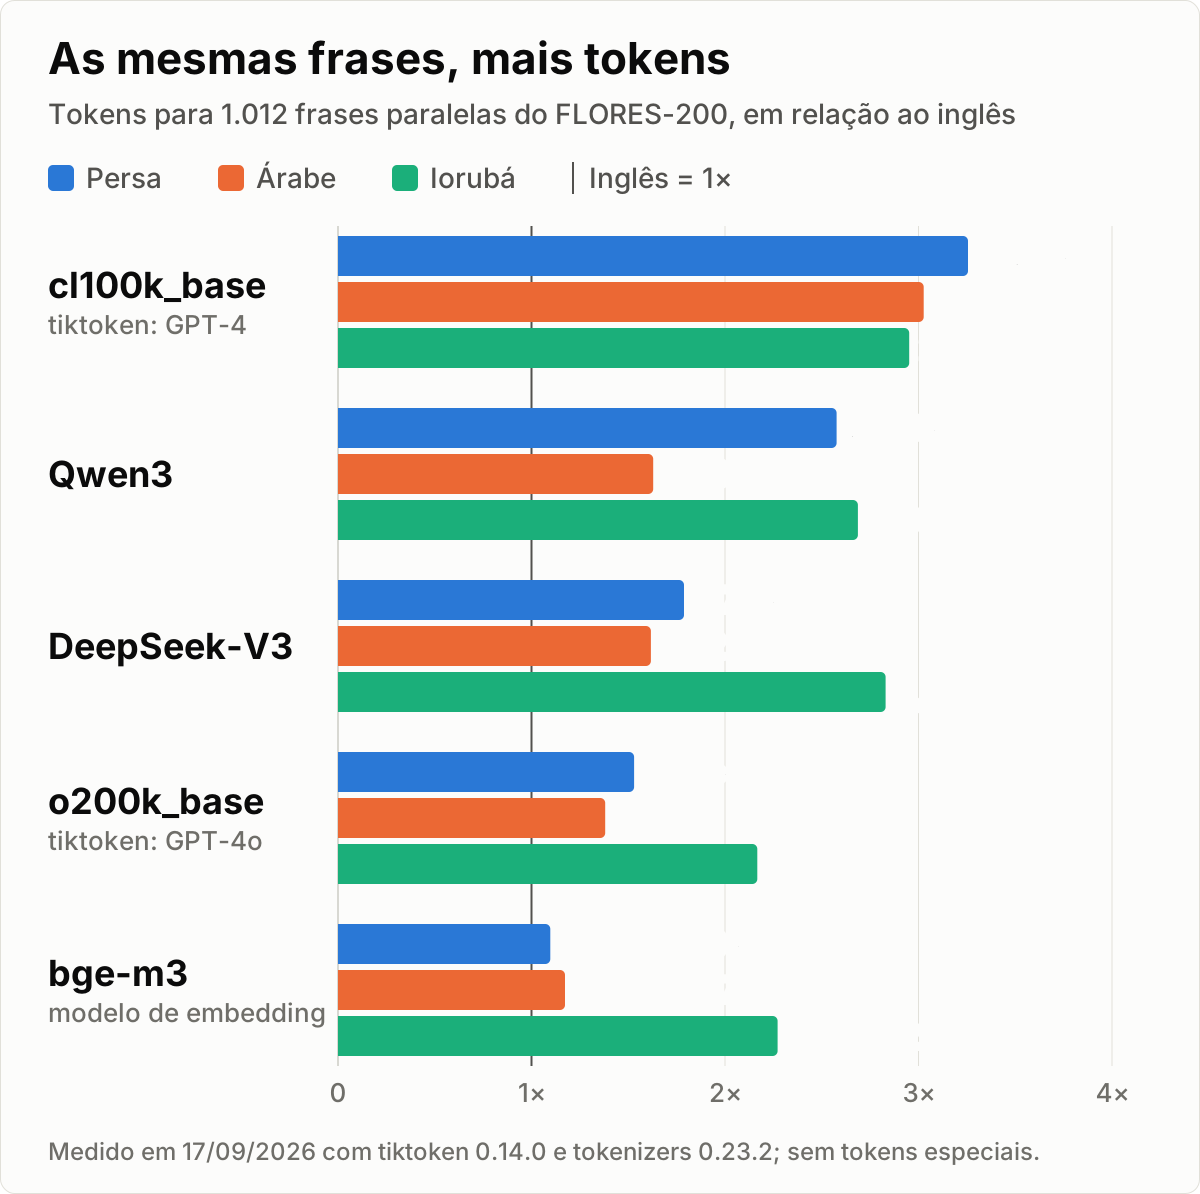
Cada célula é o total de tokens de um idioma dividido pelo total do inglês no mesmo tokenizador:
Tokenizador | Persa (× inglês) | Árabe (× inglês) | Iorubá (× inglês) |
|---|---|---|---|
| 3,26× | 3,03× | 2,95× |
Qwen3 | 2,58× | 1,63× | 2,69× |
DeepSeek-V3 | 1,79× | 1,62× | 2,83× |
| 1,53× | 1,38× | 2,17× |
bge-m3 | 1,10× | 1,17× | 2,27× |
A maior variável é o tokenizador. A razão do persa no pior tokenizador (3,26×) é cerca de três vezes a do melhor (1,10×), e cerca do dobro mesmo entre os quatro tokenizadores usados para geração (3,26× contra 1,53×). O Qwen3 trata o árabe muito melhor que o persa, 1,63× contra 2,58×, então um único número para o alfabeto árabe não cobre os dois idiomas. O resultado do cl100k_base é consistente com contagens já publicadas: os comprimentos de tokenização que Petrov e colegas divulgaram para o FLORES-200, com os splits dev e devtest unidos, colocam o persa ocidental em 3,28× o inglês, contra os meus 3,26× só no split devtest.
Os totais por trás dessas razões, com o tamanho de cada arquivo de idioma antes de qualquer tokenizador tocar nele:
Contagem | Inglês | Persa | Árabe | Iorubá |
|---|---|---|---|---|
Caracteres | 131.966 | 123.830 | 116.320 | 126.848 |
Bytes (UTF-8) | 132.096 | 223.504 | 211.276 | 168.857 |
Tokens, | 27.182 | 88.513 | 82.288 | 80.247 |
Tokens, Qwen3 | 27.621 | 71.183 | 44.991 | 74.226 |
Tokens, DeepSeek-V3 | 27.041 | 48.342 | 43.713 | 76.526 |
Tokens, | 26.873 | 41.116 | 37.117 | 58.238 |
Tokens, bge-m3 | 30.661 | 33.631 | 35.979 | 69.672 |
Seu corpus vai dar outro número
A auditoria de Roy e colegas mediu o o200k_base em 120 itens de depuração em Python traduzidos do inglês, com média por item. Ela relata 1,44× para o árabe e 2,37× para o iorubá, os dois a partir de traduções automáticas. Na prosa do FLORES, traduzida por pessoas, o o200k_base deu 1,38× para o árabe e 2,17× para o iorubá. Mesmo tokenizador, texto diferente e processo de tradução diferente, resultado diferente. Conte seus próprios prompts, trechos recuperados e respostas antes de fazer o orçamento.
Como medi a contagem de tokens do persa
Um corpus de fato paralelo
A equipe do NLLB descreve o FLORES-200 como “um benchmark traduzido por humanos”: as mesmas frases, na mesma ordem, em todos os idiomas. Usei o split devtest, licenciado sob CC BY-SA 4.0, a partir do arquivo oficial e com o hash SHA-256 conferido: 1.012 frases da Wikinews, do Wikivoyage e do Wikibooks, em inglês, persa ocidental, árabe padrão moderno e iorubá.
Ser paralelo importa mais que o tamanho. Uma tradução adaptada, como um currículo bilíngue, acrescenta, corta e reescreve conteúdo, então sua razão mede a edição tanto quanto o tokenizador. O FLORES tem seu próprio limite: é prosa de notícia, guia de viagem e livro didático, não conversa de chat, código ou contrato.
Tokenizadores abertos, revisões fixadas e por que Claude e Gemini estão de fora
Cinco tokenizadores, todos baixáveis sem conta:
tiktoken 0.14.0:
cl100k_baseeo200k_base. O tiktoken associa GPT-4 e GPT-3.5 Turbo ao primeiro, e GPT-4o, o1, o3, GPT-4.1 e GPT-5 ao segundo.Qwen3 (
Qwen/Qwen3-8B) e DeepSeek-V3 (deepseek-ai/DeepSeek-V3), os dois BPE em nível de byte, carregados com a biblioteca tokenizers 0.23.2 da Hugging Face em revisões fixadas do Hub.bge-m3 (
BAAI/bge-m3), um modelo de embedding cujo tokenizador é um modelo Unigram do SentencePiece com o vocabulário do XLM-R, e não um BPE em nível de byte. Unigram é outro algoritmo: ele escolhe a divisão mais provável do texto a partir de um vocabulário fixo. Importa para recuperação, não para geração.
Cada frase foi codificada isoladamente, sem tokens especiais, e as contagens foram somadas. As medianas por frase contam a mesma história que os totais. O núcleo cabe em poucas linhas:
# after: tar -xzf flores200_dataset.tar.gz
import tiktoken
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer


def sentences(lang):
    with open(f"flores200_dataset/devtest/{lang}.devtest", encoding="utf-8") as f:
        return f.read().rstrip("\n").split("\n")


english, persian = sentences("eng_Latn"), sentences("pes_Arab")

o200k = tiktoken.get_encoding("o200k_base")
qwen3 = Tokenizer.from_file(
    hf_hub_download(
        "Qwen/Qwen3-8B",
        "tokenizer.json",
        revision="b968826d9c46dd6066d109eabc6255188de91218",
    )
)


def o200k_tokens(texts):
    return sum(len(o200k.encode_ordinary(t)) for t in texts)


def qwen3_tokens(texts):
    return sum(len(qwen3.encode(t, add_special_tokens=False).ids) for t in texts)


print(round(o200k_tokens(persian) / o200k_tokens(english), 2))
print(round(qwen3_tokens(persian) / qwen3_tokens(english), 2))
O registro da medição, suficiente para repetir a execução exatamente:
corpus: https://dl.fbaipublicfiles.com/nllb/flores200_dataset.tar.gz
sha256: b8b0b76783024b85797e5cc75064eb83fc5288b41e9654dabc7be6ae944011f6
split: devtest
measured: 2026-09-17
libraries:
  tiktoken: 0.14.0
  tokenizers: 0.23.2
  huggingface_hub: 1.31.0
encodings: [cl100k_base, o200k_base]
hub_revisions:
  Qwen/Qwen3-8B: b968826d9c46dd6066d109eabc6255188de91218
  deepseek-ai/DeepSeek-V3: e815299b0bcbac849fa540c768ef21845365c9eb
  BAAI/bge-m3: 5617a9f61b028005a4858fdac845db406aefb181
method: each sentence encoded on its own, no special tokens, counts summed per language
Claude e Gemini estão de fora de propósito. A Anthropic não publica o tokenizador do Claude, então qualquer razão que eu desse para o Claude seria um palpite com casa decimal. O Gen AI SDK da Google para Python traz um tokenizador local experimental, só de texto, que mapeia alguns modelos Gemini para tokenizadores Gemma abertos; não o medi. Os dois fornecedores contam os tokens para você. O endpoint count_tokens da Anthropic é gratuito, mas tem limite de requisições, e a documentação chama o resultado de “uma estimativa”; o count_tokens do Gemini conta a entrada. O Claude 4.7 e os modelos posteriores usam um tokenizador mais novo, no qual o mesmo texto de entrada produz “aproximadamente 30 por cento mais tokens que nos modelos anteriores”. Uma contagem de tokens pertence a um modelo, não a um fornecedor.
Limites que valem e um que não vale
Para tokenizadores BPE em nível de byte que dividem o texto em pré-tokens antes de fundir, como fazem os quatro daqui, dois limites emolduram a contagem. Os tokens não podem ser mais que os bytes do texto em UTF-8, tal como o tokenizador o normaliza, porque cada token cobre pelo menos um byte. E não podem ser menos que os pré-tokens do próprio tokenizador, os pedaços em que seu padrão de divisão corta o texto, porque os merges nunca atravessam a fronteira de um pré-token. Conferi os dois limites frase a frase nos quatro tokenizadores BPE em nível de byte e nos quatro idiomas: 16.192 verificações, 0 violações.
O playground de tokenizador deste site mostra os dois números para qualquer texto que você digitar, calculados no navegador: a divisão em pré-tokens do cl100k_base e os bytes do texto em UTF-8. Para o cl100k_base, a contagem verdadeira fica entre os dois, que é o que diz a legenda abaixo de cada painel.
O limite inferior pertence a um tokenizador só. A divisão do cl100k_base não é piso para o o200k_base: em 28 frases em inglês, o o200k_base precisou de menos tokens do que o cl100k_base produz pré-tokens. Nenhum dos dois limites vale para o modelo Unigram do bge-m3.
Como o imposto do token afeta preço, latência, contexto e rate limits
Preço
Os fornecedores de API cobram pelos tokens que um modelo processa e gera. Com o mesmo preço por token, o mesmo conteúdo em persa custa cerca de uma vez e meia o inglês no o200k_base, e mais de três vezes o inglês no cl100k_base. Quando tanto o prompt quanto a resposta estão em persa, o custo extra incide nos dois lados da conta.
Latência
Quem dita o ritmo são os tokens de saída. O guia de latência da OpenAI diz que “cortar 50% dos seus tokens de saída pode cortar ~50% da sua latência”. Enxugar o prompt importa muito menos: “cortar 50% do seu prompt pode resultar em apenas 1–5% de melhora de latência”. Uma resposta em persa que precisa de mais tokens que a equivalente em inglês demora mais para ser transmitida. Isso é orientação do fornecedor aplicada às razões acima, não uma medição minha de latência.
Janela de contexto
Uma janela fixa de tokens comporta menos persa. Dividindo pela razão, a mesma janela comporta em persa 31% do conteúdo que caberia em inglês no cl100k_base, 39% no Qwen3, 56% no DeepSeek-V3, 65% no o200k_base e 91% no bge-m3, neste corpus. A auditoria de Roy e colegas faz a mesma observação para o bengali, cujo prêmio de 1,56× no GPT-4o reduz “uma janela de contexto nominal de 128k tokens a uma capacidade efetiva de 82k tokens equivalentes em inglês”. Em um prompt de RAG, isso significa espaço para menos trechos recuperados.
Rate limits
Os rate limits também são contados em tokens. Os limites da API do Claude são “medidos em requisições por minuto (RPM), tokens de entrada por minuto (ITPM) e tokens de saída por minuto (OTPM)”. Sob um teto de tokens por minuto, uma carga que precisa de mais tokens por requisição, como o persa precisou em todos os tokenizadores medidos aqui, bate no limite depois de menos requisições. Na maioria dos modelos Claude, as leituras de cache não contam para o limite de entrada.
Normalização que economiza tokens e normalização que quebra a busca
Duas características do persa escrito parecem uma economia fácil de tokens. As duas são armadilhas.
O ZWNJ (نیمفاصله) é um caractere, não um espaço
O U+200C ZERO WIDTH NON-JOINER tem a categoria geral Cf no Unicode: um controle de formatação, não um espaço em branco. Ele impede que as letras dos dois lados se liguem, então میشود se lê como uma palavra só, com uma quebra visível. O arquivo em persa do FLORES o usa 1.739 vezes, em 735 de suas 1.012 frases.
Trocar cada ZWNJ por um espaço reduziu a contagem de tokens do persa em 1,59% no cl100k_base, 1,82% no o200k_base, 1,57% no Qwen3 e 8,08% no DeepSeek-V3; no bge-m3 nada mudou, 0,00%. O bge-m3 não se mexeu porque seu normalizador já mapeia o ZWNJ para um espaço: todas as 735 frases alteradas mantiveram os mesmos ids de token.
A economia é pequena em três tokenizadores, maior no DeepSeek-V3, e muda o texto: uma palavra vira duas, e o que você armazena, exibe ou cita de volta deixa de ser o que o autor escreveu. Mantenha o ZWNJ no texto armazenado e decida separadamente o que um comparador trata como igual. É exatamente o que este site faz: só a normalização usada dentro das comparações trata o ZWNJ como espaço.
Yeh e kaf árabes contra yeh e keheh persas
ARABIC LETTER YEH (U+064A) e ARABIC LETTER FARSI YEH (U+06CC) são caracteres diferentes, assim como ARABIC LETTER KAF (U+0643) e ARABIC LETTER KEHEH (U+06A9). No começo e no meio da palavra eles têm a mesma aparência; no fim da palavra, não. Uma comparação de strings sempre enxerga dois caracteres diferentes. Até o FLORES mistura os dois: o arquivo em persa tem 11 yeh árabes e 22 kaf árabes ao lado de 9.570 yeh persas e 2.957 keheh.
Reescrever cada yeh persa e cada keheh do arquivo em persa como yeh e kaf árabes aumentou a contagem de tokens em 2,20% no cl100k_base, 9,49% no o200k_base, 10,39% no DeepSeek-V3 e 11,95% no bge-m3; só no Qwen3 ela caiu, 7,48%. Uma reescrita que economiza tokens em um tokenizador custa tokens nos outros quatro.
O problema de verdade é o recall. Se o texto armazenado e as consultas usam code points diferentes, a correspondência exata e a lexical falham em silêncio. Este site normaliza o texto em persa na gravação: yeh e kaf árabes viram as formas persas, e o ZWNJ fica. Ele normaliza a consulta de busca da mesma forma. Sem isso, uma consulta digitada com yeh árabe procura um caractere que o índice não contém, e não devolve nada.
A regra geral é mais estreita: normalize só o texto em persa, porque em árabe o yeh e o kaf árabes são as letras corretas. O retriever deste site ainda não faz essa distinção; ele aplica a normalização do persa a conteúdo e perguntas em todos os idiomas, árabe incluído. O artigo sobre busca híbrida para RAG em persa explica essa lacuna e cobre o resto do lado da recuperação.
Algarismos persas
Escrever os algarismos ASCII como algarismos persas mudou a contagem de tokens entre 0,48% e 1,47%. Isso não é motivo para mudar o que o leitor vê.
Como reduzir o custo de tokens em persa: teste, não presuma
Teste cada um destes pontos no seu próprio tráfego antes de confiar nele.
Escolha o modelo com o seu próprio texto. Em frases idênticas, a razão do persa para o inglês foi de 1,10× a 3,26×.
Conte com o endpoint do fornecedor. Sobre Claude e Gemini, as razões medidas aqui não dizem nada.
Conte de novo quando o modelo mudar. Um tokenizador mais novo pode deslocar qualquer orçamento que você já tenha definido.
Dimensione chunks e orçamentos de contexto em tokens, por idioma. Um limite de caracteres calibrado no inglês comporta mais tokens em persa: de cerca de um sexto a mais no bge-m3 a cerca de três vezes e meia mais no
cl100k_base.Limite o tamanho da saída. Os tokens de saída puxam a latência e o custo. A Anthropic sugere pedir um número de frases ou de parágrafos em vez de um número de palavras.
Faça cache do contexto repetido e depois meça a taxa de acerto. Qualquer economia depende de quantas vezes o seu prefixo de fato se repete.
Trate um system prompt em inglês como hipótese. Ele gasta menos tokens, mas não tenho medição do que ele faz com as respostas em persa.
Não remova o ZWNJ nem troque as formas das letras para economizar tokens. A economia é pequena ou inconsistente; o estrago no texto e na correspondência não é.
Como fazer o orçamento de tokens em persa
Uma regra de caracteres por token é um palpite por tokenizador
No persa, os caracteres por token foram de 1,40 no cl100k_base a 3,68 no bge-m3, com o o200k_base em 3,01. No inglês, foram de 4,30 a 4,91. A documentação do Gemini, da Google, diz que “um token equivale a cerca de 4 caracteres” e põe isso ao lado de uma contagem de palavras em inglês: uma regra moldada pelo inglês, não uma afirmação sobre o persa.
Reservar um token a cada dois caracteres persas parece generoso. Este site fazia isso, e é por isso que testei a regra nessas frases: ela ficou abaixo da contagem verdadeira em todas as 1.012 frases em persa no cl100k_base e em 976 no Qwen3. Ela se sustentou no o200k_base e no bge-m3, e ficou curta em 6 frases no DeepSeek-V3. Uma regra segura em um tokenizador pode ser otimista no seguinte, então este site não roda mais nenhuma.
Um teto duro: a contagem de bytes
Para BPE em nível de byte, a contagem de bytes do texto, tal como o tokenizador o normaliza, é um teto duro, mas folgado. Numa escala de 0 na contagem de pré-tokens a 1 na contagem de bytes, o inglês ficou entre 0,015 e 0,017: quase todo pré-token do inglês, mais ou menos uma palavra, é um único token. O persa ficou em 0,07 no o200k_base e em 0,31 no cl100k_base: partido em pedaços, mas nem perto de virar bytes. Reservar bytes, portanto, reserva muito mais do que o necessário. Essa é a troca certa para um teto que ninguém pode ultrapassar, e a errada para uma previsão. Para Claude e Gemini, conte com os endpoints deles antes da chamada e registre o uso que eles reportam depois dela.
Reserve antes da chamada, registre depois
O assistente deste site separa essas duas tarefas. Antes de o modelo de linguagem ser chamado, ele soma uma estimativa da requisição (um limite superior para os tokens do prompt, mais o teto completo de saída) ao gasto já registrado do mês e compara o total com um limite mensal. Se o contador de gasto não puder ser lido, ele falha fechado. No limite, o modelo não é chamado, e o leitor recebe um aviso em vez de um erro. Depois da chamada, ele registra o uso que o fornecedor reporta. A estimativa decide apenas se uma requisição pode começar; o total corrente vem das contagens de tokens do fornecedor.
As duas metades têm limitações, em direções opostas. A estimativa prévia conta o prompt como seu comprimento em bytes UTF-8: o teto da seção acima, não uma previsão. Todo vocabulário que o assistente pode usar é um BPE em nível de byte, então esse teto vale para qualquer modelo com que ele esteja falando e para qualquer idioma em que o visitante escreva. Para o persa, isso reserva várias vezes o que o prompt vai custar de fato, retido por uma requisição e nunca registrado como gasto. Antes, ele contava o prompt com a regra fixa de dois caracteres por token testada acima, que ficou abaixo da contagem verdadeira em todas as 1.012 frases em persa no cl100k_base. Uma reserva pequena demais é um teto errado na única direção em que um teto nunca pode errar, e essa medição é o motivo da mudança: a docstring do estimador cita essa mesma execução sobre 1.012 frases. O total mensal, de um jeito ou de outro, é construído a partir do uso registrado, não da estimativa.
O registro tem de lidar com um silêncio. OpenAI e Anthropic reportam os tokens de saída depois do texto gerado, e a referência de streaming da OpenAI avisa que, se um stream for interrompido ou cancelado, “você pode não receber o chunk final de uso”. Um stream cortado cedo, por um guardrail de streaming ou por uma aba fechada, termina antes de o relatório chegar — e cada caractere que ele chegou a produzir está na fatura. Por isso o assistente guarda o texto enquanto ele é transmitido e, onde o fornecedor não reportou nada, preenche a lacuna com a mesma contagem de bytes, o que registra a mais em vez de a menos. Os números do próprio fornecedor prevalecem sempre que ele informou algum: um turno que termina registra exatamente o que foi medido, nunca uma aproximação disso. O artigo sobre guardrails contra alucinação em RAG mostra onde essa verificação fica entre as outras camadas do assistente.
O mesmo princípio vale para um produto. Na Booq, onde lidero a engenharia de IA, cada job mostra seu preço, ou a estimativa inicial, antes de rodar, e um job que falha devolve a cobrança automaticamente, como descreve o estudo de caso da Booq.
Perguntas frequentes
O persa custa mais tokens que o inglês nos modelos da OpenAI?
Sim. Nas mesmas frases do FLORES-200, o persa precisou de 1,53× a contagem do inglês no o200k_base (GPT-4o, GPT-4.1 e GPT-5 no mapa do tiktoken) e de 3,26× no cl100k_base (GPT-4). Seu próprio tráfego vai dar outra razão, então conte a sua.
Quantos tokens o persa consome no Claude ou no Gemini?
Esta medição não tem como dizer. A Anthropic não publica tokenizador para o Claude, e o Gen AI SDK da Google oferece uma contagem local experimental para alguns modelos Gemini, construída sobre tokenizadores Gemma abertos, que eu não medi. As razões acima não valem para nenhum dos dois fornecedores. Use o endpoint count_tokens da Anthropic ou o count_tokens do Gemini em requisições reais, e conte de novo quando trocar de modelo.
O árabe é mais barato que o persa?
Em quatro dos cinco tokenizadores medidos aqui, sim: no o200k_base, o árabe precisou de 1,38× a contagem do inglês, contra 1,53× do persa. No bge-m3 foi o contrário, 1,17× contra 1,10×, o que é consistente com os dados de treino do XLM-R terem muito mais persa que árabe.
Devo remover o ZWNJ ou trocar para as formas árabes das letras para economizar tokens?
Não. Trocar o ZWNJ por um espaço reduziu as contagens entre 1,57% e 8,08% nos tokenizadores em nível de byte e muda as palavras. As formas árabes das letras só economizaram tokens no Qwen3 e custaram de 2,20% a 11,95% a mais nos outros. Os dois quebram a correspondência exata, a menos que toda consulta mude do mesmo jeito.
Quantos caracteres tem um token em persa?
Depende do tokenizador: de 1,40 no cl100k_base a 3,68 no bge-m3 nesta medição, contra 4,30 a 4,91 no inglês. Uma regra fixa que é segura em um tokenizador pode contar de menos em outro. Este site aposentou a própria reserva de dois caracteres por token depois desta execução e passou a reservar a contagem de bytes, e é esse o conselho geral: reserve contra um teto ou contra a contagem do fornecedor, não contra uma regra de bolso.
Fontes
Repositório facebookresearch/flores: licenças e aviso de arquivamento
No Language Left Behind: Scaling Human-Centered Machine Translation (NLLB Team et al., 2022)
Language Model Tokenizers Introduce Unfairness Between Languages (Petrov et al., NeurIPS 2023)
Petrov et al., comprimentos de tokenização no FLORES-200 (tokenization_lengths.csv)
Petrov et al., script que une os splits dev e devtest do FLORES-200 (compute_tokenizations.py)
Tokenization Disparities as Infrastructure Bias (Teklehaymanot e Nejdl, 2025)
Unsupervised Cross-lingual Representation Learning at Scale (Conneau et al., XLM-R e CC-100)
Referência da API da OpenAI: Chat Completions streaming events
SDK Python do Google Gen AI: tokenizador local experimental (local_tokenizer.py)
Se você está planejando uma funcionalidade de LLM para usuários que falam persa, defina o escopo do seu projeto.