
Guardrails contra alucinação em RAG: um design em cinco camadas
Cinco guardrails que impedem um assistente RAG de inventar respostas: recusa antes da busca, piso de similaridade, prompt, trava de frases e regras de voz.
A geração aumentada por recuperação (RAG) não impede que um modelo invente respostas, e um contexto fraco pode deixá-lo mais confiante em vez de mais cauteloso. Os guardrails contra alucinação em RAG ficam, na maior parte, no código em volta do modelo. Monte-os como cinco camadas numa ordem fixa, como faz o assistente deste site:
Recuse, antes da recuperação, as perguntas que o assistente nunca deve responder.
Entregue ao modelo apenas evidências com as quais a resposta possa ser conferida: trechos que passem de um piso de similaridade ou, para perguntas sobre o trabalho como um todo, os próprios registros do site. Sem nenhum dos dois, recuse sem chamar o modelo.
Trate o prompt de sistema como a única camada que o modelo pode ignorar.
Libere a resposta frase a frase, só depois de verificações determinísticas.
Nunca deixe o assistente falar como a pessoa por trás dele.
Uma verificação de gastos antes da chamada do modelo completa o design.
Eu construí e mantenho este site, assistente incluído. Não publico nenhum número de acurácia para ele, e a seção sobre medição explica por quê.
Por que o RAG ainda alucina
Num sistema RAG, um retriever devolve trechos de um corpus e o modelo de linguagem escreve a resposta a partir deles. Uma alucinação é uma afirmação falsa ou sem respaldo entregue como se fosse verdadeira.
A recuperação estreita o que um modelo provavelmente vai dizer. Não o delimita.
A recuperação pode deixar o modelo mais confiante, não mais correto
Pesquisadores do Google separaram dois casos: o contexto recuperado é suficiente para responder à pergunta, ou não é. Ao resumir o artigo, apresentado no ICLR 2025, os autores são diretos: “embora o RAG em geral melhore o desempenho global, ele paradoxalmente reduz a capacidade do modelo de se abster de responder quando isso é apropriado”. Num dos exemplos, o Gemma passou de respostas incorretas em 10,2% das perguntas sem contexto para 66,1% com contexto insuficiente.
Saber quando não responder compensa: o método de geração seletiva proposto pelos autores aumentou a fração de respostas corretas, entre as vezes em que o modelo respondeu, em 2% a 10% para Gemini, GPT e Gemma.
Um retriever top-k devolve k trechos, haja ou não algum relevante. Se só o modelo julga se eles bastam, a decisão de se abster fica com o componente que, como esta pesquisa mostra, erra com frequência.
Modelos são recompensados por chutar
Kalai e colegas argumentam que “os modelos de linguagem alucinam porque os procedimentos de treinamento e avaliação recompensam o chute em vez do reconhecimento da incerteza”. Quando a correção não dá nenhum crédito por “não sei”, chutar aumenta a nota. Uma instrução para admitir incerteza vai contra esse incentivo. Ajuda. Não é um controle.
Ferramentas jurídicas comerciais alucinaram mesmo assim
Alguns fornecedores de pesquisa jurídica divulgaram o RAG como forma de “eliminar” alucinações. A primeira avaliação pré-registrada de ferramentas de pesquisa jurídica com IA concluiu que os produtos da LexisNexis e da Thomson Reuters alucinaram, cada um, de 17% a 33% das vezes. O que isso significa para produtos jurídicos está em alucinações de IA jurídica: o que construir.
As cinco camadas de guardrails em resumo
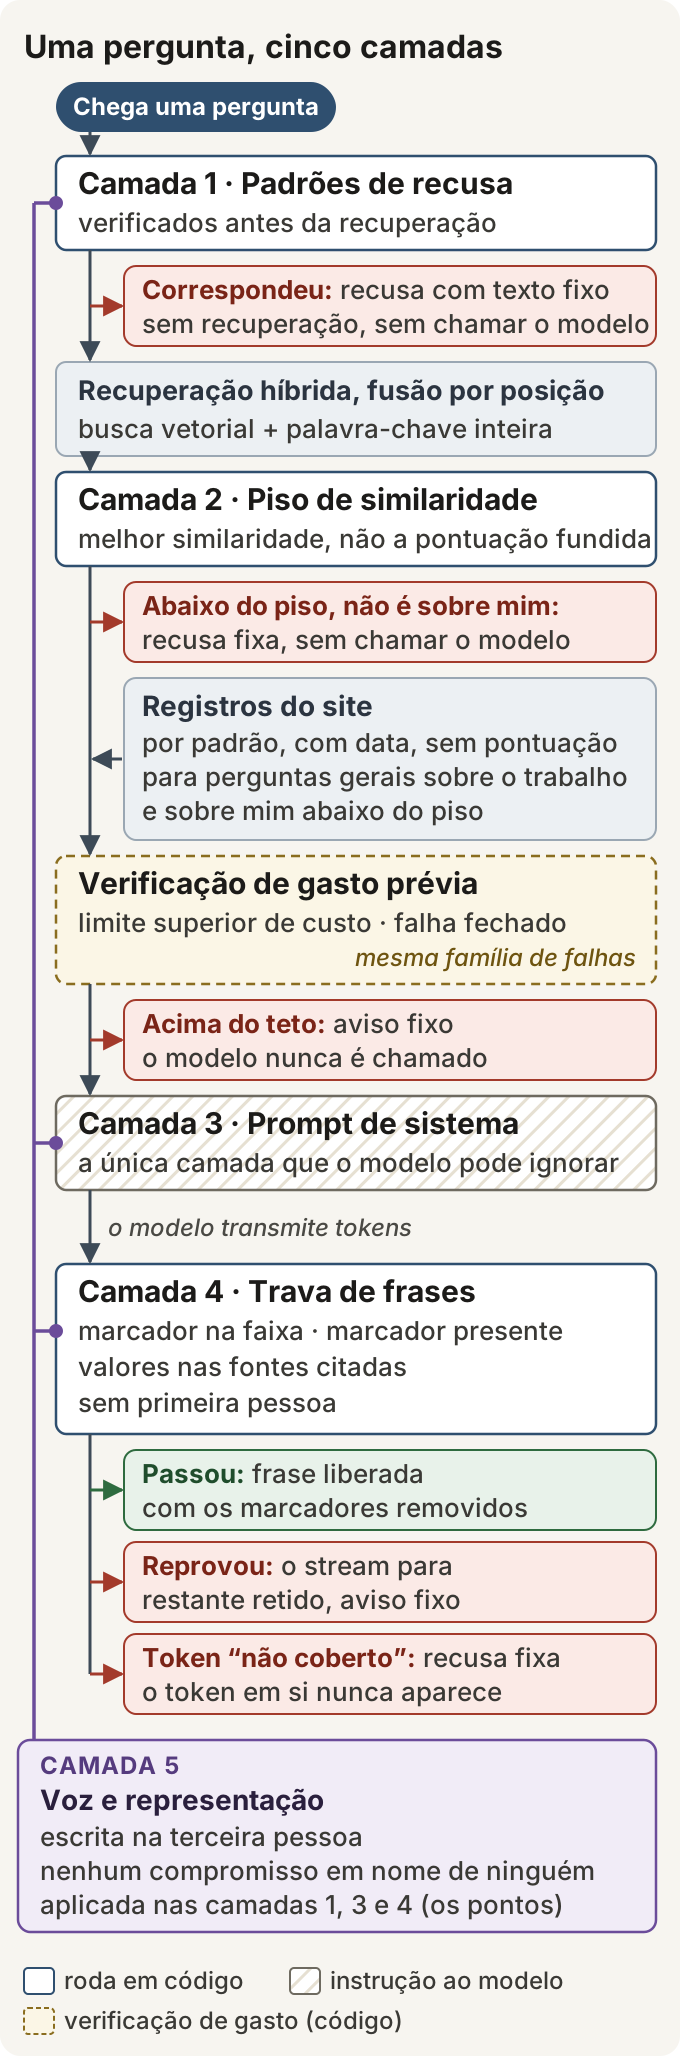
Camada | O que ela impede | Roda em | Quando dispara |
|---|---|---|---|
1. Padrões de recusa | Respostas que o assistente nunca deve dar | Código | Recusa com texto fixo, antes da recuperação |
2. Piso de similaridade | Respostas construídas sobre evidência fraca | Código | Recusa com texto fixo, sem chamar o modelo |
3. Prompt de sistema | Quebra de regra, quando o modelo colabora | No modelo | Nada o impõe por conta própria |
4. Trava de frases | Afirmações sem fonte, valores inventados, primeira pessoa | Código | O stream para e o restante é retido |
5. Regras de voz | Compromissos assumidos em nome de outra pessoa | Código e prompt | Pelas camadas 1, 3 e 4 |
A ordem importa tanto quanto as camadas. As duas camadas de recusa rodam antes de o modelo de linguagem ser chamado, e o prompt, a única camada que depende da colaboração do modelo, é seguido por uma verificação determinística. A verificação de gastos, entre o piso e o prompt, não impede que o modelo invente, mas pertence à mesma família de falhas.
Camada 1: recuse antes de recuperar
A primeira falha não é uma resposta que falta. É uma resposta que não deveria existir.
Perguntas que o seu corpus responde, mas o seu assistente não deve
Neste site, uma pergunta sobre honorários recuperaria a página de serviços. O texto é relevante, e responder a partir dele é exatamente o erro: qualquer valor, data ou compromisso que o modelo componha a partir dessa página é uma declaração que ninguém fez. Relevância não é permissão.
Por isso, algumas perguntas são recusadas antes que qualquer coisa seja transformada em embedding ou recuperada:
Condições comerciais: honorários, disponibilidade e contratação.
Dados privados que o site deliberadamente não publica, como telefone, endereço residencial, estado civil ou situação militar e data de nascimento.
Especulação: previsões e comparações com pessoas nomeadas.
Pedidos meta que tentam extrair ou anular as instruções.
Pedidos de tarefas: escrever código ou textos, traduzir ou resolver algo, em vez de perguntar sobre o trabalho publicado.
A recusa é texto fixo, não saída do modelo: uma recusa gerada pelo modelo é uma recusa da qual o próprio modelo consegue se convencer a sair. Os clientes do modelo de embedding (o modelo que transforma texto em vetores) e do modelo de linguagem são criados sob demanda, então uma recusa aqui não faz nenhuma chamada externa.
No seu sistema, faça a lista das perguntas cuja resposta correta é “este assistente não responde isso”, não importa o que o corpus contenha.
Padrões, não um classificador
O conjunto de recusas é uma lista de expressões regulares para inglês e persa e de listas de frases para os outros oito idiomas do site, todas aplicadas à pergunta depois de uma normalização de correspondência: maiúsculas e minúsculas unificadas, formas árabes das letras convertidas para as persas, dígitos persas e árabes convertidos para latinos, sinais vocálicos árabes removidos e o zero-width non-joiner dentro de palavras persas trocado por um espaço. A pergunta também é testada com o meu nome lido como pronome, de modo que “what are Mohammad Panahi’s rates?” é recusada como “what are his rates?”, e uma pergunta de acompanhamento é verificada junto com a anterior.
Não é um classificador. Um classificador que acerta na maioria das vezes ainda é uma promessa que este site não pode fazer, porque cada erro dele é um compromisso em nome de alguém.
O limite é claro: padrões não pegam paráfrases. A ortografia persa não é uma dessas lacunas. Como a normalização troca o zero-width non-joiner por um espaço, uma palavra que a ortografia padrão escreve unida chega aos padrões partida em duas, e cada padrão persa aceita tanto essa forma quanto a forma sem espaço, então چقدر میگیرد e چقدر میگیرد são as duas recusadas. Uma pergunta formulada com palavras que a lista não tem continua passando, e as camadas seguintes existem para isso: o prompt proíbe honorários e disponibilidade, e a trava interrompe uma frase que traga uma palavra de primeira pessoa que ela reconheça ou um número que as fontes não contenham. Isso estreita a lacuna. Não a fecha. As listas dos idiomas que não são inglês nem persa são mais curtas, e paráfrases nelas passam com mais frequência.
Camada 2: um piso de similaridade que dispensa a chamada ao modelo
Depois da recuperação, o assistente pega a melhor similaridade entre a pergunta e os trechos que entregaria ao modelo. Abaixo de um piso, uma pergunta que não é sobre mim é recusada com texto fixo e o modelo de linguagem nunca é chamado. A recusa não sai de graça, já que em produção uma API hospedada já transformou a pergunta em embedding, mas ela elimina a chamada de geração, de modo que evidência fraca nunca vira uma resposta fluente. Perguntas sobre mim seguem outro caminho, descrito mais abaixo, porque uma pontuação de similaridade não consegue distinguir uma pergunta ampla sobre o trabalho de alguém de uma pergunta fora de tema.
Por que não dá para colocar um limiar numa pontuação de reciprocal rank fusion
O retriever é híbrido: busca vetorial densa e busca por palavra-chave com correspondência de palavra inteira, fundidas por reciprocal rank fusion (RRF). Como isso se comporta com persa e inglês lado a lado está em busca híbrida para RAG em persa.
O RRF é um bom jeito de combinar rankings e um péssimo número para servir de limiar. Na formulação de Cormack, Clarke e Büttcher, a pontuação de um documento é a soma de 1/(k + r(d)) sobre os rankings, em que r(d) é a posição dele em cada lista e k = 60 “foi fixado durante uma investigação-piloto”. A pontuação é construída apenas com posições, então até um corpus de puro ruído produz um documento em primeiro lugar com a melhor pontuação fundida disponível. Um piso sobre esse número mede posição, não relevância.
O que o piso compara em vez disso
Todo retriever capaz de produzir uma similaridade limitada informa uma:
A busca vetorial informa a similaridade de cosseno, limitada ao intervalo de 0 a 1. O piso usa a similaridade com a pergunta como foi feita e, numa pergunta de acompanhamento, com a pergunta unida à anterior. Quando a pergunta de acompanhamento é formulada como uma posição numa lista, como “o segundo”, o item a que ela se refere também é unido a ela: a posição é lida na pergunta e a lista na resposta anterior, pelos títulos e nomes do próprio site ou pelo que a resposta cita entre aspas, e o modelo fica sabendo de qual item se trata. O item só é unido quando a posição e a lista podem ser lidas sem nenhuma dúvida; caso contrário, é o começo da resposta anterior que é unido a ela. O que se verifica é a formulação, não a resposta: uma pergunta de acompanhamento sem relação que por acaso diga “o segundo” também recebe o começo da resposta e pode passar do piso; o prompt e a trava continuam atrás dela. Quando uma pergunta é sobre mim, a recuperação também busca com o meu nome acrescentado. Isso ajuda a ordenar os trechos, mas nunca conta para o piso: um nome faz qualquer pergunta sobre mim parecer próxima do currículo, inclusive as que o site não sabe responder.
A busca por palavra-chave informa a cobertura: a fração das palavras de conteúdo da pergunta, de três caracteres ou mais (dois em chinês), encontradas como palavras inteiras no trecho. As stop words de cada idioma do site são removidas antes, e a cobertura só conta para o piso quando pelo menos duas palavras de conteúdo diferentes coincidem. Uma palavra só é coincidência. Numa pergunta de acompanhamento que só diz a qual item se refere, como “Fale mais sobre o segundo”, as palavras de conteúdo são as do título ou nome que o próprio site dá a esse item.
Cada trecho fica com o maior dos dois valores, e o piso é comparado com o melhor valor entre os trechos devolvidos; o trecho que define esse valor está sempre entre eles. A pontuação fundida só decide a ordem.
Palavra inteira faz diferença. Se a correspondência for por substring, “rede” é encontrado dentro de “parede”, e perguntas sem relação nenhuma passam a parecer evidência. Se o serviço de embedding estiver indisponível, a recuperação recorre só à busca por palavra-chave, e o piso continua valendo.
Perguntas que uma pontuação de similaridade não responde
“O que ele fez recentemente?” não tem vizinho mais próximo. A resposta é uma lista ordenada por data, e nenhum trecho é parecido com isso: no embedder deste site, essa pergunta pontuou abaixo de uma pergunta sobre a previsão do tempo. Por isso, perguntas sobre o trabalho como um todo são reconhecidas por padrões em cada um dos dez idiomas do site, como o conjunto de recusas. Isso cobre o que eu faço agora ou fiz recentemente, minha carreira, projetos, pesquisa, textos, formação, habilidades e serviços. Essas perguntas são respondidas com os registros do site: entradas do currículo, dos estudos de caso, dos artigos e dos serviços, lidas do banco de dados a cada pergunta. Os registros vêm no idioma do leitor quando existe uma tradução, e os que têm data são ordenados pelas próprias datas, dos mais recentes para os mais antigos.
Registros são escolhidos por regra, não por similaridade, então o piso não se aplica a eles. De nada mais estão isentos: os padrões de recusa rodam primeiro, todo registro com data traz suas datas com a precisão que o site mostra, e toda frase construída sobre um registro passa pela mesma trava.
Uma pergunta sobre mim que os padrões não encaminham aos registros, e que nenhum trecho sustenta, recebe um breve panorama desses registros em vez de uma recusa, porque uma recusa errada ali diria ao leitor que o site não cobre algo que cobre. Se os registros também não a respondem, o modelo tem instrução de responder com um token fixo em vez de prosa, e o leitor vê a mesma recusa fixa. Assim, o julgamento do modelo vira mais um caminho para a recusa. Ele nunca transforma uma recusa em resposta.
Como escolher um limiar de similaridade para RAG
Não existe um número portável. A similaridade de cosseno depende do modelo de embedding, da mistura de idiomas e do corpus, então um piso que serve para um modelo pode recusar tudo, ou nada, em outro.
O valor padrão de projeto neste site é 0,35, e a suíte de testes roda com esse valor um embedder substituto, um modelo que faz as vezes do real só nos testes. Ele ainda não foi calibrado contra o embedder de produção. Um comando que executa só a recuperação passa pelo embedder implantado as perguntas do golden set e as perguntas sugeridas do site, sem chamar o modelo, e o piso de produção só muda quando essa execução passa. Não é um valor para copiar. Para escolher o seu:
Rode, no embedder que você vai implantar, as perguntas que o assistente precisa responder e as que precisa recusar, e compare as duas distribuições de melhor similaridade.
Decida de quantas perguntas respondíveis você abre mão para barrar as que precisam ser recusadas. Onde uma resposta errada e confiante é pior do que nenhuma resposta, coloque o piso mais alto.
Registre a que embedder e a que corpus esse número pertence. Toda página acrescentada ao corpus muda o que uma pergunta fora de tema pode encontrar como correspondência, este artigo incluído.
A demo RAG vs. modelo bruto foi construída em torno dessa fronteira. Ela não tem nenhuma rota sem fundamentação: uma pergunta que não tem relação comigo, e que nenhum trecho sustenta, para antes de chegar ao modelo de linguagem.
Camada 3: o prompt de sistema é a única camada que um modelo pode ignorar
O prompt ainda faz trabalho de verdade. Ele manda o modelo usar apenas as fontes numeradas entregues junto com a pergunta, falar de mim na terceira pessoa e no idioma do leitor, nunca declarar disponibilidade, honorários ou prazos, nunca inventar nem calcular um número ou uma data, dizer “atualmente” só do que um registro marca como atual, terminar toda frase factual com um marcador de fonte e responder com um token fixo quando as fontes não cobrem a pergunta.
Ele não consegue impor nada disso. A entrada LLM07:2025 System Prompt Leakage da OWASP recomenda guardrails fora do modelo, porque um sistema independente que inspecione a saída “é preferível a instruções no prompt de sistema”. A orientação da Anthropic para reduzir alucinações, que inclui deixar o modelo dizer que não sabe, é igualmente franca: “embora essas técnicas reduzam significativamente as alucinações, elas não as eliminam por completo”.
Por isso o prompt é escrito partindo do princípio de que às vezes será ignorado. A função dele é tornar o cumprimento das regras o caminho mais fácil, e toda instrução de alto risco tem uma contraparte determinística:
Instrução do prompt | Contraparte determinística |
|---|---|
Um marcador de fonte em toda frase factual | A trava confere se o marcador existe e está dentro da faixa |
Nunca invente um número | Todo número, URL e e-mail precisa aparecer numa fonte que a frase cita |
Escreva na terceira pessoa | A verificação de primeira pessoa da trava |
Nada de honorários nem disponibilidade | Os padrões da camada 1 e, depois, as verificações de valor e de primeira pessoa da trava |
Uma instrução não tem contraparte completa: “use apenas o que as fontes dizem”, quando a afirmação não traz nenhum número. A trava consegue exigir um marcador válido nessa frase. Não consegue decidir se a fonte diz aquilo. As regras sobre datas também não têm. Uma frase que põe dois eventos datados na ordem errada, ou que chama um cargo antigo de recente, não traz nenhum valor para a trava conferir. Os registros reduzem esse risco porque chegam em ordem de data e com as entradas atuais marcadas; não o eliminam.
Camada 4: trave o stream uma frase por vez
Não dá para desdizer uma frase que o leitor já leu. A documentação do NeMo Guardrails, da NVIDIA, dá nome ao trade-off: com stream_first ativado, que é o padrão, “se um rail bloquear o conteúdo, o usuário já terá recebido os tokens”. Este site escolhe o outro lado. O texto é retido até a frase terminar, verificado e só então liberado, ao custo de cerca de uma frase de atraso.
Cada frase passa por quatro verificações, e cada uma é um fato sobre strings, não um julgamento sobre significado:
Marcador dentro da faixa: ele aponta para uma fonte que de fato foi entregue.
Marcador presente em toda frase substantiva; uma frase curta de ligação, sem valores, passa. O tamanho é contado em palavras separadas por espaços, exceto em chinês, que não os usa: nele, cada três caracteres contam como duas palavras.
Valores na evidência citada: todo número, URL e endereço de e-mail aparece numa fonte que a frase cita, com os dígitos persas e árabes convertidos para latinos.
Sem primeira pessoa, o que significaria que o assistente começou a falar como eu.
Em caso de violação, as frases já liberadas permanecem, a frase reprovada nunca é enviada e o stream para, o que também cancela a geração upstream. O leitor vê um texto fixo dizendo que o restante da resposta não pôde ser respaldado pelas fontes deste site e foi retido. Os marcadores são verificados e depois removidos, então o leitor vê texto corrido, não uma bibliografia, e uma resposta truncada recebe um aviso diferente: uma frase interrompida não é uma frase sem respaldo.
Ter respaldo não é ser verdade. Os valores são conferidos contra as fontes que a frase cita, não contra a afirmação: uma frase que cita duas fontes pode tirar um valor de qualquer uma delas, e uma frase sem valores passa com qualquer marcador dentro da faixa. A trava não consegue mostrar que uma afirmação está correta, nem sequer que o trecho citado a sustenta. A entrada LLM09:2025 Misinformation da OWASP pede que as equipes “validem automaticamente as saídas principais”; esta é uma versão restrita e determinística disso. A mecânica está em guardrails de LLM em streaming.
Camada 5: regras de voz e representação
Um assistente que fala por alguém assume compromissos por essa pessoa
No caso Moffatt v. Air Canada (2024 BCCRT 149), relatado por McCarthy Tétrault e Bristows, o Civil Resolution Tribunal da Colúmbia Britânica julgou o caso de um chatbot de companhia aérea que sugeriu a um cliente que ele poderia pedir retroativamente uma tarifa de luto. A posição da companhia, nas palavras do tribunal, sugeria que “o chatbot é uma entidade jurídica separada, responsável pelos próprios atos”. O tribunal discordou: “Não faz diferença se a informação vem de uma página estática ou de um chatbot”.
Isto é contexto de engenharia, não aconselhamento jurídico, e a decisão de um tribunal não é uma regra geral. A lição de engenharia é mais estreita: um assistente no seu site fala com a autoridade do seu site. Um valor de honorários ou uma data de início escritos na minha voz seriam uma declaração que eu nunca fiz. Uma resposta errada e confiante é pior do que nenhuma resposta; um compromisso errado e confiante é pior ainda.
Terceira pessoa, texto fixo de recusa e uma verificação de primeira pessoa
O assistente nunca é eu. Ele escreve sobre mim na terceira pessoa, e toda recusa e todo aviso são texto fixo. A regra de voz é aplicada em três pontos:
A camada 1 recusa perguntas sobre honorários, disponibilidade, contratação e dados privados antes da recuperação, em cada um dos idiomas do site.
A camada 3 proíbe a primeira pessoa e qualquer compromisso em meu nome.
A camada 4 interrompe o stream quando aparece uma palavra de primeira pessoa.
A verificação é mais fraca em persa. A lista de primeira pessoa em inglês cobre os pronomes. A lista em persa é curada, não exaustiva: o persa marca a pessoa nas terminações verbais, e uma regra ampla o bastante para pegar todas elas pegaria também palavras comuns terminadas do mesmo jeito. A lista tem os pronomes e alguns verbos de alto risco, como هستم e دارم, cada um nas duas formas que a normalização pode produzir: a verificação normaliza antes de separar as palavras, então میکنم chega a ela como dois tokens e میکنم como um. O que fica descoberto é o sufixo, não a grafia. Em persa, o peso recai mais sobre o prompt, e isso está escrito, não escondido. Para os outros idiomas do site, a lista traz os pronomes pessoais e possessivos de primeira pessoa e, em espanhol, português, russo, árabe e híndi, que costumam dizer “eu” só com o verbo, também alguns verbos em primeira pessoa. Em chinês, que não separa as palavras com espaços, a verificação procura 我 em qualquer ponto da frase, menos num composto de 自我, “auto-”, como 自我修正, “autocorreção”. Em árabe, uma palavra de primeira pessoa fica de fora de propósito, porque a normalização de letras que torna comparáveis as grafias persa e árabe a deixa idêntica a uma preposição comum.
Abuso de custo e denial of wallet: a mesma família de falhas
Uma alucinação é saída que ninguém autorizou. Uma fatura sem teto é gasto que ninguém autorizou. A OWASP classifica o segundo caso em LLM10:2025 Unbounded Consumption, que inclui o Denial of Wallet: os atacantes “exploram o modelo de cobrança por uso dos serviços de IA em nuvem, gerando encargos financeiros insustentáveis para o provedor”. Entre as mitigações estão limites de tamanho de entrada, rate limits e cotas por usuário, timeouts e throttling, e degradação controlada.
Um orçamento antes da chamada, não um alerta depois dela
Uma verificação feita depois da chamada do modelo já gastou o dinheiro. Neste site, uma verificação de gasto mensal roda depois do piso e antes da chamada do modelo. Ela soma o gasto acumulado a um limite superior do custo deste turno: o prompt inteiro contado a um token por byte em UTF-8, mais o teto completo de saída, incluindo a cota de raciocínio. É verificando contra o custo esperado que um teto acaba sendo estourado.
Se esse total ultrapassar o teto, nenhum modelo é chamado, e o leitor recebe um aviso fixo de que o limite mensal foi atingido, não uma mensagem de erro.
A contagem de bytes é um teto, não um palpite generoso. Qualquer vocabulário para o qual este endpoint possa apontar é um BPE em nível de byte e, num deles, um token é uma sequência não vazia de bytes, então nenhum texto consegue produzir mais tokens do que tem bytes, em qualquer idioma. A única forma de furar esse limite seria um tokenizador que expandisse o texto antes de dividi-lo, e nenhum deles faz isso. Esse limite substituiu uma regra fixa de dois caracteres por token, a regra que este site aposentou: o imposto de tokens do persa mediu essa regra ficando abaixo da contagem real em todas as frases em persa de um corpus paralelo no cl100k_base. O teto é folgado — para o persa, ele reserva várias vezes o que o prompt realmente custa — e é folgado na única direção em que um limite de gastos pode errar.
Restam dois limites. A verificação não é uma reserva: o gasto é lido e comparado, não retido, então requisições que chegam juntas podem passar todas e estourar o teto; os limites por IP estreitam essa janela sem fechá-la. E o contador não é um livro-caixa completo: ele guarda o custo das chamadas de modelo deste endpoint, então o embedding hospedado por trás de cada pergunta fica de fora, e uma escrita perdida enquanto o armazenamento do contador está indisponível nunca é refeita. O teto é um guardrail, não uma fatura.
Falhe fechado no gasto, falhe aberto no rate limit
Se o armazenamento do contador estiver indisponível, o gasto é desconhecido, e gasto desconhecido diante de um teto rígido tem uma única leitura segura: recusar como se o teto tivesse sido atingido.
O rate limiter, ao contrário, falha aberto, porque uma queda de cache não deve derrubar o site. O pior caso de um rate limit que falha aberto são algumas requisições a mais; o de um teto de gastos que falha aberto é uma fatura sem limite. São três limites por IP, que se renovam ao longo de um minuto, de uma hora e de um dia, chaveados pelo endereço que o proxy de borda observou, e não por um cabeçalho que o cliente possa escrever. Eles freiam os scripts; o teto mensal é a última barreira do gasto, não uma garantia.
Pare de pagar quando o leitor vai embora
Uma aba de navegador fechada não interrompe a requisição ao modelo upstream. O servidor verifica a desconexão dentro do loop de streaming e fecha o stream do provedor, o que cancela a requisição. A parada da trava faz o mesmo: ninguém deve pagar por frases que ninguém vai ver.
O que foi gerado antes da interrupção foi gerado assim mesmo, e continua na fatura, então o mês é cobrado por isso. Os dois protocolos de provedor informam o uso num evento final que um stream cortado nunca alcança, então o serviço guarda cada caractere que recebeu e preenche apenas as lacunas que o provedor deixou, a um token por byte em UTF-8. Onde o provedor informou, os números dele prevalecem: um turno que vai até o fim registra exatamente o que o provedor disse, não uma aproximação.
Como medir isso: acurácia de recusa, recall@k e fundamentação
Três propriedades importam. A acurácia de recusa mede se o assistente recusa o que precisa recusar. O recall@k mede se a evidência chega ao modelo. A fundamentação (groundedness) mede se a resposta fica dentro dessa evidência. Neste site, um golden set de perguntas nos dez idiomas do site, a maioria em inglês e em persa, é pontuado de forma determinística em toda execução de CI, sem nenhuma chamada de modelo.
Acurácia de recusa: dois conjuntos, sem crédito parcial
A recusa é avaliada em dois conjuntos, porque as duas camadas de recusa falham de formas diferentes. As recusas por padrão precisam ser pegas pela camada 1 antes de a recuperação rodar; as perguntas sem evidência, que não têm nada a ver com o site, precisam ficar abaixo do piso e não podem ser reconhecidas como perguntas sobre mim. Um terceiro conjunto verifica se as perguntas sobre o trabalho como um todo chegam aos registros do site.
Os dois conjuntos precisam de pontuação perfeita para o build passar. Uma recusa que escapa é um compromisso inventado no site de uma pessoa real, e uma média esconderia isso. A mesma execução verifica a falha oposta: perguntas respondíveis recusadas pelos padrões ou pelo piso. O FAQ sobre evals de Hamel Husain e Shreya Shankar prefere passa/não passa a escalas de nota porque “avaliações binárias forçam um raciocínio mais claro e uma rotulagem mais consistente”.
Não cito aqui as perguntas que precisam ser recusadas: este artigo vai entrar no corpus do assistente, e citá-las daria a essas perguntas exatas uma forte correspondência por palavra-chave nesta página.
Recall@k abaixo do k padrão
No golden set, o recall@k pergunta se pelo menos um trecho que responde à pergunta está entre os k primeiros, o que na prática o torna uma taxa de acerto. O texto da Anthropic sobre Contextual Retrieval usa a definição mais estrita, a fração de documentos relevantes recuperados, e reporta “1 menos recall@20” como medida de falha.
O golden set mede recall com k = 5, abaixo do top-k padrão de 8, porque, num corpus de teste de algumas dezenas de chunks, os oito primeiros são uma fatia grande de tudo o que existe ali, e medir nesse ponto favoreceria o retriever.
Fundamentação: aplicada por frase, não pontuada offline
Offline, a fundamentação costuma ser medida como faithfulness. A Ragas a define como as afirmações de uma resposta que o contexto recuperado sustenta, divididas por todas as afirmações dela, de 0 a 1; na forma padrão, um LLM identifica e confere as afirmações.
Juízes LLM são úteis e enviesados. Zheng e colegas encontraram “vieses de posição, de verbosidade e de autovalorização”, enquanto juízes fortes ainda assim chegaram a mais de 80% de concordância com as preferências humanas. Husain e Shankar recomendam validar as taxas de verdadeiro positivo e de verdadeiro negativo de um juiz num conjunto rotulado separado (held-out) e começar por verificações baratas em código sempre que uma regra puder decidir.
Este site segue o caminho do código: a trava aplica a fundamentação em tempo de execução, e nenhuma métrica de faithfulness nem juiz LLM roda no CI.
O que o meu golden set não prova
O embedder é um substituto. A recuperação no CI usa um modelo de hashing bag-of-tokens, sem nenhum significado aprendido. O roteamento, a fusão, a ordenação, a seleção do top-k e a decisão sobre a evidência, com a comparação com o piso, são o código de produção; só a pontuação dos candidatos, que em produção é feita no banco de dados, está espelhada no teste. Então o CI pega regressões na engrenagem de roteamento e ranqueamento, não na consulta ao banco de dados nem no recall do assistente em produção, e o substituto ainda aciona uma lista esparsa que a produção não usa.
Os conjuntos são pequenos. São vinte e uma recusas por padrão e onze perguntas sem evidência. “Precisa ser perfeito” em onze perguntas é uma proteção contra regressão, não uma taxa de recusa.
As verificações ao vivo são comandos, não jobs de CI. O teste que mandaria o golden set para o retriever implantado continua sendo pulado. Um comando que executa só a recuperação passa pelo embedder implantado as perguntas do golden set e as perguntas sugeridas, sem chamar o modelo, e um script rodado à mão depois de cada importação faz ao assistente ao vivo as perguntas que precisam ser recusadas.
Respostas a partir de registros só são conferidas pela trava. O CI verifica, contra uma fixture, quais perguntas chegam aos registros do site e quais registros elas recebem, com um substituto roteirizado no lugar do modelo. Como um modelo real redige uma resposta a partir deles é conferido em tempo de execução, pela trava.
Por isso não publico nenhum número de acurácia, de recusa ou de recall para o assistente: a execução automatizada usa um embedder substituto, as verificações ao vivo são pequenas e rodadas à mão, e este site não estima números que não mediu.
Estrutura em vez de confiança num assistente de contratos
Trabalhei como engenheiro de IA no Kartez Contract, um espaço de trabalho trilíngue para contratos que o cliente interrompeu a um mês da conclusão por problemas de financiamento ligados à guerra. Lá, manter o modelo ancorado foi resolvido com estrutura, não com confiança: as respostas usam apenas as cláusulas selecionadas, as correções precisam citar o texto existente palavra por palavra, as saídas seguem esquemas fixos e o modelo roda com baixa aleatoriedade ao redigir. São restrições de projeto, não uma garantia medida. O piso e a trava descritos acima pertencem ao assistente deste site, não ao Kartez. O estudo de caso do Kartez Contract cobre o projeto. Como esses padrões aparecem na IA para contratos, e por que o conjunto de avaliação vem antes de tudo, está em alucinações de IA jurídica: o que construir.
Checklist: guardrails para um assistente RAG em produção
Recuse pelos padrões primeiro. Rejeite perguntas sobre honorários, disponibilidade, dados privados e extração de instruções antes da recuperação.
Coloque o limiar numa similaridade, não numa pontuação de ranking. Cosseno aguenta um piso, e a cobertura por palavra inteira também, depois de removidas as stop words e desde que pelo menos duas palavras de conteúdo coincidam; uma pontuação de RRF não. Abaixo do piso, recuse com texto fixo e pule o modelo.
Responda perguntas de panorama com registros, não com similaridade. Uma lista ordenada por data não tem vizinho mais próximo.
Calibre o piso no embedder que você implanta. Um piso verificado num substituto é apenas um valor padrão.
Espelhe cada regra do prompt com uma verificação fora do modelo.
Trave o stream por frase. Exija um marcador, confira números, URLs e e-mails literalmente, retenha tudo a partir da frase reprovada e dê ao truncamento um aviso próprio.
Proíba a primeira pessoa em assistentes que falam sobre uma pessoa ou empresa, e documente onde a verificação é mais fraca.
Reserve um limite superior antes da chamada, não um palpite generoso. Para um BPE em nível de byte, a contagem de bytes UTF-8 do prompt é um desses limites. Faça a reserva de forma atômica, para que requisições simultâneas não passem todas, falhe fechado e cancele o trabalho upstream na desconexão.
Registre um custo para cada chamada, inclusive as cortadas no meio: guarde o texto conforme ele chega e preencha apenas o que o evento final de uso do provedor nunca informou.
Meça a recusa separadamente do recall. Informe qual embedder, o tamanho dos conjuntos e o que a execução não prova.
Perguntas frequentes
O RAG elimina as alucinações?
Não. As ferramentas de pesquisa jurídica baseadas em RAG da LexisNexis e da Thomson Reuters ainda alucinaram de 17% a 33% das vezes num estudo pré-registrado, e um contexto insuficiente pode deixar o modelo mais confiante em vez de mais cauteloso. A recuperação melhora as chances; as garantias vêm de verificações fora do modelo.
Qual limiar de similaridade um sistema RAG deve usar?
Não existe um número portável, porque as distribuições de similaridade dependem do modelo de embedding e do corpus. Coloque o limiar numa similaridade limitada, como o cosseno, nunca numa pontuação de reciprocal rank fusion, e defina o valor a partir de perguntas respondíveis e de perguntas que precisam ser recusadas, rodadas no embedder que você implanta. Um piso verificado só num substituto é um valor padrão, não uma calibração.
Um prompt de sistema basta para impedir alucinações?
Não. A OWASP recomenda evitar “usar prompts de sistema para controlar o comportamento do modelo sempre que possível” e apoiar-se, em vez disso, “em sistemas fora do LLM”, e a orientação da Anthropic diz que técnicas de prompt reduzem as alucinações sem eliminá-las. Mantenha o prompt e dê a toda instrução que importa uma verificação determinística fora do modelo.
Um juiz LLM pode substituir verificações determinísticas?
Não para regras que uma verificação de string consegue decidir, como se um marcador aponta para uma fonte real ou se um número aparece na evidência. Juízes apresentam vieses de posição, de verbosidade e de autovalorização. Use-os para as perguntas que o código não consegue responder, com rótulos binários e com o juiz validado contra rótulos humanos.
Como impedir que um chatbot LLM gere uma conta alta?
Antes da chamada do modelo, reserve de forma atômica um limite superior do custo dela — num tokenizador BPE em nível de byte, a contagem de bytes UTF-8 do prompt é um desses limites, em qualquer idioma — e recuse se o contador estiver indisponível. Registre um custo para cada chamada, inclusive as cortadas no meio, guardando o texto transmitido e preenchendo o que o evento final de uso do provedor nunca informou. Degrade para texto fixo em vez de dar erro e cancele a geração upstream quando o cliente desconectar. A OWASP lista esse risco como LLM10:2025 Unbounded Consumption, que inclui o Denial of Wallet.
Fontes
Se você está projetando um assistente que precisa recusar com a mesma confiabilidade com que responde, comece pelo Diagnóstico de projeto.