
Taxe token du persan : le coût des applications LLM non anglophones
Le persan a demandé 1,53× les tokens de l'anglais sur le tokenizer GPT-4o et 3,26× sur celui de GPT-4, sur 1 012 phrases parallèles. Méthode, résultats, tests.
À contenu égal, un texte en persan (farsi) coûte plus de tokens qu'un texte en anglais. Ce surcoût, c'est la taxe token du persan, et son ampleur dépend davantage du tokenizer que de l'écriture. J'ai compté les tokens des mêmes 1 012 phrases en anglais et en persan, tirées du benchmark FLORES-200. Le persan a demandé 1,53× le décompte anglais sur o200k_base, l'encodage que la bibliothèque tiktoken d'OpenAI associe à GPT-4o, et 3,26× sur cl100k_base, celui qu'elle associe à GPT-4. Ces deux valeurs sont les extrêmes parmi les quatre tokenizers qu'utilisent les modèles de génération de texte ; bge-m3, le tokenizer d'un modèle d'embedding, s'arrête à 1,10×. Claude et Gemini ne figurent pas dans cette mesure : Anthropic ne publie pas le tokenizer de Claude, et je n'ai pas testé le tokenizer local que le SDK de Google propose pour Gemini. Les deux fournisseurs comptent les tokens de leurs propres modèles via une API.
Ces chiffres sont un instantané daté : mesures du 17 septembre 2026, avec des versions de tokenizers figées.
Pourquoi le persan (farsi) consomme plus de tokens : octets, fusions et données d'entraînement
Les API de modèles de langage facturent au token. En 2023, Ahia et ses collègues ont relevé des indices selon lesquels « les locuteurs d'un grand nombre des langues prises en charge paient trop cher tout en obtenant de moins bons résultats ». Petrov et ses collègues ont montré que le même texte traduit dans différentes langues peut varier en longueur de tokenisation « jusqu'à 15 fois dans certains cas ». Une étude de 2025 portant sur plus de deux cents langues rapporte « souvent des ratios RTC 3 à 5 fois plus élevés » pour les langues à écriture non latine et à morphologie complexe, RTC étant le « Relative Tokenization Cost » des auteurs.
Voilà la taxe token : le même sens, une facture plus lourde.
Tout tokenizer au niveau octet part des octets
Un tokenizer BPE au niveau octet (BPE pour byte-pair encoding), le type de tokenizer derrière GPT-4o, Qwen3 et DeepSeek-V3, part des octets du texte encodé en UTF-8 et fusionne les séquences d'octets fréquentes en tokens. Une lettre latine sans accent occupe un octet ; les lettres du yoruba, avec leurs marques de ton et leurs points souscrits, en occupent deux ou plus. Une lettre persane en occupe deux, et le zero-width non-joiner employé à l'intérieur des mots persans en occupe trois. Dans FLORES, le fichier persan occupait 1,69× les octets du fichier anglais en UTF-8, pour 0,94× les caractères. Le persan n'est pas plus long en caractères. Il est plus lourd à encoder.
La suite dépend des fusions qu'un tokenizer a apprises de ses données d'entraînement. Passer de cl100k_base à o200k_base a réduit les tokens persans de 53,5 % et les tokens anglais de 1,1 %. Le vocabulaire plus récent a changé le persan, pas l'anglais.
Le yoruba, en écriture latine, paie davantage
Si l'écriture décidait de la taxe, les langues en écriture latine ne la paieraient presque pas. Un article d'atelier de Roy, Roy et Patel (accepté à un atelier d'IJCAI 2026, sur arXiv depuis août 2026) constate dans son audit que « le yoruba, bien qu'il utilise l'écriture latine, présente le surcoût de tokenisation GPT-4o le plus élevé », à 2,37×. Les auteurs évoquent les diacritiques et la couverture du vocabulaire. Dans cet article, le yoruba est une comparaison exploratoire : ses traductions ont été produites par traduction automatique puis inspectées manuellement, tandis que le bengali et le hindi sont les cas validés.
Ma mesure va dans le même sens. Le yoruba a coûté plus cher que le persan sur quatre des cinq tokenizers, et l'arabe a coûté moins cher que le persan sur quatre des cinq. L'exception arabe, c'est bge-m3, un modèle d'embedding bâti sur XLM-RoBERTa et son vocabulaire. XLM-R a été entraîné sur cent langues tirées de CC-100 : 13 259 millions de tokens de persan contre 2 869 millions d'arabe, et le yoruba n'en faisait pas partie. Cela concorde avec l'idée que la part dans les données d'entraînement pèse plus lourd que l'écriture. Cela ne le prouve pas.
Résultats : le persan, l'arabe et le yoruba face à l'anglais
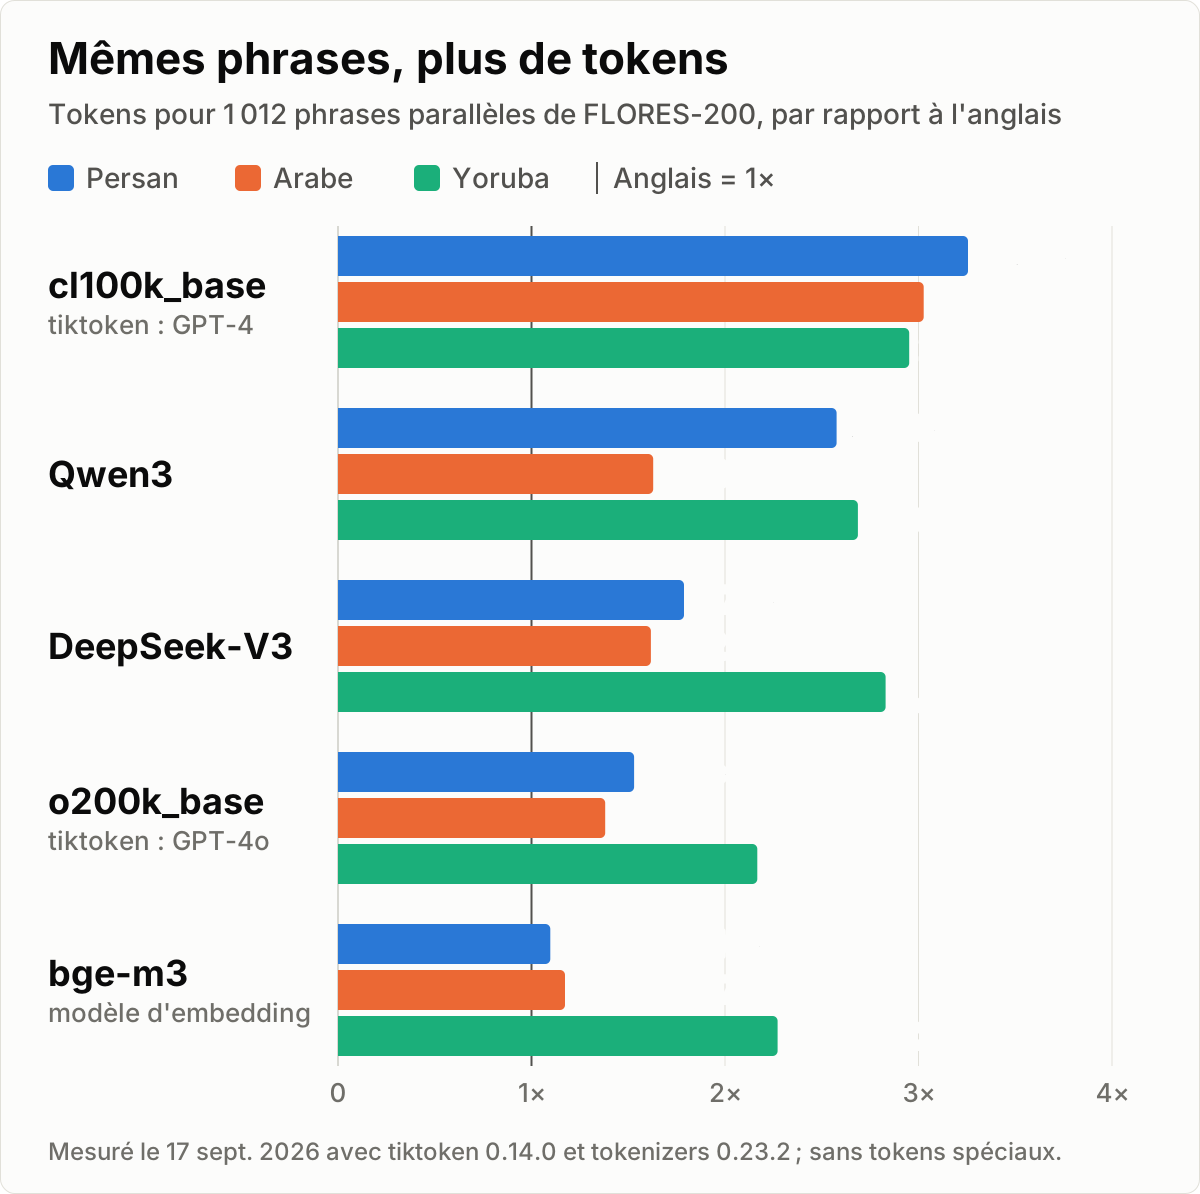
Chaque cellule est le total de tokens d'une langue divisé par le total anglais sur le même tokenizer :
Tokenizer | Persan (× anglais) | Arabe (× anglais) | Yoruba (× anglais) |
|---|---|---|---|
| 3,26× | 3,03× | 2,95× |
Qwen3 | 2,58× | 1,63× | 2,69× |
DeepSeek-V3 | 1,79× | 1,62× | 2,83× |
| 1,53× | 1,38× | 2,17× |
bge-m3 | 1,10× | 1,17× | 2,27× |
La plus grande variable, c'est le tokenizer. Le ratio du persan sur le pire tokenizer (3,26×) vaut environ trois fois son ratio sur le meilleur (1,10×), et environ le double même si l'on s'en tient aux quatre tokenizers utilisés pour la génération (3,26× contre 1,53×). Qwen3 traite l'arabe bien mieux que le persan, 1,63× contre 2,58× : un seul chiffre pour l'écriture arabe ne couvre donc pas les deux langues. Le résultat sur cl100k_base concorde avec des décomptes publiés plus tôt : les longueurs FLORES-200 de Petrov et ses collègues, splits dev et devtest réunis, situent le persan occidental à 3,28 fois l'anglais, contre mes 3,26× sur le seul split devtest.
Les totaux derrière ces ratios, avec la taille de chaque fichier de langue avant qu'un tokenizer ne l'ait touché :
Décompte | Anglais | Persan | Arabe | Yoruba |
|---|---|---|---|---|
Caractères | 131 966 | 123 830 | 116 320 | 126 848 |
Octets (UTF-8) | 132 096 | 223 504 | 211 276 | 168 857 |
Tokens, | 27 182 | 88 513 | 82 288 | 80 247 |
Tokens, Qwen3 | 27 621 | 71 183 | 44 991 | 74 226 |
Tokens, DeepSeek-V3 | 27 041 | 48 342 | 43 713 | 76 526 |
Tokens, | 26 873 | 41 116 | 37 117 | 58 238 |
Tokens, bge-m3 | 30 661 | 33 631 | 35 979 | 69 672 |
Votre corpus donnera un autre chiffre
L'audit de Roy et ses collègues a mesuré o200k_base sur 120 exercices de débogage Python traduits depuis l'anglais, avec une moyenne par exercice. Il rapporte 1,44× pour l'arabe et 2,37× pour le yoruba, à partir de traductions automatiques dans les deux cas. Sur la prose de FLORES, traduite par des humains, o200k_base a donné 1,38× pour l'arabe et 2,17× pour le yoruba. Même tokenizer, autre texte et autre procédé de traduction, autre résultat. Comptez vos propres prompts, vos passages récupérés et vos réponses avant d'établir un budget.
Comment j'ai mesuré le nombre de tokens du persan
Un corpus réellement parallèle
L'équipe NLLB décrit FLORES-200 comme « un benchmark traduit par des humains » : les mêmes phrases, dans le même ordre, dans chaque langue. J'ai utilisé son split devtest, sous licence CC BY-SA 4.0, depuis l'archive officielle, avec vérification de son empreinte SHA-256 : 1 012 phrases issues de Wikinews, Wikivoyage et Wikibooks, en anglais, persan occidental, arabe standard moderne et yoruba.
Le parallélisme compte plus que la taille. Une traduction adaptée, un CV bilingue par exemple, ajoute du contenu, en supprime et en reformule : son ratio mesure alors autant le travail de rédaction que le tokenizer. FLORES a sa propre limite : c'est de la prose de dépêches, de guides de voyage et de manuels, pas des conversations de chat, du code ni des contrats.
Tokenizers ouverts, révisions figées, et pourquoi Claude et Gemini sont absents
Cinq tokenizers, tous téléchargeables sans compte :
tiktoken 0.14.0 :
cl100k_baseeto200k_base. tiktoken associe GPT-4 et GPT-3.5 Turbo au premier, et GPT-4o, o1, o3, GPT-4.1 et GPT-5 au second.Qwen3 (
Qwen/Qwen3-8B) et DeepSeek-V3 (deepseek-ai/DeepSeek-V3), tous deux BPE au niveau octet, chargés avec la bibliothèque tokenizers 0.23.2 de Hugging Face, sur des révisions du Hub figées.bge-m3 (
BAAI/bge-m3), un modèle d'embedding dont le tokenizer est un modèle SentencePiece Unigram avec le vocabulaire de XLM-R, et non un BPE au niveau octet. Unigram est un autre algorithme : il choisit, dans un vocabulaire fixe, le découpage le plus probable du texte. Ce tokenizer compte pour le retrieval, pas pour la génération.
Chaque phrase a été encodée séparément, sans tokens spéciaux, puis les décomptes ont été additionnés. Les médianes par phrase racontent la même histoire que les totaux. Le cœur du code tient en quelques lignes :
# after: tar -xzf flores200_dataset.tar.gz
import tiktoken
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer


def sentences(lang):
    with open(f"flores200_dataset/devtest/{lang}.devtest", encoding="utf-8") as f:
        return f.read().rstrip("\n").split("\n")


english, persian = sentences("eng_Latn"), sentences("pes_Arab")

o200k = tiktoken.get_encoding("o200k_base")
qwen3 = Tokenizer.from_file(
    hf_hub_download(
        "Qwen/Qwen3-8B",
        "tokenizer.json",
        revision="b968826d9c46dd6066d109eabc6255188de91218",
    )
)


def o200k_tokens(texts):
    return sum(len(o200k.encode_ordinary(t)) for t in texts)


def qwen3_tokens(texts):
    return sum(len(qwen3.encode(t, add_special_tokens=False).ids) for t in texts)


print(round(o200k_tokens(persian) / o200k_tokens(english), 2))
print(round(qwen3_tokens(persian) / qwen3_tokens(english), 2))
Le relevé de mesure, suffisant pour reproduire la campagne à l'identique :
corpus: https://dl.fbaipublicfiles.com/nllb/flores200_dataset.tar.gz
sha256: b8b0b76783024b85797e5cc75064eb83fc5288b41e9654dabc7be6ae944011f6
split: devtest
measured: 2026-09-17
libraries:
  tiktoken: 0.14.0
  tokenizers: 0.23.2
  huggingface_hub: 1.31.0
encodings: [cl100k_base, o200k_base]
hub_revisions:
  Qwen/Qwen3-8B: b968826d9c46dd6066d109eabc6255188de91218
  deepseek-ai/DeepSeek-V3: e815299b0bcbac849fa540c768ef21845365c9eb
  BAAI/bge-m3: 5617a9f61b028005a4858fdac845db406aefb181
method: each sentence encoded on its own, no special tokens, counts summed per language
Claude et Gemini sont absents à dessein. Anthropic ne publie pas le tokenizer de Claude : tout ratio que je donnerais pour Claude serait une supposition assortie d'une décimale. Le SDK Gen AI de Google pour Python embarque un tokenizer local expérimental, limité au texte, qui associe certains modèles Gemini à des tokenizers Gemma ouverts ; je ne l'ai pas mesuré. Les deux fournisseurs comptent les tokens pour vous. L'endpoint count_tokens d'Anthropic est gratuit mais soumis à une limite de débit, et sa documentation qualifie le résultat d'« estimation » ; le count_tokens de Gemini compte l'entrée. Claude 4.7 et les modèles ultérieurs utilisent un tokenizer plus récent, sur lequel le même texte d'entrée produit « environ 30 pour cent de tokens de plus que sur les modèles antérieurs ». Un décompte de tokens appartient à un modèle, pas à un fournisseur.
Des bornes qui tiennent, et une qui ne tient pas
Pour les tokenizers BPE au niveau octet qui découpent le texte en pré-tokens avant de fusionner, comme le font les quatre tokenizers étudiés ici, deux limites encadrent le décompte. Les tokens ne peuvent pas être plus nombreux que les octets du texte en UTF-8, tel que le tokenizer le normalise, puisque chaque token couvre au moins un octet. Ils ne peuvent pas non plus être moins nombreux que les pré-tokens du tokenizer lui-même, les morceaux que son motif de découpage taille dans le texte, puisqu'une fusion ne franchit jamais une frontière de pré-token. J'ai vérifié les deux bornes phrase par phrase sur les quatre tokenizers BPE au niveau octet et sur les quatre langues : 16 192 vérifications, 0 violation.
Le bac à sable de tokenisation de ce site affiche les deux nombres pour n'importe quel texte que vous saisissez, calculés dans le navigateur : le découpage en pré-tokens de cl100k_base et les octets du texte en UTF-8. Pour cl100k_base, le décompte réel se situe entre les deux, et c'est exactement ce qu'indique la légende sous chaque panneau.
La borne inférieure appartient à un seul tokenizer. Le découpage de cl100k_base n'est pas un plancher pour o200k_base : sur 28 phrases anglaises, o200k_base a demandé moins de tokens que cl100k_base ne produit de pré-tokens. Aucune des deux bornes ne s'applique au modèle Unigram de bge-m3.
Ce que la taxe token change pour le prix, la latence, le contexte et les limites de débit
Prix
Les fournisseurs d'API facturent les tokens qu'un modèle traite et produit. À prix par token identique, le même contenu en persan coûte environ une fois et demie le prix de l'anglais sur o200k_base, et plus de trois fois sur cl100k_base. Quand le prompt et la réponse sont tous deux en persan, le surcoût s'applique aux deux côtés de la facture.
Latence
Ce sont les tokens de sortie qui donnent le tempo. Le guide de latence d'OpenAI indique que « réduire de 50 % vos tokens de sortie peut réduire votre latence de ~50 % ». Raccourcir le prompt pèse bien moins : « réduire de 50 % votre prompt peut n'apporter qu'une amélioration de latence de 1 à 5 % ». Une réponse en persan qui demande plus de tokens que son équivalent anglais met plus de temps à s'afficher en streaming. C'est une recommandation de fournisseur appliquée aux ratios ci-dessus, pas une mesure de latence de ma part.
Fenêtre de contexte
Une fenêtre de tokens fixe contient moins de persan. En divisant par le ratio, la même fenêtre contient, pour ce corpus, 31 % de contenu persan par rapport à l'anglais sur cl100k_base, 39 % sur Qwen3, 56 % sur DeepSeek-V3, 65 % sur o200k_base et 91 % sur bge-m3. L'audit de Roy et ses collègues fait le même constat pour le bengali, dont le surcoût de 1,56× sur GPT-4o réduit « une fenêtre de contexte nominale de 128k tokens à une capacité effective de 82k tokens en équivalent anglais ». Dans un prompt RAG, cela veut dire de la place pour moins de passages récupérés.
Limites de débit
Les limites de débit se comptent elles aussi en tokens. Les limites de l'API de Claude sont « mesurées en requêtes par minute (RPM), tokens d'entrée par minute (ITPM) et tokens de sortie par minute (OTPM) ». Sous un plafond de tokens par minute, une charge de travail qui demande plus de tokens par requête, comme le persan sur chacun des tokenizers mesurés ici, atteint la limite après moins de requêtes. Pour la plupart des modèles Claude, les lectures de cache ne comptent pas dans la limite d'entrée.
Une normalisation qui économise des tokens, une autre qui casse le rappel
Deux particularités du persan écrit ressemblent à des économies de tokens faciles. Les deux sont des pièges.
Le ZWNJ (نیمفاصله) est un caractère, pas une espace
U+200C ZERO WIDTH NON-JOINER a pour catégorie générale Unicode Cf, celle des caractères de contrôle de format, et non celle des espaces. Il empêche les lettres de part et d'autre de se lier, si bien que میشود se lit comme un seul mot avec une coupure visible. Le fichier persan de FLORES l'emploie 1 739 fois, dans 735 de ses 1 012 phrases.
Remplacer chaque ZWNJ par une espace a modifié le nombre de tokens persans de -1,59 % sur cl100k_base, de -1,82 % sur o200k_base, de -1,57 % sur Qwen3, de -8,08 % sur DeepSeek-V3 et de +0,00 % sur bge-m3. bge-m3 n'a pas bougé parce que son normaliseur convertit déjà le ZWNJ en espace : les 735 phrases modifiées ont conservé des identifiants de tokens identiques.
L'économie est faible sur trois tokenizers, plus nette sur DeepSeek-V3, et elle change le texte : un mot en devient deux, et ce que vous stockez, affichez ou citez n'est plus ce que l'auteur a écrit. Conservez le ZWNJ dans le texte stocké et décidez séparément de ce qu'un moteur de correspondance considère comme égal. Ce site fait exactement cela : seule la normalisation appliquée à l'intérieur des comparaisons traite le ZWNJ comme une espace.
Yeh et kaf arabes contre yeh et keheh persans
ARABIC LETTER YEH (U+064A) et ARABIC LETTER FARSI YEH (U+06CC) sont des caractères différents, tout comme ARABIC LETTER KAF (U+0643) et ARABIC LETTER KEHEH (U+06A9). En début et en milieu de mot, ils se ressemblent ; en fin de mot, ils diffèrent. Une comparaison de chaînes voit toujours deux caractères différents. FLORES lui-même les mélange : son fichier persan contient 11 yeh arabes et 22 kaf arabes à côté de 9 570 yeh farsi et 2 957 keheh.
Réécrire chaque yeh farsi et chaque keheh du fichier persan en yeh et kaf arabes a modifié le nombre de tokens de +2,20 % sur cl100k_base, de +9,49 % sur o200k_base, de -7,48 % sur Qwen3, de +10,39 % sur DeepSeek-V3 et de +11,95 % sur bge-m3. Une réécriture qui économise des tokens sur un tokenizer en coûte sur les quatre autres.
Le vrai problème, c'est le rappel. Si le texte stocké et les requêtes emploient des points de code différents, la correspondance exacte et la recherche lexicale échouent en silence. Ce site normalise le texte persan au moment de l'écriture : les yeh et kaf arabes deviennent leurs formes persanes, et le ZWNJ reste. Il normalise la requête de recherche de la même façon. Sans cela, une requête tapée avec un yeh arabe cherche un caractère que l'index ne contient pas, et ne renvoie rien.
La règle générale est plus étroite : ne normalisez que le texte persan, car en arabe, le yeh et le kaf arabes sont les lettres correctes. Le retriever de ce site ne fait pas encore cette distinction ; il applique la normalisation persane aux contenus et aux questions dans toutes les langues, l'arabe compris. L'article sur la recherche hybride pour le RAG en persan explique cette lacune et couvre le reste du volet retrieval.
Les chiffres persans
Écrire les chiffres ASCII en chiffres persans a modifié le nombre de tokens de +0,48 % à +1,47 %. Ce n'est pas une raison de changer ce que les lecteurs voient.
Comment réduire le coût en tokens du persan : tester, pas supposer
Testez chacun de ces points sur votre propre trafic avant de compter dessus.
Choisissez le modèle avec votre propre texte. Sur des phrases identiques, le ratio persan/anglais est allé de 1,10× à 3,26×.
Comptez avec l'endpoint du fournisseur. Pour Claude et Gemini, les ratios mesurés ici ne vous disent rien.
Recomptez quand le modèle change. Un tokenizer plus récent peut déplacer tous les budgets que vous avez fixés.
Dimensionnez les chunks et les budgets de contexte en tokens, langue par langue. Une limite en caractères calibrée sur l'anglais contient plus de tokens en persan : environ un sixième de plus sur bge-m3, et environ trois fois et demie plus sur
cl100k_base.Plafonnez la longueur des sorties. Les tokens de sortie pilotent la latence et le coût. Anthropic conseille de demander un nombre de phrases ou de paragraphes plutôt qu'un nombre de mots.
Mettez en cache le contexte répété, puis mesurez le taux de succès. Toute économie dépend de la fréquence réelle de répétition de votre préfixe.
Traitez un prompt système en anglais comme une hypothèse. Il coûte moins de tokens, mais je n'ai aucune mesure de son effet sur les réponses en persan.
Ne supprimez pas le ZWNJ et ne changez pas de formes de lettres pour économiser des tokens. Les économies sont faibles ou inconstantes ; les dégâts sur le texte et sur la correspondance ne le sont pas.
Comment budgéter les tokens du persan
Une règle « caractères par token » est une supposition propre à chaque tokenizer
Le persan est allé de 1,40 caractère par token sur cl100k_base à 3,68 sur bge-m3, avec o200k_base à 3,01. L'anglais est allé de 4,30 à 4,91. La documentation Gemini de Google affirme qu'« un token équivaut à environ 4 caractères » et associe cela à un nombre de mots anglais : une règle taillée pour l'anglais, pas une affirmation sur le persan.
Réserver un token pour deux caractères persans semble généreux. Ce site le faisait, et c'est pourquoi j'ai éprouvé la règle sur ces phrases : elle est passée sous le décompte réel pour les 1 012 phrases persanes sur cl100k_base et pour 976 sur Qwen3. Elle a tenu sur o200k_base et bge-m3, et s'est révélée insuffisante pour 6 phrases sur DeepSeek-V3. Une règle sûre sur un tokenizer peut être optimiste sur le suivant : ce site n'en applique donc plus.
Un plafond dur : le nombre d'octets
Pour un BPE au niveau octet, le nombre d'octets du texte, tel que le tokenizer le normalise, est un plafond dur, mais large. Sur une échelle allant de 0 au nombre de pré-tokens à 1 au nombre d'octets, l'anglais se situait entre 0,015 et 0,017 : presque chaque pré-token anglais, en gros un mot, est un token unique. Le persan se situait à 0,07 sur o200k_base et à 0,31 sur cl100k_base : découpé en morceaux, mais loin d'être découpé en octets. Réserver les octets revient donc à réserver beaucoup trop. C'est le bon compromis pour un plafond que personne ne doit franchir, et le mauvais pour une prévision. Pour Claude et Gemini, comptez avec leurs endpoints avant l'appel et enregistrez après coup la consommation qu'ils rapportent.
Réserver avant l'appel, enregistrer après
L'assistant de ce site sépare ces deux tâches. Avant l'appel au modèle de langage, il ajoute une estimation de la requête (une borne supérieure du nombre de tokens du prompt, plus la totalité du plafond de sortie) à la dépense enregistrée du mois et compare le total à une limite mensuelle. Si le compteur de dépense ne peut pas être lu, il échoue en mode fermé. Une fois la limite atteinte, le modèle n'est pas appelé, et le lecteur reçoit un avis plutôt qu'une erreur. Après l'appel, il enregistre la consommation que le fournisseur rapporte. L'estimation décide seulement si une requête a le droit de démarrer ; le cumul, lui, vient des décomptes de tokens du fournisseur.
Les deux moitiés ont leurs limites, en sens inverse. L'estimation préalable compte le prompt pour sa longueur en octets UTF-8 : le plafond de la section précédente, pas une prévision. Tous les vocabulaires que l'assistant peut être amené à utiliser sont des BPE au niveau octet, donc ce plafond tient quel que soit le modèle auquel il parle et quelle que soit la langue dans laquelle écrit le visiteur. Pour le persan, cela réserve plusieurs fois ce que le prompt coûtera réellement, un montant retenu le temps d'une requête et jamais enregistré comme dépense. Auparavant, il comptait le prompt avec la règle forfaitaire de deux caractères par token éprouvée plus haut, qui est passée sous le décompte réel sur les 1 012 phrases persanes avec cl100k_base. Une réservation trop petite est un plafond faux dans la seule direction où un plafond ne doit jamais l'être : cette mesure est donc la raison du changement, et la docstring de l'estimateur cite cette même campagne de 1 012 phrases. Dans les deux cas, le total mensuel se construit à partir de la consommation enregistrée, pas de l'estimation.
L'enregistrement doit composer avec un silence. OpenAI et Anthropic rapportent tous deux les tokens de sortie après le texte généré, et la référence streaming d'OpenAI prévient que si un flux est interrompu ou annulé, « il se peut que vous ne receviez pas le dernier chunk d'usage ». Un flux coupé tôt, par un garde-fou en streaming ou par un onglet fermé, se termine avant l'arrivée du rapport — et chaque caractère qu'il a bel et bien produit figure sur la facture. L'assistant conserve donc le texte au fil du streaming et, là où le fournisseur n'a rien rapporté, il comble le trou avec ce même nombre d'octets, ce qui enregistre trop plutôt que trop peu. Les chiffres du fournisseur l'emportent partout où il en a donné : un tour de conversation qui va jusqu'au bout enregistre exactement ce qui a été mesuré, jamais une approximation. L'article sur les garde-fous contre les hallucinations du RAG montre où cette vérification se place parmi les autres couches de l'assistant.
Le même principe vaut pour un produit. Chez Booq, où je dirige l'ingénierie IA, chaque job affiche son prix, ou son estimation de départ, avant de s'exécuter, et un job en échec restitue automatiquement son montant, comme le décrit l'étude de cas Booq.
Questions fréquentes
Le persan coûte-t-il plus de tokens que l'anglais sur les modèles OpenAI ?
Oui. Sur les mêmes phrases de FLORES-200, le persan a demandé 1,53× le décompte anglais sur o200k_base (GPT-4o, GPT-4.1 et GPT-5 dans la table de tiktoken) et 3,26× sur cl100k_base (GPT-4). Votre propre trafic donnera un autre ratio : comptez-le.
Combien de tokens le persan consomme-t-il sur Claude ou Gemini ?
Cette mesure ne peut pas le dire. Anthropic ne publie aucun tokenizer pour Claude, et le SDK Gen AI de Google propose, pour certains modèles Gemini, un décompte local expérimental bâti sur des tokenizers Gemma ouverts, que je n'ai pas mesuré. Les ratios ci-dessus ne se transposent à aucun des deux fournisseurs. Utilisez l'endpoint count_tokens d'Anthropic ou le count_tokens de Gemini sur de vraies requêtes, et recomptez quand vous changez de modèle.
L'arabe est-il moins cher que le persan ?
Sur quatre des cinq tokenizers mesurés ici, oui : sur o200k_base, l'arabe a demandé 1,38× le décompte anglais, contre 1,53× pour le persan. Sur bge-m3, c'était l'inverse, 1,17× contre 1,10×, ce qui concorde avec des données d'entraînement de XLM-R contenant bien plus de persan que d'arabe.
Faut-il supprimer le ZWNJ ou passer aux formes de lettres arabes pour économiser des tokens ?
Non. Remplacer le ZWNJ par une espace a modifié les décomptes de -1,57 % à -8,08 % sur les tokenizers au niveau octet, et change les mots. Les formes de lettres arabes n'ont économisé des tokens que sur Qwen3 et ont coûté de +2,20 % à +11,95 % ailleurs. Les deux cassent la correspondance exacte, sauf à modifier chaque requête de la même façon.
Combien de caractères fait un token persan ?
Cela dépend du tokenizer : de 1,40 sur cl100k_base à 3,68 sur bge-m3 dans cette mesure, contre 4,30 à 4,91 pour l'anglais. Une règle forfaitaire sûre sur un tokenizer peut sous-estimer sur un autre. Ce site a retiré sa propre réservation de deux caractères par token après cette campagne et réserve désormais le nombre d'octets ; c'est aussi le conseil général : réservez sur la base d'un plafond ou d'un décompte du fournisseur, pas d'une règle empirique.
Sources
Dépôt facebookresearch/flores : licences et avis d'archivage
No Language Left Behind: Scaling Human-Centered Machine Translation (NLLB Team et al., 2022)
Language Model Tokenizers Introduce Unfairness Between Languages (Petrov et al., NeurIPS 2023)
Petrov et al., longueurs de tokenisation sur FLORES-200 (tokenization_lengths.csv)
Petrov et al., script qui réunit les splits dev et devtest de FLORES-200 (compute_tokenizations.py)
Tokenization Disparities as Infrastructure Bias (Teklehaymanot et Nejdl, 2025)
Unsupervised Cross-lingual Representation Learning at Scale (Conneau et al., XLM-R et CC-100)
tiktoken, table de correspondance modèle-encodage (openai/tiktoken)
Référence de l'API OpenAI : Chat Completions streaming events
SDK Google Gen AI pour Python : tokenizer local expérimental (local_tokenizer.py)
Si vous préparez une fonctionnalité LLM pour des utilisateurs persanophones, cadrez votre projet.