
Garde-fous contre les hallucinations en RAG : une conception en cinq couches
Cinq garde-fous contre les hallucinations en RAG : refus avant récupération, seuil de similarité, prompt système, sas par phrase et règles de voix.
La génération augmentée par récupération (RAG) n’empêche pas un modèle d’inventer des réponses, et un contexte faible peut le rendre plus sûr de lui plutôt que plus prudent. Les garde-fous contre les hallucinations en RAG relèvent surtout du code qui entoure le modèle. Construisez-les en cinq couches, dans un ordre fixe, comme le fait l’assistant de ce site :
Refusez, avant toute récupération, les questions auxquelles l’assistant ne doit jamais répondre.
Ne donnez au modèle que des preuves auxquelles sa réponse peut être confrontée : des passages qui franchissent un seuil de similarité ou, pour les questions sur l’ensemble du travail, les propres fiches du site. Sans l’un ni l’autre, refusez sans l’appeler.
Traitez le prompt système comme la seule couche que le modèle peut ignorer.
Ne diffusez la réponse que phrase par phrase, après des vérifications déterministes.
Ne laissez jamais l’assistant parler à la place de la personne qui se trouve derrière lui.
Une vérification de la dépense avant l’appel au modèle complète la conception.
J’ai construit ce site et je le maintiens, assistant compris. Je ne publie aucun chiffre de précision le concernant, et la section sur la mesure explique pourquoi.
Pourquoi le RAG hallucine encore
Dans un système RAG, un retriever renvoie des passages tirés d’un corpus et le modèle de langue rédige sa réponse à partir d’eux. Une hallucination est une affirmation fausse ou non étayée, présentée comme si elle était vraie.
La récupération restreint ce qu’un modèle est susceptible de dire. Elle ne le borne pas.
La récupération rend parfois le modèle plus sûr de lui, pas plus juste
Des chercheurs de Google ont séparé deux cas : un contexte récupéré suffisant pour répondre à la question, et un contexte qui ne l’est pas. En résumant leur article, présenté à ICLR 2025, les auteurs sont directs : « si le RAG améliore généralement les performances globales, il réduit paradoxalement la capacité du modèle à s’abstenir de répondre lorsque cela s’impose ». Dans un exemple, Gemma passe de réponses incorrectes sur 10,2 % des questions sans aucun contexte à 66,1 % avec un contexte insuffisant.
Savoir quand ne pas répondre rapporte : la méthode de génération sélective des auteurs a augmenté la part de réponses correctes, parmi les fois où le modèle répond, de 2 à 10 % pour Gemini, GPT et Gemma.
Un retriever top-k renvoie k passages, pertinents ou non. Si c’est au modèle seul de décider si ces passages suffisent, l’abstention repose sur le composant dont ces travaux montrent qu’il se trompe souvent.
Les modèles sont récompensés quand ils devinent
Kalai et ses collègues soutiennent que « les modèles de langue hallucinent parce que les procédures d’entraînement et d’évaluation récompensent le fait de deviner plutôt que la reconnaissance de l’incertitude ». Quand un barème n’accorde aucun point à « je ne sais pas », deviner fait monter la note. Une consigne demandant d’admettre l’incertitude va à l’encontre de cette incitation. Elle aide. Ce n’est pas un contrôle.
Les outils juridiques commerciaux ont quand même halluciné
Certains fournisseurs d’outils de recherche juridique ont présenté le RAG comme « éliminant » les hallucinations. La première évaluation préenregistrée d’outils de recherche juridique par IA a constaté que les produits de LexisNexis et de Thomson Reuters ont chacun halluciné dans 17 % à 33 % des cas. Ce que cela implique pour les produits juridiques fait l’objet de que construire face aux hallucinations de l’IA juridique.
Les cinq couches en un coup d’œil
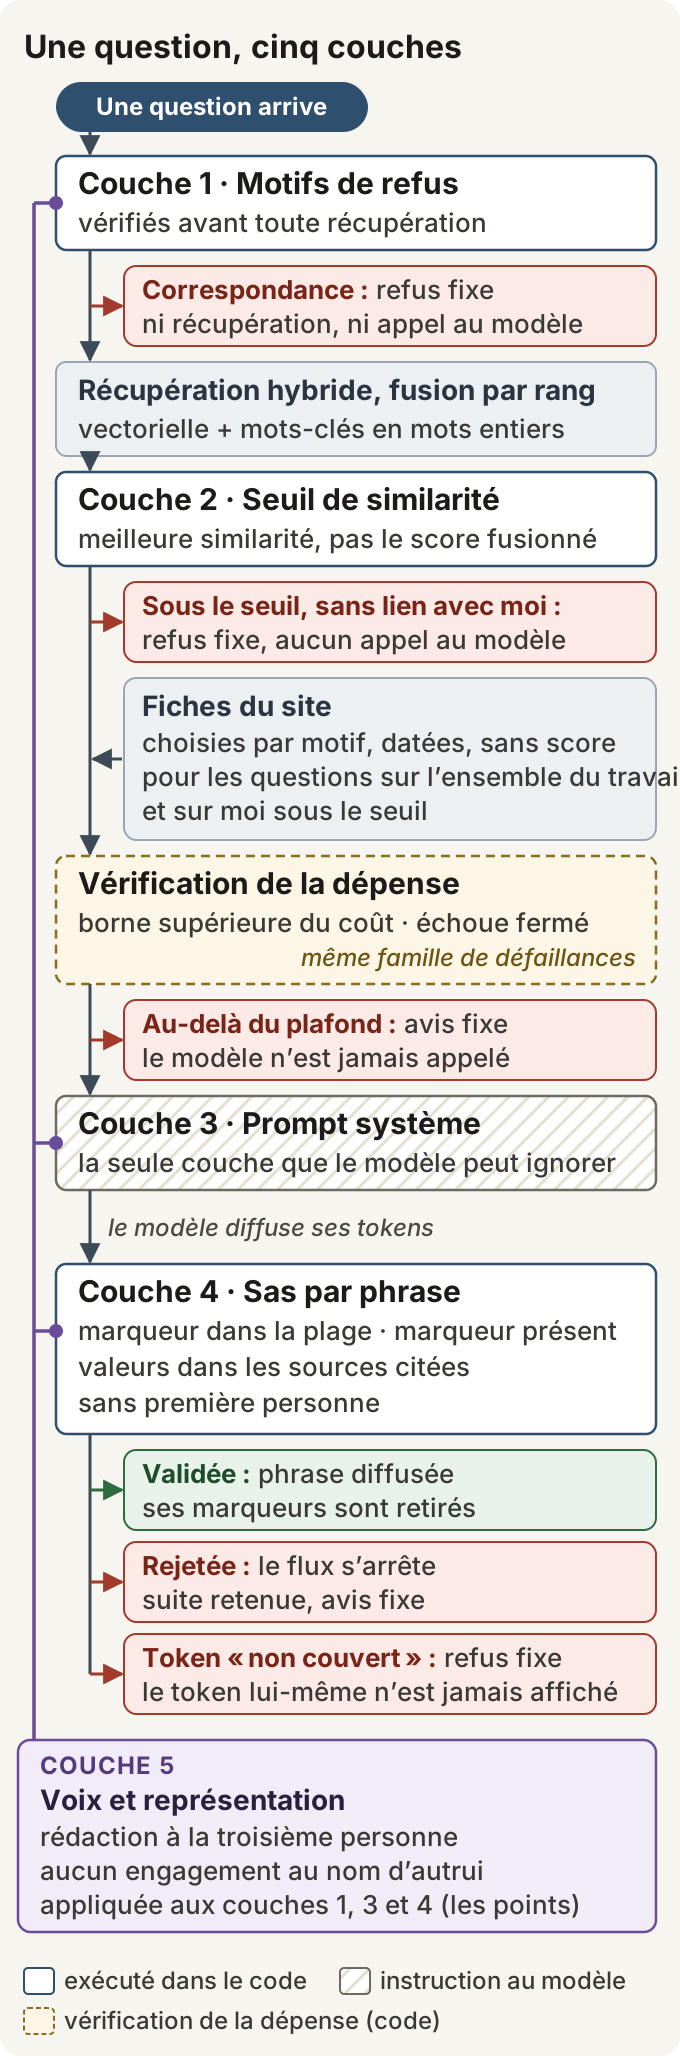
Couche | Ce qu’elle arrête | S’exécute dans | Quand elle se déclenche |
|---|---|---|---|
1. Motifs de refus | Réponses que l’assistant ne doit jamais donner | Le code | Refus en texte fixe, avant la récupération |
2. Seuil de similarité | Réponses fondées sur une preuve faible | Le code | Refus en texte fixe, sans appel au modèle |
3. Prompt système | Entorses aux règles, quand le modèle coopère | Le modèle | Rien ne l’impose à lui seul |
4. Sas par phrase | Affirmations sans source, valeurs inventées, première personne | Le code | Le flux s’arrête, la suite est retenue |
5. Règles de voix | Engagements pris au nom d’autrui | Le code et le prompt | Par les couches 1, 3 et 4 |
L’ordre compte autant que les couches. Les deux couches de refus s’exécutent avant tout appel au modèle de langue, et le prompt, seule couche qui dépende de la coopération du modèle, est suivi d’une vérification déterministe. La vérification de la dépense, placée entre le seuil et le prompt, n’empêche pas la fabrication de réponses, mais elle relève de la même famille de défaillances.
Couche 1 : refuser avant de récupérer
La première défaillance n’est pas une réponse manquante. C’est une réponse qui ne devrait pas exister.
Les questions auxquelles votre corpus peut répondre, mais pas votre assistant
Sur ce site, une question sur les honoraires ferait remonter la page Services. Le texte est pertinent, et y répondre est précisément l’erreur : tout chiffre, toute date, tout engagement que le modèle composerait à partir de cette page serait une déclaration que personne n’a faite. Pertinent ne veut pas dire autorisé.
Certaines questions sont donc écartées avant le moindre calcul d’embedding et la moindre récupération :
Conditions de collaboration : honoraires, disponibilité et recrutement.
Informations privées que le site choisit délibérément de ne pas publier : numéro de téléphone, adresse personnelle, situation familiale ou militaire, date de naissance.
Spéculation : prédictions et comparaisons avec des personnes nommément citées.
Requêtes méta qui cherchent à extraire les instructions ou à les outrepasser.
Demandes de tâches : écrire du code ou un texte, traduire ou résoudre quelque chose, plutôt que de poser une question sur les travaux publiés.
Le refus est un texte fixe, pas une sortie du modèle : un refus rédigé par le modèle est un refus dont le modèle peut se dédire. Les clients du modèle d’embedding (celui qui transforme le texte en vecteurs) et du modèle de langue ne sont construits qu’à la demande : un refus à ce niveau ne déclenche donc aucun appel externe.
Pour votre propre système, dressez la liste des questions dont la bonne réponse est « pas par cet assistant », quel que soit le contenu du corpus.
Des motifs, pas un classifieur
L’ensemble de refus est une liste d’expressions régulières pour l’anglais et le persan, et de listes de locutions pour les huit autres langues du site, toutes appliquées à une forme normalisée de la question : casse normalisée, formes arabes des lettres ramenées à leurs formes persanes, chiffres persans et arabes convertis en chiffres latins, voyelles brèves arabes supprimées, et antiliant sans chasse (ZWNJ) à l’intérieur des mots persans remplacé par une espace. La question est aussi essayée en lisant mon nom comme un pronom, si bien que « what are Mohammad Panahi’s rates? » est refusée comme « what are his rates? », et une question de relance est vérifiée avec la question qui la précède.
Ce n’est pas un classifieur. Un classifieur qui a raison la plupart du temps reste une promesse que ce site ne peut pas tenir, parce que ses ratés sont des engagements au nom de quelqu’un.
La limite est claire : les motifs passent à côté des paraphrases. L’orthographe persane, en revanche, n’est pas l’une de ces failles. Comme la normalisation transforme l’antiliant sans chasse en espace, un mot que l’orthographe standard écrit lié arrive scindé en deux devant les motifs, et chaque motif persan accepte aussi bien cette forme que la forme sans espace : چقدر میگیرد comme چقدر میگیرد sont refusés. Une question formulée avec des mots absents de la liste passe malgré tout, et les couches suivantes sont là pour cela : le prompt interdit les tarifs et la disponibilité, et le sas arrête une phrase qui contient un mot à la première personne qu’il reconnaît ou un chiffre absent des sources. L’écart se resserre. Il ne se referme pas. Les listes des langues autres que l’anglais et le persan sont plus courtes, et les paraphrases y passent plus souvent.
Couche 2 : un seuil de similarité qui évite l’appel au modèle
Après la récupération, l’assistant retient la meilleure similarité entre la question et les passages qu’il s’apprêtait à transmettre au modèle. Sous un seuil, une question qui ne me concerne pas est refusée avec un texte fixe, et le modèle de langue n’est jamais appelé. Ce refus n’est pas gratuit, puisqu’en production une API hébergée a déjà calculé l’embedding de la question, mais il supprime l’appel de génération : une preuve faible ne devient jamais une réponse fluide. Les questions qui me concernent suivent un autre chemin, décrit plus bas, parce qu’un score de similarité ne sait pas distinguer une question générale sur le travail de quelqu’un d’une question hors sujet.
Pourquoi on ne peut pas poser de seuil sur un score de fusion de rangs réciproques
Le retriever est hybride : une recherche vectorielle dense et une recherche par mots-clés en mots entiers, fusionnées par fusion de rangs réciproques (reciprocal rank fusion, RRF). La façon dont cet ensemble se comporte avec du persan et de l’anglais côte à côte est traitée dans la recherche hybride pour le RAG en persan.
La RRF combine bien des classements, mais c’est un mauvais nombre sur lequel poser un seuil. Dans la formulation de Cormack, Clarke et Büttcher, le score d’un document est la somme de 1/(k + r(d)) sur l’ensemble des classements, où r(d) est son rang dans chaque liste et où k = 60 « a été fixé lors d’une étude pilote ». Le score n’est construit qu’à partir de positions : un corpus de pur bruit produit donc quand même un document classé premier, avec le meilleur score fusionné disponible. Un seuil sur ce nombre mesure le rang, pas la pertinence.
Ce que le seuil compare à la place
Chaque retriever capable de produire une similarité bornée en rapporte une :
La recherche vectorielle rapporte la similarité cosinus, ramenée à l’intervalle de 0 à 1. Le seuil utilise la similarité avec la question telle qu’elle a été posée et, pour une question de relance, avec la question jointe à la précédente. Quand une question de relance est formulée comme une position dans une liste, comme « le deuxième », l’élément qu’elle désigne s’y ajoute : la position est lue dans la question, la liste dans la réponse précédente, d’après les titres et les noms du site ou ce que la réponse cite entre guillemets, et le modèle apprend de quel élément il s’agit. Cet élément ne s’y ajoute que si la position et la liste peuvent être lues sans aucun doute ; sinon, c’est le début de la réponse précédente qui s’y ajoute. C’est la formulation qui est testée, pas la réponse : une relance sans rapport qui dit par hasard « le deuxième » reçoit elle aussi le début de la réponse et peut franchir le seuil ; le prompt et le sas restent derrière elle. Quand une question me concerne, la récupération cherche aussi avec mon nom ajouté. Cela aide à ordonner les passages, mais ne compte jamais pour le seuil : un nom fait paraître n’importe quelle question sur moi proche du CV, y compris celles auxquelles le site ne peut pas répondre.
La recherche par mots-clés rapporte un taux de couverture : la part des mots porteurs de sens de la question, de trois caractères ou plus (deux en chinois), retrouvés comme mots entiers dans le passage. Les mots vides sont retirés d’abord, dans chacune des langues du site, et la couverture ne compte pour le seuil que si au moins deux mots porteurs de sens différents correspondent. Un seul mot, c’est une coïncidence. Pour une relance qui ne dit rien d’autre que l’élément visé, comme « Parle-moi davantage du deuxième », les mots porteurs de sens sont ceux du titre ou du nom que le site donne à cet élément.
Chaque passage conserve la plus élevée des deux valeurs, et le seuil est comparé à la meilleure d’entre elles sur l’ensemble des passages renvoyés ; le passage qui la fixe figure toujours parmi eux. Le score fusionné ne décide que de l’ordre.
Les mots entiers comptent. Si l’on compare des sous-chaînes, « art » se retrouve dans « départ », et des questions sans rapport se mettent à ressembler à des preuves. Si le service d’embedding est injoignable, la récupération se rabat sur la seule recherche par mots-clés, et le seuil s’applique toujours.
Les questions auxquelles un score de similarité ne peut pas répondre
« Qu’a-t-il fait récemment ? » n’a pas de plus proche voisin. Sa réponse est une liste triée par date, et aucun passage ne ressemble à cela : avec le modèle d’embedding de ce site, cette question a obtenu un score inférieur à celui d’une question sur la météo. Les questions sur l’ensemble du travail sont donc reconnues par des motifs, dans chacune des dix langues du site, comme l’ensemble de refus. Cela couvre ce que je fais aujourd’hui ou ai fait récemment, mon parcours, mes projets, mes recherches, mes écrits, ma formation, mes compétences et mes services. On répond à ces questions à partir des fiches du site : des entrées du CV, des études de cas, des articles et des services, lues dans la base de données pour chaque question. Les fiches arrivent dans la langue du lecteur quand une traduction existe, et celles qui sont datées sont classées selon leurs propres dates, des plus récentes aux plus anciennes.
Les fiches sont choisies par règle, pas par similarité ; le seuil ne s’y applique donc pas. Elles ne sont dispensées de rien d’autre : les motifs de refus passent en premier, chaque fiche datée porte ses dates à la précision qu’affiche le site, et chaque phrase construite sur l’une d’elles passe par le même sas.
Une question sur moi que les motifs n’orientent pas vers les fiches, et qu’aucun passage n’étaye, reçoit un bref aperçu de ces fiches plutôt qu’un refus, parce qu’un refus à tort dirait au lecteur que le site ne traite pas un sujet qu’il traite. Si les fiches n’y répondent pas non plus, le modèle a pour consigne de répondre par un token fixe plutôt que par de la prose, et le lecteur voit le même refus fixe. Le jugement du modèle devient ainsi une voie de plus vers le refus. Il ne transforme jamais un refus en réponse.
Comment choisir un seuil de similarité pour un RAG
Il n’existe pas de nombre transposable. La similarité cosinus dépend du modèle d’embedding, du mélange de langues et du corpus : un seuil qui convient à un modèle peut tout refuser, ou ne rien refuser, sur un autre.
La valeur par défaut de conception sur ce site est 0,35, et la suite de tests fait tourner à cette valeur un modèle d’embedding de substitution, un modèle bouchon qui ne sert que dans les tests. Elle n’a pas encore été calibrée sur le modèle d’embedding de production. Une commande qui n’exécute que la récupération fait passer par le modèle d’embedding déployé les questions du jeu de référence et les questions suggérées du site, sans appeler le modèle de langue, et la valeur de production ne change que si cette exécution réussit. Ce n’est pas une valeur à recopier. Pour choisir la vôtre :
Faites passer par le modèle d’embedding que vous déployez les questions auxquelles l’assistant doit répondre et celles qu’il doit refuser, puis comparez les deux distributions de meilleure similarité.
Décidez, parmi les questions auxquelles l’assistant peut répondre, combien vous acceptez d’en perdre pour bloquer celles qui doivent être refusées. Là où une réponse fausse énoncée avec assurance est pire que pas de réponse du tout, relevez le seuil.
Notez à quel modèle d’embedding et à quel corpus ce nombre appartient. Chaque page ajoutée au corpus modifie ce qu’une question hors sujet peut faire remonter, cet article compris.
La démo RAG et sans RAG est construite autour de cette frontière. Elle n’a aucun chemin sans ancrage : une question sans rapport avec moi, et qu’aucun passage n’étaye, s’arrête avant d’atteindre le modèle de langue.
Couche 3 : le prompt système est la seule couche qu’un modèle peut ignorer
Le prompt n’en fait pas moins un vrai travail. Il demande au modèle de n’utiliser que les sources numérotées fournies avec la question, de parler de moi à la troisième personne et dans la langue du lecteur, de ne jamais énoncer de disponibilité, de tarif ni de délai, de ne jamais inventer ni calculer un chiffre ou une date, de ne dire « actuellement » que de ce qu’une fiche marque comme en cours, de terminer chaque phrase factuelle par un marqueur de source, et de répondre par un token fixe quand les sources ne couvrent pas la question.
Il ne peut rien imposer de tout cela. La fiche LLM07:2025 System Prompt Leakage de l’OWASP recommande des garde-fous en dehors du modèle, parce qu’un système indépendant qui inspecte la sortie « est préférable à des instructions dans le prompt système ». Le guide d’Anthropic sur la réduction des hallucinations, qui prévoit notamment de laisser le modèle dire qu’il ne sait pas, est tout aussi franc : « si ces techniques réduisent nettement les hallucinations, elles ne les éliminent pas entièrement ».
Le prompt est donc écrit en partant du principe qu’il sera parfois ignoré. Son rôle est de faire du respect des règles le chemin le plus simple, et chaque instruction à risque élevé a un pendant déterministe :
Instruction du prompt | Pendant déterministe |
|---|---|
Un marqueur de source sur chaque phrase factuelle | Le sas vérifie que le marqueur est présent et dans la plage |
Ne jamais inventer de nombre | Chaque nombre, URL et adresse e-mail doit figurer dans une source que la phrase cite |
Écrire à la troisième personne | Le contrôle de la première personne du sas |
Aucun honoraire ni disponibilité | Les motifs de la couche 1, puis les contrôles de valeur et de première personne du sas |
Une instruction n’a pas de pendant complet : « n’utiliser que ce que disent les sources », pour une affirmation qui ne contient aucun nombre. Le sas peut exiger un marqueur valide sur cette phrase. Il ne peut pas décider si la source le dit. Les règles sur le temps n’en ont pas non plus. Une phrase qui place deux événements datés dans le mauvais ordre, ou qui présente un ancien poste comme récent, ne contient aucune valeur que le sas puisse vérifier. Les fiches réduisent ce risque en arrivant classées par date, avec les entrées en cours signalées ; elles ne le suppriment pas.
Couche 4 : filtrer le flux phrase par phrase
On ne peut pas retirer une phrase que le lecteur a déjà lue. La documentation NeMo Guardrails de NVIDIA nomme le compromis : avec stream_first activé, sa valeur par défaut, « si un rail bloque le contenu, l’utilisateur a déjà reçu les tokens ». Ce site prend l’autre parti. Le texte est retenu jusqu’à la fin d’une phrase, vérifié, et diffusé seulement ensuite, au prix d’environ une phrase de retard.
Chaque phrase subit quatre vérifications, chacune portant sur des chaînes de caractères plutôt que sur le sens :
Marqueur dans la plage : il désigne une source qui a bien été fournie.
Marqueur présent sur chaque phrase de fond ; une courte phrase de liaison sans valeur passe. La longueur se compte en mots séparés par des espaces, sauf en chinois, qui n’en utilise pas : trois caractères y comptent pour deux mots.
Valeurs présentes dans les preuves citées : chaque nombre, URL et adresse e-mail figure dans une source que la phrase cite, les chiffres persans et arabes étant convertis en chiffres latins.
Aucune première personne, qui signifierait que l’assistant s’est mis à parler en mon nom.
En cas de violation, les phrases déjà diffusées restent, celle qui échoue n’est jamais envoyée, et le flux s’arrête, ce qui annule aussi la génération en amont. Le lecteur voit un texte fixe indiquant que la suite de la réponse n’a pas pu être étayée par les sources de ce site et qu’elle a été retenue. Les marqueurs sont vérifiés, puis retirés : le lecteur voit de la prose, pas une bibliographie. Une réponse tronquée reçoit un avis différent : une phrase interrompue n’est pas une phrase non étayée.
« Étayé » ne veut pas dire « vrai ». Les valeurs sont comparées aux sources que la phrase cite, et non à l’affirmation : une phrase qui cite deux sources peut prendre une valeur dans l’une ou l’autre, et une phrase sans valeur passe avec n’importe quel marqueur compris dans la plage. Le sas ne peut pas montrer qu’une affirmation est correcte, ni même que le passage cité l’énonce. La fiche LLM09:2025 Misinformation de l’OWASP demande aux équipes de « valider automatiquement les sorties clés » ; c’en est une version étroite et déterministe. Les mécanismes sont détaillés dans garde-fous LLM en streaming.
Couche 5 : règles de voix et de représentation
Un assistant qui parle pour quelqu’un fait des déclarations en son nom
Dans l’affaire Moffatt v. Air Canada (2024 BCCRT 149), rapportée par McCarthy Tétrault et Bristows, le Civil Resolution Tribunal de Colombie-Britannique a eu à trancher le cas d’un chatbot de compagnie aérienne qui avait laissé entendre qu’un client pouvait demander rétroactivement un tarif de deuil. La position de la compagnie, selon les termes du tribunal, revenait à suggérer que « le chatbot est une entité juridique distincte, responsable de ses propres actes ». Le tribunal n’a pas suivi : « Peu importe que l’information provienne d’une page statique ou d’un chatbot ».
Il s’agit d’un contexte d’ingénierie, pas d’un conseil juridique, et une décision de tribunal ne fait pas une règle générale. La leçon d’ingénierie est plus étroite : un assistant présent sur votre site parle avec l’autorité de votre site. Un tarif ou une date de démarrage écrits en mon nom seraient une déclaration que je n’ai jamais faite. Une réponse fausse énoncée avec assurance est pire que pas de réponse ; un engagement faux énoncé avec assurance est pire encore.
Troisième personne, textes de refus fixes et contrôle de la première personne
L’assistant n’est jamais moi. Il parle de moi à la troisième personne, et tous les refus et tous les avis sont des textes fixes. La règle de voix est appliquée à trois endroits :
La couche 1 écarte, avant la récupération, les questions portant sur les honoraires, la disponibilité, le recrutement et les informations privées, dans chacune des langues du site.
La couche 3 interdit la première personne et tout engagement en mon nom.
La couche 4 arrête le flux dès qu’un mot à la première personne apparaît.
Le contrôle est plus faible en persan. La liste anglaise de première personne couvre les pronoms. La liste persane est établie à la main, pas exhaustive : le persan marque la personne par des terminaisons verbales, et une règle assez large pour les couvrir toutes intercepterait aussi des mots ordinaires qui se terminent de la même façon. La liste contient les pronoms et quelques verbes à risque, comme هستم et دارم, chacun sous les deux formes que la normalisation peut produire : le contrôle normalise avant de découper les mots, si bien que میکنم lui parvient en deux tokens et میکنم en un seul. Ce qui reste non couvert, ce sont les terminaisons, pas l’orthographe. Le persan s’appuie davantage sur le prompt, et cela est écrit noir sur blanc plutôt que caché. Pour les autres langues du site, la liste contient les pronoms personnels et possessifs de la première personne et, pour l’espagnol, le portugais, le russe, l’arabe et le hindi, qui disent le plus souvent « je » par le seul verbe, quelques verbes à la première personne en plus. En chinois, qui ne sépare pas les mots par des espaces, le contrôle cherche 我 n’importe où dans la phrase, sauf dans un composé de 自我, « auto- », comme 自我修正, « autocorrection ». En arabe, un mot de première personne est laissé de côté à dessein, parce que la normalisation des lettres qui rend comparables les graphies persane et arabe le rend identique à une préposition courante.
Abus de coût et denial of wallet : la même famille de défaillances
Une hallucination, c’est une sortie que personne n’a autorisée. Une facture sans limite, c’est une dépense que personne n’a autorisée. L’OWASP classe la seconde sous LLM10:2025 Unbounded Consumption, qui recouvre le Denial of Wallet : les attaquants « exploitent le modèle de facturation à l’usage des services d’IA dans le cloud, ce qui fait peser sur le fournisseur des charges financières insoutenables ». Ses mesures d’atténuation comprennent des limites de taille d’entrée, des limites de débit et des quotas par utilisateur, des délais d’expiration et du bridage, ainsi qu’une dégradation progressive.
Un budget vérifié avant l’appel, pas une alerte après
Une vérification postérieure à l’appel au modèle a déjà dépensé l’argent. Sur ce site, une vérification de la dépense mensuelle s’exécute après le seuil et avant l’appel au modèle. Elle ajoute à la dépense déjà engagée une borne supérieure du coût de ce tour : l’intégralité du prompt comptée à raison d’un token par octet UTF-8, plus le plafond complet de sortie, allocation de raisonnement comprise. C’est en se fondant sur le coût attendu que l’on finit par dépasser un plafond.
Si le total devait dépasser le plafond, aucun modèle n’est appelé et le lecteur reçoit un avis fixe indiquant que la limite mensuelle est atteinte, pas un message d’erreur.
Le compte d’octets est un plafond, pas une estimation généreuse. Tous les vocabulaires vers lesquels cet endpoint peut pointer sont des BPE au niveau de l’octet, et dans un tel vocabulaire un token est une suite non vide d’octets : aucun texte ne peut donc produire plus de tokens qu’il n’a d’octets, dans quelque langue que ce soit. La seule façon de dépasser cette borne serait un tokenizer qui allonge le texte avant de le découper, et aucun de ces vocabulaires ne le fait. Cette borne a remplacé une règle forfaitaire de deux caractères par token, celle que ce site a abandonnée : la taxe sur les tokens du persan a mesuré que cette règle passait sous le compte réel sur chaque phrase persane d’un corpus parallèle avec cl100k_base. Le plafond est large — pour le persan, il réserve plusieurs fois ce que le prompt coûte réellement — et il est large dans la seule direction où un plafond de dépenses a le droit de se tromper.
Deux limites subsistent. La vérification n’est pas une réservation : la dépense est lue et comparée, pas retenue, si bien que des requêtes qui arrivent ensemble peuvent toutes passer et dépasser le plafond ; les limites par adresse IP réduisent cette fenêtre sans la fermer. Et le compteur n’est pas un grand livre complet : il retient le coût des appels au modèle faits par cet endpoint, de sorte que l’embedding hébergé derrière chaque question reste en dehors, et une écriture perdue pendant que le stockage du compteur est injoignable n’est jamais rejouée. Le plafond est un garde-fou, pas une facture.
Échouer fermé sur la dépense, échouer ouvert sur les limites de débit
Si le stockage du compteur est injoignable, la dépense est inconnue, et une dépense inconnue face à un plafond strict n’a qu’une lecture sûre : refuser comme si le plafond était atteint.
Le limiteur de débit, lui, échoue en position ouverte, parce qu’une panne de cache ne doit pas faire tomber le site. Le pire cas d’une limite de débit ouverte, ce sont quelques requêtes de plus ; le pire cas d’un plafond de dépenses ouvert, c’est une facture sans limite. Il existe trois limites par adresse IP, qui se rechargent sur une minute, une heure et une journée, indexées sur l’adresse observée par le proxy en périphérie plutôt que sur un en-tête que le client peut saisir. Elles ralentissent les scripts ; le plafond mensuel est le filet de sécurité sur la dépense, pas une garantie.
Cesser de payer quand le lecteur s’en va
Un onglet de navigateur fermé n’arrête pas une requête en amont vers le modèle. Le serveur vérifie la déconnexion à l’intérieur de la boucle de streaming et ferme le flux du fournisseur, ce qui annule la requête. L’arrêt du sas fait la même chose : personne ne doit payer pour des phrases que personne ne verra.
Ce qui a été généré avant la coupure l’a bel et bien été, figure sur la facture, et le mois en est donc débité. Les deux protocoles de fournisseur déclarent la consommation dans un événement final qu’un flux interrompu n’atteint jamais : le service conserve donc chaque caractère reçu et ne comble que les trous laissés par le fournisseur, à raison d’un token par octet UTF-8. Là où le fournisseur a bien déclaré, ce sont ses chiffres qui l’emportent : un tour mené à son terme enregistre exactement ce qu’il a annoncé, pas une approximation.
Comment évaluer un RAG : exactitude du refus, recall@k et ancrage
Trois propriétés comptent. L’exactitude du refus mesure si l’assistant écarte bien ce qu’il doit écarter. Le recall@k mesure si la preuve parvient au modèle. L’ancrage mesure si la réponse reste à l’intérieur de cette preuve. Sur ce site, un jeu de référence (golden set) de questions dans les dix langues du site, anglaises et persanes pour la plupart, est noté de façon déterministe à chaque exécution de l’intégration continue, sans le moindre appel au modèle.
Exactitude du refus : deux jeux, pas de demi-point
Le refus est noté sur deux jeux, parce que les deux couches de refus échouent différemment. Les refus par motif doivent être interceptés par la couche 1 avant toute récupération ; les questions sans preuve, qui n’ont rien à voir avec le site, doivent tomber sous le seuil et ne pas être reconnues comme des questions sur moi. Un troisième jeu vérifie que les questions sur l’ensemble du travail atteignent les fiches du site.
Les deux jeux doivent obtenir un score parfait pour que le build passe. Un seul refus manqué, c’est un engagement inventé sur le site d’une personne réelle, et une moyenne le masquerait. La même exécution vérifie la défaillance inverse : des questions auxquelles l’assistant devrait répondre, refusées par les motifs ou par le seuil. La FAQ d’évaluation de Hamel Husain et Shreya Shankar préfère le binaire réussite/échec aux échelles de notation, parce que « les évaluations binaires imposent une pensée plus claire et un étiquetage plus cohérent ».
Je ne cite pas les questions à refuser : cet article entrera dans le corpus de l’assistant, et les citer donnerait à ces questions précises une forte correspondance par mots-clés sur cette page.
Recall@k sous le k par défaut
Dans le jeu de référence, le recall@k demande si au moins un passage répondant à la question figure dans les k premiers, ce qui en fait un taux de succès. L’article d’Anthropic sur Contextual Retrieval retient la définition plus stricte de la part des documents pertinents effectivement récupérés, et rapporte « 1 moins recall@20 » comme mesure d’échec.
Le jeu de référence mesure le recall à k = 5, en deçà du top-k par défaut de 8, parce que sur un corpus de test de quelques dizaines de chunks les huit premiers représentent une large part de tout ce qui existe, et mesurer à ce niveau flatterait le retriever.
Ancrage : appliqué phrase par phrase, pas noté hors ligne
Hors ligne, l’ancrage se note d’ordinaire sous le nom de faithfulness. Ragas le définit comme les affirmations d’une réponse que le contexte récupéré étaye, divisées par l’ensemble de ses affirmations, sur une échelle de 0 à 1 ; dans sa forme standard, un LLM identifie les affirmations et les vérifie.
Les juges LLM sont utiles et biaisés. Zheng et ses collègues ont relevé des « biais de position, de verbosité et d’auto-valorisation », tout en constatant que les juges performants atteignent malgré tout plus de 80 % d’accord avec les préférences humaines. Husain et Shankar conseillent de valider les taux de vrais positifs et de vrais négatifs d’un juge sur un jeu étiqueté tenu à l’écart, et de commencer par des vérifications de code peu coûteuses partout où une règle peut trancher.
Ce site prend la voie du code : le sas applique l’ancrage à l’exécution, et aucune métrique de faithfulness ni aucun juge LLM ne tourne en intégration continue.
Ce que mon jeu de référence ne prouve pas
Le modèle d’embedding est un substitut. En intégration continue, la récupération utilise un modèle de hachage en sac de tokens, sans aucun sens appris. L’aiguillage, la fusion, le classement, la sélection du top-k et la décision sur les preuves, comparaison au seuil comprise, sont le code de production ; seul le calcul des scores des candidats, que la production effectue dans la base de données, est reproduit dans le test. L’intégration continue détecte donc les régressions de la mécanique d’aiguillage et de classement, pas celles de la requête en base ni du recall de l’assistant en service, et le substitut fait même travailler une liste creuse que la production n’utilise pas.
Les jeux sont petits. Il y a vingt et un refus par motif et onze questions sans preuve. Exiger un sans-faute sur onze questions, c’est un garde-fou contre les régressions, pas un taux de refus.
Les vérifications en conditions réelles sont des commandes, pas des tâches d’intégration continue. Le test qui enverrait le jeu de référence au retriever déployé est toujours ignoré. Une commande qui n’exécute que la récupération fait passer par le modèle d’embedding déployé les questions de référence et les questions suggérées, sans appeler le modèle, et un script lancé à la main après chaque import pose à l’assistant en service les questions qui doivent être refusées.
Les réponses tirées des fiches ne sont vérifiées que par le sas. L’intégration continue vérifie, sur un jeu de données figé, quelles questions atteignent les fiches du site et quelles fiches elles reçoivent, avec un substitut scripté à la place du modèle. La façon dont un vrai modèle formule une réponse à partir d’elles est vérifiée à l’exécution, par le sas.
Je ne publie donc aucun chiffre de précision, de refus ou de recall pour l’assistant : l’exécution automatisée s’appuie sur un modèle d’embedding de substitution, les vérifications en conditions réelles sont petites et lancées à la main, et ce site n’estime pas des nombres qu’il n’a pas mesurés.
La structure plutôt que la confiance dans un assistant contractuel
J’ai travaillé comme ingénieur IA sur Kartez Contract, un espace de travail contractuel trilingue que le client a arrêté à un mois de son achèvement, pour des raisons de financement liées à la guerre. Dans ce projet, l’ancrage du modèle a été assuré par la structure plutôt que par la confiance : les réponses ne s’appuient que sur les clauses sélectionnées, les corrections doivent citer le texte existant mot pour mot, les sorties suivent des schémas fixes, et le modèle tourne avec une part d’aléatoire faible lorsqu’il rédige. Ce sont des contraintes de conception, pas une garantie mesurée. Le seuil et le sas décrits plus haut appartiennent à l’assistant de ce site, pas à Kartez. L’étude de cas Kartez Contract présente le projet. Ce à quoi ces patterns ressemblent dans une IA contractuelle, et pourquoi le jeu d’évaluation vient en premier, est traité dans que construire face aux hallucinations de l’IA juridique.
Checklist : des garde-fous pour un assistant RAG en production
Refusez d’abord par motif. Écartez les honoraires, la disponibilité, les données privées et l’extraction d’instructions avant toute récupération.
Posez le seuil sur une similarité, pas sur un score de rang. Le cosinus peut porter un seuil, et la couverture en mots entiers aussi, une fois les mots vides retirés et dès lors qu’au moins deux mots porteurs de sens correspondent ; un score RRF, non. Sous le seuil, refusez avec un texte fixe et n’appelez pas le modèle.
Répondez aux questions d’ensemble à partir des fiches, pas de la similarité. Une liste triée par date n’a pas de plus proche voisin.
Calibrez le seuil sur le modèle d’embedding que vous déployez. Un seuil vérifié sur un substitut n’est qu’une valeur par défaut.
Doublez chaque règle du prompt d’une vérification située en dehors du modèle.
Filtrez le flux phrase par phrase. Exigez un marqueur, vérifiez à la lettre les nombres, les URL et les adresses e-mail, retenez tout à partir de la phrase en échec, et donnez à la troncature son propre avis.
Interdisez la première personne dans les assistants qui parlent d’une personne ou d’une entreprise, et documentez les endroits où le contrôle est plus faible.
Réservez une borne supérieure avant l’appel, pas une estimation généreuse. Pour un BPE au niveau de l’octet, le nombre d’octets UTF-8 du prompt en est une. Rendez la réservation atomique pour que des requêtes concurrentes ne puissent pas toutes passer, échouez en position fermée, et annulez le travail en amont en cas de déconnexion.
Enregistrez un coût pour chaque appel, y compris ceux qui ont été interrompus : conservez le texte au fil du flux, et ne comblez que ce que l’événement final de consommation du fournisseur n’a pas déclaré.
Mesurez le refus séparément du recall. Indiquez le modèle d’embedding, la taille des jeux et ce que l’exécution ne prouve pas.
Questions fréquentes
Le RAG élimine-t-il les hallucinations ?
Non. Dans une étude préenregistrée, les outils de recherche juridique de LexisNexis et de Thomson Reuters, fondés sur le RAG, ont encore halluciné dans 17 % à 33 % des cas, et un contexte insuffisant peut rendre un modèle plus sûr de lui plutôt que plus prudent. La récupération améliore les chances ; les garanties viennent de vérifications situées en dehors du modèle.
Quel seuil de similarité utiliser dans un système RAG ?
Il n’existe pas de nombre transposable, parce que les distributions de similarité dépendent du modèle d’embedding et du corpus. Posez le seuil sur une similarité bornée comme le cosinus, jamais sur un score de fusion de rangs réciproques, et fixez la valeur à partir de vos propres questions — celles auxquelles l’assistant doit répondre et celles qu’il doit refuser — passées par le modèle d’embedding que vous déployez. Un seuil vérifié uniquement sur un substitut est une valeur par défaut, pas une calibration.
Un prompt système suffit-il à empêcher les hallucinations ?
Non. L’OWASP recommande d’éviter « d’utiliser des prompts système pour contrôler le comportement du modèle lorsque c’est possible » et de s’appuyer plutôt « sur des systèmes extérieurs au LLM », et le guide d’Anthropic indique que les techniques de prompt réduisent les hallucinations sans les éliminer. Gardez le prompt, et donnez à chaque instruction qui compte une vérification déterministe en dehors du modèle.
Un juge LLM peut-il remplacer des vérifications déterministes ?
Pas pour les règles qu’une comparaison de chaînes peut trancher, comme le fait qu’un marqueur désigne une source réelle ou qu’un nombre figure dans les preuves. Les juges présentent des biais de position, de verbosité et d’auto-valorisation. Réservez-les aux questions auxquelles le code ne peut pas répondre, avec des étiquettes binaires et un juge validé sur des annotations humaines.
Comment empêcher un chatbot LLM de faire exploser la facture ?
Avant l’appel au modèle, réservez de façon atomique une borne supérieure de son coût — avec un tokenizer BPE au niveau de l’octet, le nombre d’octets UTF-8 du prompt en est une, dans n’importe quelle langue — et refusez si le compteur est indisponible. Enregistrez un coût pour chaque appel, y compris ceux qui ont été interrompus, en conservant le texte diffusé et en comblant ce que l’événement final de consommation du fournisseur n’a jamais déclaré. Repliez-vous sur un texte fixe plutôt que de renvoyer une erreur, et annulez la génération en amont quand le client se déconnecte. L’OWASP répertorie ce risque sous LLM10:2025 Unbounded Consumption, qui inclut le Denial of Wallet.
Sources
Magesh et ses collègues, « Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools » (2024).
Google Research, « Deeper insights into retrieval augmented generation: The role of sufficient context » (blog, 14 mai 2025).
Joren et ses collègues, « Sufficient Context: A New Lens on Retrieval Augmented Generation Systems » (arXiv 2024, révisé en 2025).
Kalai et ses collègues, « Why Language Models Hallucinate » (2025).
Cormack, Clarke et Büttcher, « Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods » (SIGIR 2009).
OWASP GenAI Security Project, « LLM07:2025 System Prompt Leakage ».
Documentation Anthropic, « Reduce hallucinations ».
NVIDIA NeMo Guardrails, « Output Rail Streaming Configuration ».
OWASP GenAI Security Project, « LLM09:2025 Misinformation ».
McCarthy Tétrault, blog TechLex, « Moffatt v. Air Canada: A Misrepresentation by an AI Chatbot » (19 février 2024).
Bristows, Inquisitive Minds, « AI Chatbot flies solo and Air Canada foots the bill - Moffatt v. Air Canada » (27 mars 2024).
OWASP GenAI Security Project, « LLM10:2025 Unbounded Consumption ».
Hamel Husain et Shreya Shankar, « AI Evals: Everything You Need to Know » (dernière modification le 13 septembre 2026).
Anthropic, « Introducing Contextual Retrieval » (19 septembre 2024).
Documentation Ragas, « Faithfulness ».
Zheng et ses collègues, « Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena » (NeurIPS 2023, Datasets and Benchmarks).
Si vous concevez un assistant qui doit refuser aussi sûrement qu’il répond, commencez par un Diagnostic de projet.