
Dublagem com IA: arquitetura e lições de um pipeline em produção
Como funciona a dublagem com IA em produção: quatro etapas de modelo, armadilhas do persa e o fallback de provedores que substituiu o silêncio após uma queda.
Um pipeline de dublagem com IA encadeia quatro etapas de modelo: transcrição com detecção de falantes, uma tradução que caiba no tempo original, uma voz distinta para cada falante e o alinhamento de tempo com a mixagem final. Os modelos são a parte que se pode alugar. O que decide se as dublagens continuam saindo é a plataforma em volta deles: um gateway por provedor de IA com fallback automático, filas duráveis, trabalho que é retomado depois de uma falha, um preço exibido antes de a tarefa rodar e um reembolso quando ela falha. Na Booq, onde sou CTO, a queda de um provedor de fala certa vez gerou dublagens com silêncio onde faltavam falas. Hoje a fala recorre em cascata a uma cadeia de provedores: uma voz um pouco diferente é melhor do que o silêncio.
Como funciona um pipeline de dublagem com IA: quatro etapas
A pesquisa sobre dublagem automática descreve uma cadeia parecida. Federico e colegas (2020) partiram de um pipeline de tradução de fala para fala (speech-to-speech translation) e acrescentaram o que a dublagem exige:
Tradução automática que gera uma saída com o tamanho desejado.
Alinhamento prosódico: fazer as frases e as pausas da tradução corresponderem aos segmentos da fala original.
Síntese de fala (TTS, text-to-speech) com ajuste fino da duração de cada enunciado.
Renderização de áudio que acrescenta o ruído de fundo e a reverberação extraídos do áudio original.
Um pipeline que dubla um vídeo com várias pessoas também precisa saber quem está falando.
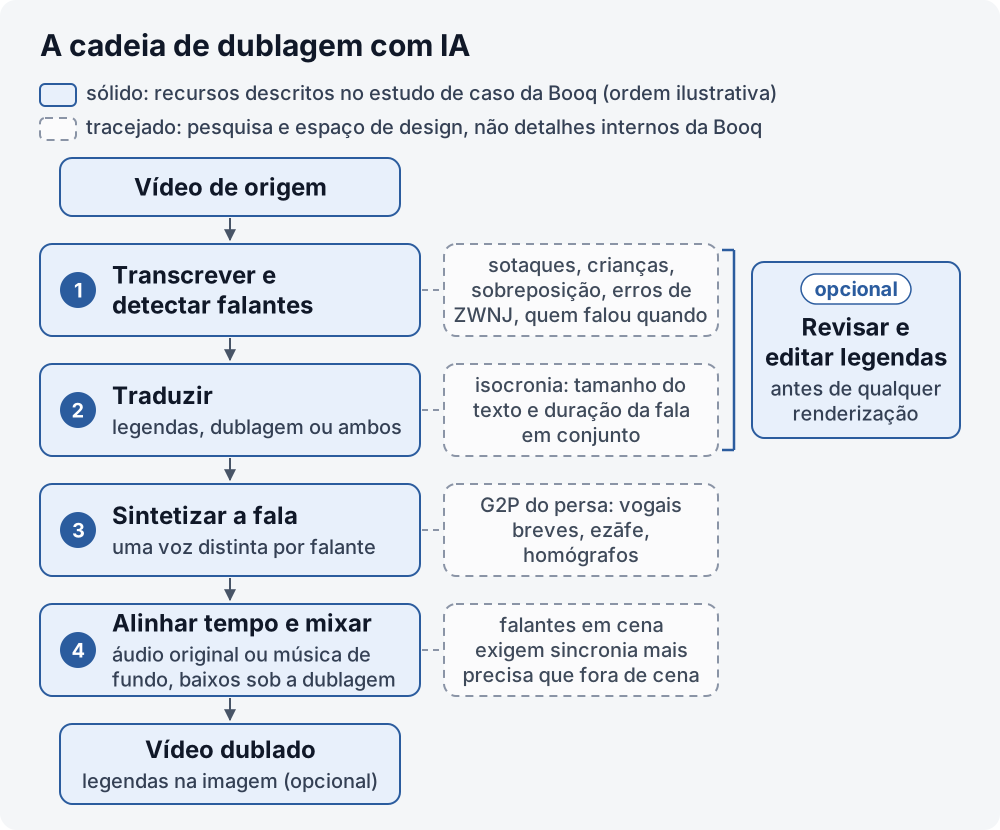
Abrir o diagrama da cadeia em tamanho real

As seções de cada etapa, a seguir, descrevem a pesquisa e o espaço de design: o que cada etapa precisa resolver e onde ela quebra. Elas não descrevem o funcionamento interno de nenhum produto, incluindo o da Booq. Onde a Booq aparece nelas, está apenas o que o seu estudo de caso afirma, e a seção sobre pronúncia do persa se apoia na minha própria pesquisa em síntese de fala. As seções sobre a plataforma são em primeira mão.
Etapa 1: transcrição e detecção de falantes
Todas as etapas seguintes herdam a transcrição. Uma palavra que o reconhecedor inventa é traduzida, ganha voz e é encaixada no tempo com a mesma confiança que uma palavra que o falante disse. Para o persa, a evidência pública mais útil sobre onde o reconhecimento automático de fala (ASR) erra é o PSRB, um benchmark publicado em 2025.
Onde o reconhecimento de fala em persa falha
O PSRB avalia dez sistemas de ASR, comerciais e de código aberto. O resumo do artigo é que os modelos em geral têm bom desempenho no persa padrão, mas têm dificuldade com sotaques regionais, fala infantil e desafios linguísticos específicos. Os detalhes parecem uma descrição do áudio que as pessoas querem dublar:
Sotaques. Dos 12 sotaques avaliados, a precisão do reconhecimento foi a mais baixa nos de Mashhad e de Yazd.
Crianças. As crianças foram os falantes com o pior reconhecimento.
Vários falantes. Todos os modelos erraram mais em áudio com vários falantes do que em áudio com um só falante. Os autores apontam a fala sobreposta como o principal desafio nesse tipo de áudio, ainda que o benchmark tenha mantido a sobreposição no mínimo, e alguns modelos às vezes omitiram um falante inteiro da transcrição.
Tipo de conteúdo. Os audiolivros tiveram as menores taxas de erro. Talk shows, animações e filmes, em que diálogo espontâneo, fala sobreposta e ruído de fundo são comuns, tiveram resultados substancialmente piores.
Registro. A fala do benchmark é 71,3% informal.
O artigo também aponta tipos de erro específicos da escrita e da fala persas:
Limites de palavra. O plural درختها (“árvores”) é escrito com um zero-width non-joiner (ZWNJ). Os erros aparecem quando o ZWNJ é omitido ou substituído: درخت ها ou درختها.
Troca de registro. O informal میخوام برم (“quero ir”) pode voltar como o formal میخواهم بروم, ou o contrário.
He-Kasreh. O /e/ breve que marca posse ou ligação pode ser escrito por extenso como a letra he (ه): کتاب او (“o livro dele”) pode ser transcrito como کتابه او. É o ezāfe escrito por extenso, o mesmo som não grafado que volta na Etapa 3.
Paráfrase. خوش میگذره (“está sendo agradável”) pode virar حال میده (“dá uma sensação boa”). O sentido sobrevive; as palavras, não.
Alucinação. Texto fluente e coerente que não tem base nenhuma no áudio.
A taxa de erro de palavras (WER) simples trata cada substituição como uma palavra inteira errada, então um deslize de ZWNJ pode custar tanto quanto uma palavra diferente, ou mais: se o ZWNJ vira um espaço, uma palavra se transforma em duas, o que conta como uma substituição mais uma inserção. O PSRB propõe uma variante ponderada por substituição, o SW-WER: para cada substituição, calcula-se a taxa de erro de caracteres e multiplica-se esse valor pelo número de palavras daquele alinhamento, de modo que um deslize de espaçamento custe menos do que uma palavra diferente. A recuperação de texto em persa precisa normalizar os mesmos caracteres, como explica o artigo sobre busca híbrida para RAG em persa.
A consequência para o design, na minha leitura: o áudio que as pessoas querem dublar é justamente onde o reconhecimento é mais fraco, e uma fala alucinada ou parafraseada não fica na transcrição. Ela vira uma fala dublada com toda a confiança. Esse é o argumento para um ponto de revisão antes da renderização. A Booq oferece os dois modos: rodar sem intervenção ou pausar para revisar e editar as legendas antes de qualquer renderização.
Diarização de falantes: quem falou quando
Park e colegas definem a diarização de falantes (speaker diarization) como a tarefa de identificar “quem falou quando”. Numa dublagem, é ela que decide que voz cada fala recebe. O Third DIHARD Diarization Challenge avaliou sistemas em 11 domínios diversos e concluiu que, para muitos deles, vídeo da web incluído, o problema “ainda está longe de ser resolvido”.
A verificação que eu colocaria depois da diarização em qualquer pipeline é simples: todo falante detectado tem falas, e toda fala tem um falante? Alguns sistemas no PSRB descartaram um falante inteiro da transcrição, e um falante descartado vira uma faixa de voz ausente.
Etapa 2: uma tradução que caiba no tempo
A dublagem acrescenta uma restrição à tradução: a nova fala precisa ser dita em mais ou menos o mesmo tempo que a original levou. Traduza livremente e a voz sintética terá de correr, ou a fala vai invadir a seguinte.
Isocronia: tamanho e duração são um só problema
O nome que a pesquisa dá a isso é isocronia (isochrony). Chronopoulou e colegas (2023) a descrevem como uma nova fala alinhada no tempo com o vídeo original, “incluindo movimentos da boca, pausas, gestos das mãos”. Eles treinam um modelo que otimiza em conjunto a tradução e a duração da fala resultante, e relatam uma fala que corresponde melhor ao tempo original do que trabalhos anteriores, com uma arquitetura mais simples.
Trabalhos anteriores controlavam o tamanho no próprio texto. O Isometric MT (Lakew e colegas, ICASSP 2022) usa como exemplo de meta uma tradução dentro de ±10% do tamanho da origem em número de caracteres, e é franco quanto ao custo disso: controlar o tamanho da saída custa qualidade de tradução, e a mitigação usual é gerar várias traduções candidatas (hipóteses N-best) e depois reordená-las. Os ±10% são o exemplo de um artigo, não uma regra do setor, e o número de caracteres é só um indicador aproximado de quanto tempo leva para dizer uma fala.
Quando o ritmo dá errado, o resultado é audível. A página de ajuda do YouTube sobre dublagem automática lista o ritmo da fala entre os motivos pelos quais um vídeo pode não ser elegível: uma fala original rápida demais “resultaria em uma dublagem acelerada impossível de ouvir”.
Quão rigorosa precisa ser a sincronização?
Mais rigorosa com o falante em cena do que fora dela e, a julgar pela prática profissional, menos absoluta do que a pesquisa costuma tratá-la. Brannon, Virkar e Thompson (TACL 2023) estudaram como as pessoas dublam, usando 319,57 horas de vídeo de 54 títulos de produção profissional. Os resultados deles contestam várias suposições comuns na literatura sobre dublagem, tanto humana quanto automática. Os autores defendem a importância da naturalidade vocal e da qualidade da tradução acima das restrições isométricas (tamanho em caracteres) e de sincronia labial, geralmente enfatizadas, e uma visão mais ponderada de quanto as restrições de tempo importam.
Também importa se o falante está em cena. Virkar e colegas (2022) partiram do modelo de alinhamento prosódico que haviam construído antes para a dublagem em cena e o estenderam para a dublagem fora de cena, que “exige restrições de sincronização menos rigorosas” do que dublar um falante cuja boca está visível. O orçamento de tempo, portanto, é uma decisão por cena, não uma configuração global.
Para a Booq, o que está publicado é que o tempo das falas é alinhado ao original. É tudo o que o estudo de caso diz sobre tempo, e tudo o que afirmo aqui.
Etapa 3: uma voz distinta para cada falante
Na Booq, cada falante detectado recebe uma voz distinta. Qualquer dublagem com vários falantes exige duas propriedades das suas vozes: dois falantes não devem soar parecidos, e um falante deve manter a mesma voz da primeira à última fala. Guarde a segunda; o post-mortem mais abaixo conta como ela perdeu.
Dados abertos de fala em persa são escassos. Os autores do ParsVoice escrevem que o persa “continua substancialmente sub-representado em recursos abertos de fala e texto”. O corpus deles inclui um subconjunto de 2.200 horas pronto para TTS, mais de 25 vezes maior do que o maior dataset aberto de TTS em persa disponível até então. Dados são uma restrição. A outra vem antes de existir qualquer áudio: decidir como o texto é pronunciado.
Pronúncia do persa: vogais breves, ezāfe e homógrafos
Entre junho de 2021 e setembro de 2022, trabalhei em pesquisa de síntese de fala (text-to-speech) em persa. Ela foi encomendada e supervisionada pela MCI (Hamrah-e Aval), a maior operadora de telefonia móvel do Irã, e gerida pela Fundação Nacional de Elites no âmbito do seu programa Shahid Ahmadi Roshan. A parte difícil era linguística. Nesse pipeline, o texto escrito passa primeiro pela conversão grafema-fonema (G2P), que decide como ele é pronunciado. Em seguida, um modelo de síntese de fala e um vocoder produzem a fala; o vocoder é o componente que transforma a saída acústica do modelo numa forma de onda de áudio. A escrita persa torna o primeiro passo ambíguo de três maneiras:
As vogais breves não são escritas, de modo que o texto sozinho não determina a pronúncia.
A construção ezāfe também não é escrita e precisa ser inferida.
Os homógrafos compartilham a mesma grafia entre palavras diferentes e não podem ser distinguidos sem contexto.
A pesquisa publicada diz o mesmo. Os autores do GE2PE (Findings of EMNLP 2024) descrevem o ezāfe como um som /e/ que liga substantivos a adjetivos e a substantivos descritivos, e dão um exemplo de homógrafo: /kerm/, /kerem/ e /karam/ são idênticos na forma escrita, کرم. Eles concluem que o G2P do persa precisa de uma entrada no nível do sintagma ou da frase para chegar a resultados aceitáveis. Doostmohammadi e colegas (2020) acrescentam que o ezāfe quase nunca é marcado na escrita persa, o que causa erros na leitura de frases complexas e no processamento de linguagem. O projeto está descrito no estudo de caso sobre síntese de fala em persa.
A consequência para o design é inferência minha, não uma conclusão desses artigos: não alimente um TTS de persa com os fragmentos em que uma faixa de legendas é cortada. Uma quebra de legenda pode partir uma cadeia de ezāfe ou separar um homógrafo das palavras que o desambiguam. Se ketāb-e dust-e man (“o livro do meu amigo”) é dividido em duas legendas e o primeiro fragmento termina em ketāb, não sobra nada nesse fragmento que indique que ketāb leva o ezāfe /e/. Sintetize frases inteiras e depois encaixe o áudio na linha do tempo.
Etapa 4: alinhamento de tempo e mixagem final
A última etapa transforma clipes numa trilha sonora que pertence ao vídeo. No pipeline de Federico, a renderização acrescenta o ruído de fundo e a reverberação extraídos do áudio original, para que a nova voz fique na mesma cena acústica da imagem.
Na Booq, o acabamento pode incluir legendas estilizadas gravadas na imagem, para vídeo vertical e widescreen, com o áudio original ou a música de fundo mantidos em volume baixo sob a dublagem. Legendas gravadas na imagem fazem parte do quadro, então o layout delas precisa ser decidido para cada proporção de tela antes da renderização; nenhum player consegue corrigir isso depois.
Duas questões de design pertencem a esta etapa. A primeira é o que fazer com uma fala cujo áudio sintetizado continua longo demais mesmo depois da tradução. A pesquisa e a prática oferecem três alavancas, e escolher entre elas é uma decisão de design, não uma conclusão de pesquisa:
Encurtar a fala na hora da tradução. É aí que atuam o Isometric MT e os modelos que otimizam tradução e duração em conjunto.
Ajustar a duração de cada enunciado no TTS. O pipeline de Federico faz esse ajuste fino enunciado a enunciado.
Acelerar a voz, dentro de limites. Essa alavanca vem da prática, não da pesquisa, e só funciona até certo ponto: a página de ajuda do YouTube avisa que uma dublagem acelerada pode ficar impossível de ouvir.
A segunda questão é o que o ouvinte escuta onde falta uma fala. Essa acabou se revelando uma questão de arquitetura, não de áudio.
A plataforma em torno dos modelos
Tudo o que veio até aqui é pesquisa que se pode ler e modelos que se podem alugar. Na Booq, cada funcionalidade depende de provedores externos de IA, e cada um deles pode falhar ou mudar de forma independente. Como CTO, defini a arquitetura da Booq e a levei do primeiro commit à produção; o estudo de caso da Booq descreve a plataforma. Todas as lições do post-mortem ficam em torno dos modelos, não dentro deles.
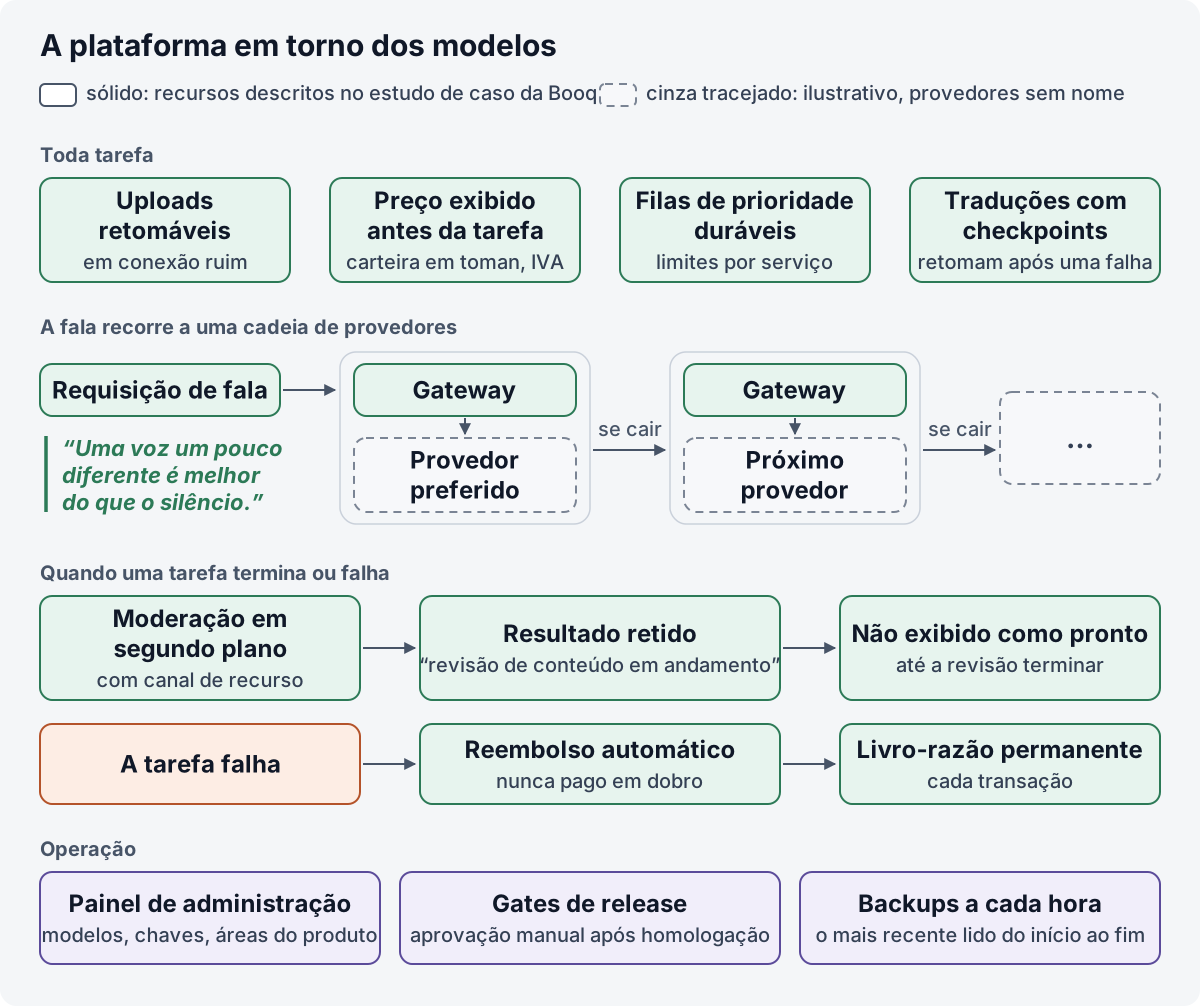
Abrir o diagrama da plataforma em tamanho real

Um gateway por provedor de IA
A Booq é um conjunto de serviços independentes por trás de um único aplicativo web, com um gateway separado para cada provedor de IA. É essa única decisão que permite trocar um modelo, rotacionar uma chave ou contornar automaticamente um provedor com falha, sem mexer no restante do produto. Modelos e chaves de provedores são trocados pelo painel de administração, sem um novo deploy. O estudo de caso associa cada gateway a um fallback automático, e o post-mortem mais abaixo mostra por que a fala precisava dele.
Filas de prioridade duráveis e checkpoints
Dublar um vídeo longo não cabe dentro de uma requisição web. Na Booq, o processamento pesado aguarda, em vez disso, em filas de prioridade duráveis, com limites por serviço. São os limites por serviço que impedem que um serviço com muita demanda deixe os outros sem recursos.
As traduções salvam pontos de controle (checkpoints) e retomam de onde pararam depois de uma falha. Sem checkpoints, uma falha perto do fim de uma transcrição longa repete todas as chamadas ao provedor feitas antes dela, e cada uma dessas chamadas é paga de novo.
Uploads retomáveis em conexões instáveis
Arquivos de vídeo grandes chegam à Booq por conexões instáveis, e os uploads, inclusive os de vários gigabytes, são retomados numa rede ruim, em vez de recomeçar do zero.
O mecanismo geral está sendo padronizado. O Resumable Uploads for HTTP é um Internet-Draft ativo no grupo de trabalho HTTP do IETF, e ainda não é um RFC: se o servidor conseguir indicar quantos dados processou antes da interrupção, o cliente retoma a partir desse ponto, em vez de enviar tudo de novo. É um trabalho em andamento, não uma descrição da implementação da Booq.
Preço antes da tarefa, reembolso em caso de falha
A cobrança faz parte do pipeline. Cada tarefa na Booq mostra o seu preço, ou a estimativa inicial, antes de rodar. A carteira é pré-paga em toman, com o IVA exibido de antemão, cada transação é registrada num livro-razão permanente e uma tarefa que falha é reembolsada automaticamente. Os reembolsos são protegidos contra pagamento em duplicidade.
Essa última propriedade merece os testes mais duros: uma nova tentativa depois de um timeout é exatamente o momento em que um reembolso ingênuo paga duas vezes.
Chaves, não releases
Áreas do produto na Booq são ativadas ou desativadas sem um release. Na taxonomia de feature toggles de Pete Hodgson, isso se aproxima de um ops toggle: um toggle que permite aos operadores desativar ou degradar uma funcionalidade rapidamente em produção.
O acesso é separado com o mesmo espírito. Clientes, administradores e equipe de suporte usam, cada um, um aplicativo implantado separadamente, o login feito em um não funciona em outro, e os consoles exigem um segundo fator, com permissões baseadas em papéis.
Post-mortem: quando a consistência da voz perdeu para o silêncio
A fala na Booq foi, de início, fixada de propósito num único provedor, porque outro provedor significa outra voz. Numa dublagem, a consistência parecia ser a propriedade a proteger. Então esse provedor saiu do ar, e as dublagens foram montadas com silêncio onde faltavam falas.
Hoje, a fala recorre em cascata a uma cadeia de provedores, pelo princípio de que uma voz um pouco diferente é melhor do que o silêncio.
Projetar uma cadeia de fallback de propósito
A escolha original não foi descuidada; ela protegia uma propriedade real. O estudo de caso resume as mudanças de rumo a que a operação da plataforma em produção levou: cada uma “trocou uma premissa confortável por um padrão mais seguro”. A lição é decidir qual falha você aceita antes que uma queda decida por você. Quando o provedor de fala preferido está fora do ar, um pipeline pode deixar uma lacuna, dar a tarefa como falha e reembolsá-la, ou usar outra voz. Só a lacuna entrega ao ouvinte uma dublagem cheia de buracos.
Daí decorre uma segunda decisão, e o que vem a seguir é análise minha, não uma descrição da Booq: quanto um fallback substitui. Se só a fala que falta troca de provedor, a voz daquele falante muda no meio da cena. Se toda a faixa do falante troca, a dublagem continua consistente, mas mais trabalho é refeito.
O livro de SRE do Google descreve uma ideia relacionada para serviços sobrecarregados, a degradação graciosa (graceful degradation): fazer menos trabalho reduzindo a qualidade das respostas. O que se aproveita aqui é o alerta de que “o caminho de código que você nunca usa é o caminho de código que (muitas vezes) não funciona”, e o conselho de exercitar o modo degradado regularmente. O que eu acrescentaria a qualquer cadeia de fallback de fala, como recomendação e não como descrição da Booq, são tarefas de teste agendadas, com clipes internos, por todos os provedores da cadeia, para que se saiba que o fallback funciona antes que uma queda precise dele.
A falha certa depende do produto. O assistente deste site faz o contrário: quando nada no site sustenta uma pergunta, ele responde com uma recusa em texto fixo em vez de adivinhar, e, quando não considera que a pergunta seja sobre mim, o modelo de linguagem nunca é chamado. Em perguntas e respostas, não dizer nada é a falha segura, porque uma resposta errada dada com confiança é pior do que nenhuma resposta. O design está em guardrails contra alucinação em RAG, e a página RAG vs. sem RAG do laboratório se apoia na mesma regra. Numa dublagem, o silêncio é a falha. Qual falha é aceitável é uma decisão de produto, não de modelo.
Moderação sem fazer o usuário esperar
A triagem de conteúdo na Booq rodava dentro da criação do projeto, e por isso os usuários esperavam entre o fim do upload e a página do projeto. Agora ela roda em segundo plano. Imagens, vídeo, áudio e texto passam por triagem, com um canal de recurso, e um resultado pronto fica retido com o status “revisão de conteúdo em andamento” até a revisão terminar. A saída não é apresentada como pronta enquanto a sua revisão ainda está em curso.
O padrão vale para qualquer verificação lenta num pipeline de mídia: tire-a do caminho da requisição e torne explícito o estado intermediário.
Gates de release e backups que alguém leu
Os deploys em produção na Booq deixaram de ser automáticos e passaram a depender de uma aprovação manual, que só é liberada depois que as verificações em homologação passam. Cada release passa por build, testes, um deploy em homologação e um smoke test antes que uma pessoa o aprove para produção, e um rollback de emergência para a versão anterior pode ser acionado manualmente. A plataforma roda num cluster de contêineres definido como código.
Os backups passaram a ser feitos a cada hora, e o mais recente foi lido do início ao fim, porque um backup que ninguém nunca leu não é um backup. O livro de SRE do Google diz isso de forma mais direta: “Ninguém quer de verdade fazer backups; o que as pessoas querem de verdade são restaurações.” Ele também põe a régua mais alto: você só sabe que consegue recuperar o seu estado recente se de fato fizer isso, por isso os testes de recuperação devem ser automatizados sempre que possível e rodar continuamente. Ler um backup do início ao fim é o piso, não a linha de chegada.
Desenvolver ou comprar: um checklist para qualquer pipeline de dublagem com IA
Falha e fallback
Quando um provedor de fala falha no meio de uma tarefa, o que o ouvinte recebe: silêncio, uma voz diferente ou uma tarefa com falha e um reembolso? Decida antes que uma queda decida.
Quando o fallback entra em ação, ele substitui uma fala ou a faixa inteira do falante?
O caminho de fallback é exercitado de propósito, com tarefas de teste agendadas, ou só durante quedas?
Plataforma e cobrança
Cada provedor de IA fica atrás do seu próprio gateway, de modo que trocar um modelo, rotacionar uma chave ou contornar um provedor não exija um release?
O trabalho pesado roda a partir de filas duráveis com limites por serviço, fora da requisição web?
Uma tradução longa consegue retomar a partir de um checkpoint, e um upload grande consegue ser retomado depois que a conexão cai?
O preço ou a estimativa aparece antes de a tarefa rodar, e está garantido que um reembolso nunca é pago duas vezes?
A moderação fica fora do caminho da requisição, com um estado explícito de “em revisão”?
Reconhecimento, tempo e vozes
O reconhecimento foi testado no seu próprio áudio: sotaques, crianças, fala informal, vários falantes, som de filme e de talk show, e não só audiolivros?
A sua pontuação de WER trata um deslize de espaçamento de ZWNJ como uma palavra inteira errada? Normalize antes ou use uma métrica ponderada como o SW-WER.
Depois da diarização, todo falante detectado tem falas e uma voz?
Existe um ponto para revisar e editar as legendas antes da renderização?
Quão rigorosa precisa ser a sincronização para este conteúdo: rostos em cena ou narração fora de cena?
O TTS de persa recebe frases inteiras, e não fragmentos de legenda que cortam uma cadeia de ezāfe?
Release e recuperação
Uma pessoa aprova a produção depois das verificações em homologação e do smoke test, e dá para fazer rollback manualmente?
Alguém já leu um backup do início ao fim?
Perguntas frequentes
Como funciona a dublagem com IA?
Um pipeline de dublagem com IA transcreve a fala original e detecta quem está falando, traduz cada fala para que ela possa ser dita em mais ou menos o tempo original, dá a cada falante uma voz sintética distinta e, por fim, alinha o tempo e mixa a nova fala com o fundo original. Em produção, essas etapas rodam dentro de uma plataforma de filas, gateways de provedores com fallback e, idealmente, um ponto de revisão antes da renderização.
A IA consegue dublar um vídeo em inglês para o persa?
Tecnicamente, sim: a cadeia é a mesma para qualquer par de idiomas. Dublar para o persa acrescenta um problema próprio do idioma na etapa de voz, porque a escrita não registra as vogais breves nem o ezāfe, e a pronúncia precisa ser inferida pelo contexto. A cobertura dos serviços mais conhecidos é desigual: em setembro de 2026, a página de ajuda da dublagem automática do YouTube lista o farsi como idioma de origem dublado para o inglês, e vídeos em inglês não aparecem como dubláveis para o farsi.
A dublagem com IA acompanha o movimento dos lábios?
Não necessariamente, e nem sempre é preciso. A pesquisa sobre isocronia define esse objetivo: uma nova fala alinhada no tempo com o vídeo original, incluindo movimentos da boca, pausas e gestos. O grau de sincronia é uma escolha de design. A dublagem fora de cena exige uma sincronização menos rigorosa do que dublar um falante cuja boca está visível, e um grande estudo sobre dublagem humana profissional defende que a naturalidade vocal e a qualidade da tradução importam mais do que as restrições de sincronia labial geralmente enfatizadas.
Por que uma dublagem com IA às vezes tem silêncio ou uma voz diferente?
Uma das causas é um provedor de fala falhar no meio da tarefa. Um pipeline fixado num único provedor mantém as vozes consistentes, mas pode deixar lacunas durante uma queda; um pipeline com cadeia de fallback preenche a fala com uma voz um pouco diferente. A Booq passou do primeiro design para o segundo depois que uma queda gerou dublagens com silêncio onde faltavam falas. O silêncio também pode começar antes, quando o reconhecimento descarta um falante e não sobra nada para traduzir.
Como avaliar o reconhecimento de fala em persa?
No seu próprio áudio, e não apenas em fala lida e limpa. Inclua sotaques regionais, vozes de crianças, vários falantes e som de filme ou de talk show, todas condições em que o PSRB encontrou mais erros, além de fala informal. Normalize o ZWNJ e as formas árabe e persa das letras yeh e kaf antes de calcular a pontuação, ou use uma métrica ponderada por substituição como o SW-WER, e leia os erros, não só a taxa: um único número não distingue um deslize de espaçamento de uma frase fluente que o falante nunca disse.
Se você está avaliando desenvolver um sistema de fala ou de dublagem, o serviço de IA de fala cobre pipelines de TTS, ASR e dublagem, incluindo os casos difíceis do persa.
Fontes
Booq: tradução e dublagem de vídeo com IA, com foco no persa, estudo de caso neste site
Pesquisa em síntese de fala em persa para a MCI, estudo de caso neste site
Sedghiyeh et al., PSRB: A Comprehensive Benchmark for Evaluating Persian ASR Systems, arXiv, 2025 (texto completo)
Federico et al., From Speech-to-Speech Translation to Automatic Dubbing, arXiv, 2020
Chronopoulou et al., Jointly Optimizing Translations and Speech Timing to Improve Isochrony in Automatic Dubbing, arXiv, 2023
Lakew et al., Isometric MT: Neural Machine Translation for Automatic Dubbing, ICASSP 2022
Virkar et al., Prosodic Alignment for off-screen automatic dubbing, arXiv, 2022
Brannon, Virkar e Thompson, Dubbing in Practice: A Large Scale Study of Human Localization With Insights for Automatic Dubbing, TACL, 2023
Ajuda do YouTube, Use automatic dubbing, consultado em setembro de 2026
Park et al., A Review of Speaker Diarization: Recent Advances with Deep Learning, Computer Speech & Language, 2022
Ryant et al., The Third DIHARD Diarization Challenge, arXiv, 2020
Rahmati e Sameti, GE2PE: Persian End-to-End Grapheme-to-Phoneme Conversion, Findings of EMNLP 2024
Doostmohammadi et al., Persian Ezafe Recognition Using Transformers and Its Role in Part-Of-Speech Tagging, arXiv, 2020
Ranjbar Kalahroodi, Faili e Shakery, ParsVoice: A Large-Scale Multi-Speaker Persian Speech Corpus for Text-to-Speech Synthesis, EMNLP 2026 (aceito; arXiv v4, setembro de 2026)
Google, Site Reliability Engineering: Addressing Cascading Failures
Google, Site Reliability Engineering: Data Integrity: What You Read Is What You Wrote
Grupo de trabalho HTTP do IETF, Resumable Uploads for HTTP, Internet-Draft
Pete Hodgson, Feature Toggles (aka Feature Flags), martinfowler.com, 2016, revisado em 2017