
Архитектура пайплайна ИИ-дубляжа: уроки продакшена
Как устроен пайплайн ИИ-дубляжа в продакшене: четыре этапа с моделями, подводные камни персидского и фолбэк провайдеров, заменивший тишину после сбоя.
Пайплайн ИИ-дубляжа выстраивает в цепочку четыре этапа, на которых работают модели: транскрипцию с определением говорящих, перевод, который укладывается в тайминг оригинала, отдельный голос для каждого говорящего и выравнивание тайминга с финальным сведением. Модели — та часть, которую можно арендовать. Продолжат ли дубляжи выходить, зависит от платформы вокруг них: отдельного шлюза для каждого ИИ-провайдера с автоматическим переключением на резервного провайдера (фолбэком), персистентных очередей, работы, которая продолжается после падения, цены, показанной до запуска задачи, и возврата денег, если задача не выполнена. В Booq, где я технический директор (CTO), сбой у провайдера, отвечавшего за речь, однажды привёл к дубляжам с тишиной на месте недостающих реплик. Теперь при отказе речь переключается по цепочке провайдеров: немного другой голос лучше тишины.
Как работает пайплайн ИИ-дубляжа: четыре этапа
Исследования автоматического дубляжа описывают похожую цепочку. Federico и соавторы (2020) взяли за основу пайплайн перевода речи в речь (speech-to-speech translation) и добавили то, что нужно дубляжу:
Машинный перевод, который выдаёт текст желаемой длины.
Просодическое выравнивание: сопоставление фраз и пауз перевода с сегментами исходной речи.
Синтез речи (TTS) с точной подстройкой длительности каждого высказывания.
Рендеринг звука, который добавляет фоновый шум и реверберацию, извлечённые из исходной аудиодорожки.
Если в видео несколько человек, нужно ещё знать, кто из них говорит.
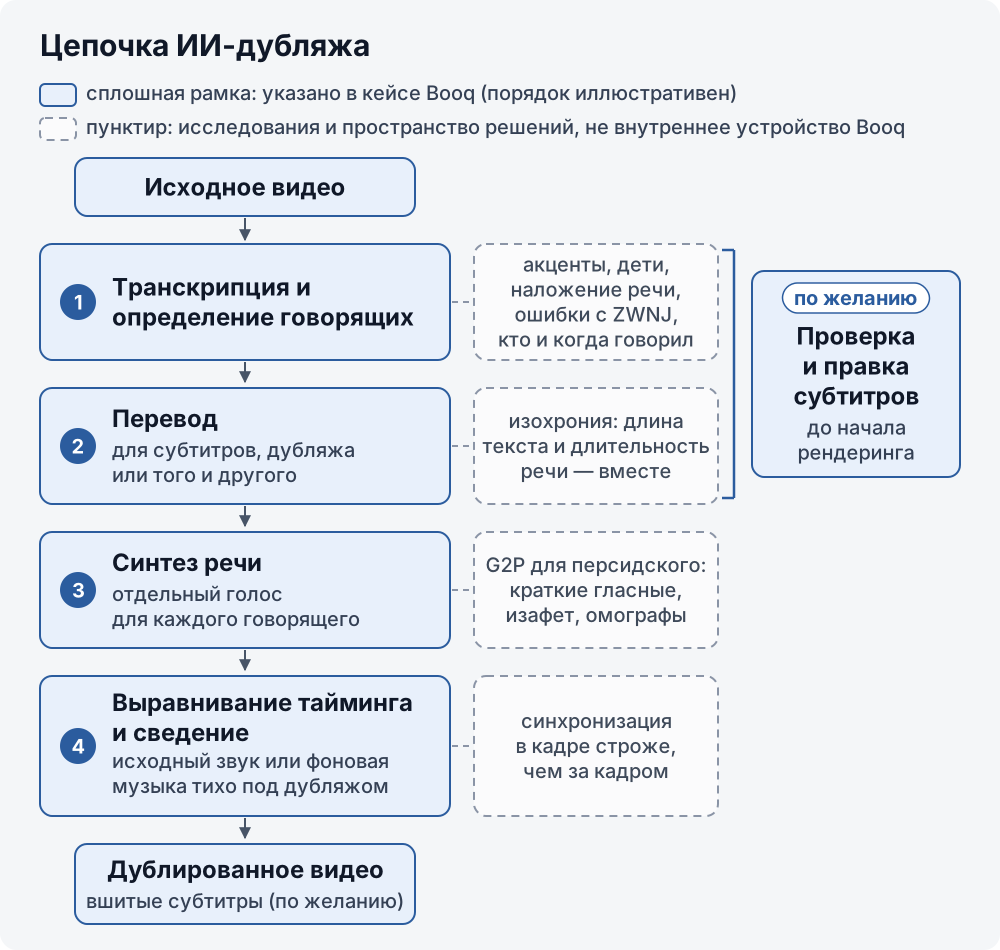
Открыть схему цепочки в полном размере

Разделы об этапах ниже описывают исследования и пространство проектных решений: какую задачу должен решить каждый этап и где он ломается. Внутреннее устройство какого-либо продукта, включая Booq, они не описывают. Там, где в них появляется Booq, приводится только то, что говорит его кейс, а раздел о персидском произношении опирается на моё собственное исследование синтеза речи. Разделы о платформе — из первых рук.
Этап 1: транскрипция и определение говорящих
Все последующие этапы наследуют транскрипт. Слово, которое выдумал распознаватель, переводится, озвучивается и укладывается в тайминг так же уверенно, как слово, которое говорящий действительно произнёс. Для персидского самое полезное из публично доступных свидетельств того, где ошибается автоматическое распознавание речи (ASR), — PSRB, бенчмарк, опубликованный в 2025 году.
Где ошибается распознавание персидской речи
PSRB оценивает десять систем ASR, коммерческих и с открытым исходным кодом. Общий вывод авторов: модели в целом хорошо справляются со стандартным персидским, но испытывают трудности с региональными акцентами, детской речью и отдельными лингвистическими сложностями. Подробности читаются как описание того самого аудио, которое люди хотят дублировать:
Акценты. Из 12 акцентов, вошедших в оценку, точность распознавания была ниже всего у мешхедского и йездского.
Дети. Хуже всего распознавалась речь детей.
Несколько говорящих. Все модели ошибались на аудио с несколькими говорящими чаще, чем на аудио с одним. Главной трудностью в таком аудио авторы называют наложение речи — хотя в самом бенчмарке наложение было сведено к минимуму, — а некоторые модели иногда целиком выпускали из транскрипта одного из говорящих.
Жанр. Меньше всего ошибок было на аудиокнигах. Ток-шоу, анимация и фильмы, где часты спонтанные диалоги, наложение речи и фоновый шум, показали существенно худшие результаты.
Регистр. Речь в бенчмарке на 71,3% неформальная.
В статье названы и типы ошибок, характерные именно для персидского письма и речи:
Границы слов. Множественное число درختها («деревья») пишется с несоединителем нулевой ширины (ZWNJ). Ошибки возникают, когда ZWNJ пропущен или заменён: درخت ها или درختها.
Смена регистра. Разговорное میخوام برم («хочу пойти») может вернуться в формальном виде میخواهم بروم, или наоборот.
He-Kasreh. Краткий /e/, обозначающий принадлежность или связь, может быть записан буквой he (ه): کتاب او («его книга») может превратиться в транскрипте в کتابه او. Это изафет, выписанный буквами, — тот самый не обозначаемый на письме звук, к которому вернётся этап 3.
Перефразирование. خوش میگذره («это приятно») может стать حال میده («от этого хорошо»). Смысл сохраняется, слова — нет.
Галлюцинации. Гладкий, связный текст, который вообще не основан на аудио.
Обычный WER (word error rate, доля ошибочных слов) считает любую замену целиком неверным словом, поэтому промах с ZWNJ может стоить столько же, сколько другое слово, или даже больше: если ZWNJ превращается в пробел, одно слово становится двумя, а это засчитывается как замена плюс вставка. PSRB предлагает вариант со взвешиванием замен — SW-WER: для каждой замены вычисляется доля ошибок на уровне символов и умножается на число слов в этом выравнивании, так что ошибка в пробеле обходится дешевле, чем другое слово. Поиску по персидскому тексту приходится нормализовать те же символы, как объясняется в статье о гибридном поиске для персидского RAG.
Вывод для проектирования, как я его понимаю: аудио, которое люди хотят дублировать, — ровно то, на чём распознавание слабее всего, а галлюцинированная или перефразированная реплика не остаётся в транскрипте. Она становится уверенно озвученной репликой. Это довод в пользу точки проверки перед рендерингом. Booq предлагает оба режима: запуск без участия человека или паузу, чтобы проверить и отредактировать субтитры до того, как что-либо будет отрендерено.
Диаризация: кто и когда говорил
Park и соавторы определяют диаризацию говорящих (speaker diarization) как задачу установить, «кто и когда говорил». В дубляже от неё зависит, какой голос получит каждая реплика. Третий конкурс по диаризации DIHARD (The Third DIHARD Diarization Challenge) оценивал системы в 11 разнородных доменах и пришёл к выводу, что для многих из них, включая веб-видео, задача «ещё далека от решения».
Проверка, которую я поставил бы после диаризации в любом пайплайне, простая: у каждого ли обнаруженного говорящего есть реплики и у каждой ли реплики есть говорящий? Некоторые системы в PSRB выбрасывали из транскрипта целого говорящего, а потерянный говорящий превращается в отсутствующую голосовую дорожку.
Этап 2: перевод, который укладывается в хронометраж
Дубляж добавляет к переводу ограничение: новую реплику нужно произнести примерно за то же время, что и исходную. Переведите свободно — и либо синтетическому голосу придётся торопиться, либо реплика наедет на следующую.
Изохрония: длина текста и длительность речи — одна задача
В исследованиях это называют изохронией (isochrony). Chronopoulou и соавторы (2023) описывают её как новую речь, выровненную по времени с исходным видео, «включая движения рта, паузы, жесты рук». Они обучают модель, которая оптимизирует перевод и длительность его речи совместно, и сообщают, что по сравнению с предыдущими работами речь лучше совпадает с таймингом оригинала, а архитектура получается проще.
Более ранние работы управляли длиной на уровне текста. Isometric MT (Lakew и соавторы, ICASSP 2022) в качестве примера цели приводит перевод в пределах ±10% от длины исходного текста в символах и честно называет цену: контроль длины выхода снижает качество перевода, и обычно это смягчают, генерируя несколько вариантов перевода (гипотезы N-best) и затем переранжируя их. Цифра ±10% — пример из одной статьи, а не отраслевое правило, и число символов лишь косвенно показывает, сколько времени занимает произнесение реплики.
Когда темп сбит, это слышно. Справка YouTube об автоматическом дубляже называет темп речи среди причин, по которым видео может не подойти для дубляжа: слишком быстрая исходная речь «привела бы к ускоренному дубляжу, который невозможно слушать».
Насколько строгим должен быть тайминг?
Строже, когда говорящий в кадре, чем за кадром, и, судя по профессиональной практике, не так абсолютно, как это часто трактуют исследования. Brannon, Virkar и Thompson (TACL 2023) изучили, как дублируют люди, на материале 319,57 часа видео из 54 тайтлов профессионального производства. Их результаты ставят под сомнение ряд допущений, распространённых в литературе как о дубляже, который делают люди, так и об автоматическом дубляже. Авторы доказывают, что естественность голоса и качество перевода важнее изометрических ограничений (по длине в символах) и синхронизации с губами (lip-sync), на которых обычно делают акцент, и призывают более взвешенно оценивать, насколько важны ограничения по таймингу.
Важно и то, виден ли говорящий. Virkar и соавторы (2022) распространили свою модель просодического выравнивания на дубляж вне кадра (off-screen dubbing), который «требует менее строгих ограничений синхронизации», чем дубляж говорящего, чей рот виден. Поэтому бюджет по таймингу — решение для каждой сцены, а не одна глобальная настройка.
О Booq опубликовано одно утверждение: тайминг выравнивается по оригиналу. Больше кейс о тайминге ничего не говорит, и больше я здесь не утверждаю.
Этап 3: отдельный голос для каждого говорящего
В Booq каждый обнаруженный говорящий получает отдельный голос. Любому дубляжу с несколькими говорящими нужны от голосов два свойства. Два говорящих не должны звучать похоже, а у одного говорящего голос должен оставаться тем же от первой реплики до последней. Запомните второе: постмортем ниже рассказывает о том, как это свойство проиграло.
Открытых персидских речевых данных мало. Авторы ParsVoice пишут, что персидский «по-прежнему существенно недопредставлен в открытых речевых и текстовых ресурсах». Их корпус включает готовое для TTS подмножество на 2 200 часов — более чем в 25 раз больше крупнейшего из ранее доступных открытых наборов данных для персидского TTS. Данные — одно ограничение. Второе возникает ещё до появления какого-либо звука: нужно решить, как произносится текст.
Персидское произношение: краткие гласные, изафет и омографы
С июня 2021 по сентябрь 2022 года я занимался исследованиями синтеза персидской речи. Их заказал и курировал MCI (Hamrah-e Aval), крупнейший мобильный оператор Ирана, а управлял ими Национальный фонд элит (National Elites Foundation) в рамках своей программы имени Шахида Ахмади Рошана (Shahid Ahmadi Roshan). Самой трудной была лингвистическая часть. В том пайплайне написанный текст сначала проходит преобразование графем в фонемы (G2P), которое решает, как его произносить. Затем модель синтеза речи и вокодер создают речь; вокодер — компонент, который превращает акустический выход модели в звуковую волну. Персидское письмо делает первый шаг неоднозначным в трёх отношениях:
Краткие гласные не пишутся, поэтому сам текст не определяет произношение.
Изафет тоже не пишется, и его приходится выводить.
Омографы — разные слова с одним написанием, и без контекста их не различить.
Опубликованные исследования говорят то же самое. Авторы GE2PE (Findings of EMNLP 2024) описывают изафет как звук /e/, связывающий существительные с прилагательными и описательными существительными, и приводят пример омографов: /kerm/, /kerem/ и /karam/ на письме выглядят одинаково — کرم. Они заключают, что персидскому G2P для приемлемых результатов нужен вход на уровне фразы или предложения. Doostmohammadi и соавторы (2020) добавляют, что изафет в персидском письме почти никогда не обозначается, из-за чего возникают ошибки при чтении сложных предложений и при обработке языка. Сам проект описан в кейсе об исследовании синтеза персидской речи.
Вывод для проектирования — мой собственный, а не результат этих статей: не подавайте персидскому TTS фрагменты, на которые нарезана дорожка субтитров. Граница субтитра может разрезать изафетную цепочку или отделить омограф от слов, снимающих его неоднозначность. Если фраза ketāb-e dust-e man («книга моего друга») разрезана между двумя субтитрами и первый фрагмент заканчивается на ketāb, в этом фрагменте не остаётся ничего, что указывало бы на изафетное /e/ после ketāb. Синтезируйте предложения целиком, а затем подгоняйте звук под таймлайн.
Этап 4: выравнивание тайминга и финальное сведение
Последний этап превращает отдельные клипы в звуковую дорожку, которая принадлежит видео. В пайплайне Federico рендеринг добавляет фоновый шум и реверберацию, извлечённые из исходного аудио, чтобы новый голос звучал в той же акустической обстановке, что и изображение.
В Booq на выходе могут быть стилизованные вшитые субтитры для вертикального и широкоэкранного видео, а исходный звук или фоновая музыка тихо остаются под дубляжом. Вшитые субтитры — часть изображения, поэтому их компоновку нужно определить для каждого соотношения сторон до рендеринга; никакой плеер потом этого не исправит.
К этому этапу относятся два проектных вопроса. Первый — что делать с репликой, синтезированный звук которой и после перевода всё ещё слишком длинный. Исследования и практика предлагают три рычага, и выбор между ними — проектное решение, а не научный результат:
Сократить реплику ещё при переводе. Здесь работают Isometric MT и модели, которые совместно оптимизируют перевод и длительность.
Подстроить длительность каждого высказывания в TTS. В пайплайне Federico длительность подстраивается для каждого высказывания.
Ускорить голос, в разумных пределах. Этот рычаг идёт от практики, а не от исследований, и работает лишь до определённого предела: справка YouTube предупреждает, что ускоренный дубляж может стать невозможно слушать.
Второй вопрос — что слышит слушатель там, где реплики нет. Он оказался архитектурным, а не звуковым.
Платформа вокруг моделей
Всё, о чём шла речь выше, — исследования, которые можно прочитать, и модели, которые можно арендовать. В Booq каждая возможность зависит от внешних ИИ-провайдеров, и любой из них может отказать или измениться независимо от остальных. Как CTO я определил архитектуру Booq и довёл её от первого коммита до продакшена; платформа описана в кейсе Booq. Все уроки из его постмортема относятся к тому, что вокруг моделей, а не внутри них.
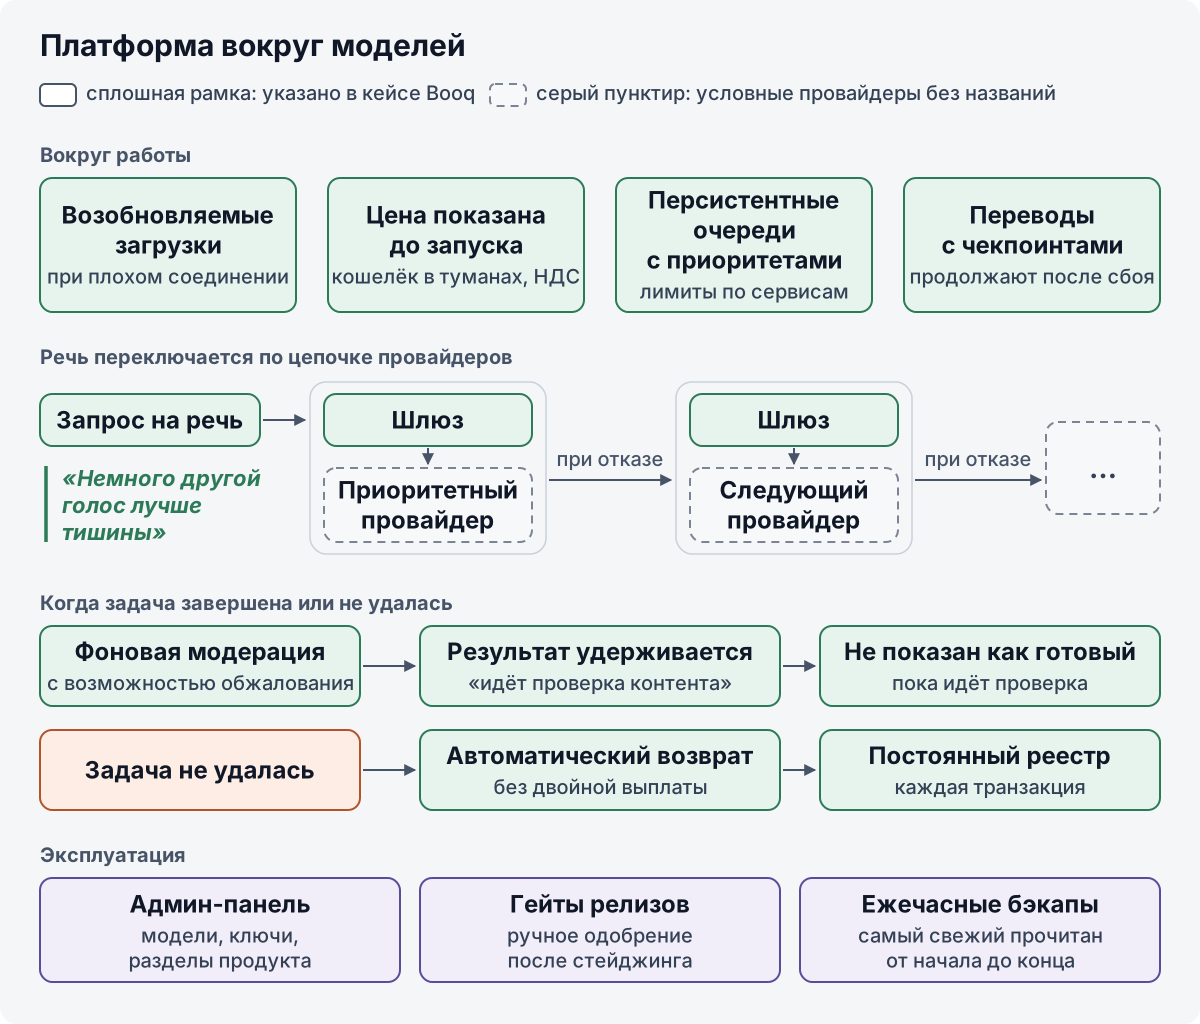
Открыть схему платформы в полном размере

Отдельный шлюз для каждого ИИ-провайдера
Booq — это набор независимых сервисов за одним веб-приложением, с отдельным шлюзом для каждого ИИ-провайдера. Именно это решение позволяет сменить модель, ротировать ключ или автоматически обойти отказавшего провайдера, не затрагивая остальной продукт. Модели и ключи провайдеров меняются из админ-панели, без повторного деплоя. В кейсе каждый шлюз описан вместе с автоматическим фолбэком, а постмортем ниже показывает, зачем он понадобился для речи.
Персистентные очереди с приоритетами и чекпоинты
Дубляжу длинного видео не место внутри веб-запроса. В Booq тяжёлая обработка вместо этого ждёт в персистентных очередях с приоритетами и лимитами для каждого сервиса. Именно лимиты на уровне сервиса не дают одному загруженному сервису оставить без ресурсов остальные.
Переводы сохраняют чекпоинты и после падения продолжают с того места, где остановились. Без чекпоинтов падение ближе к концу длинного транскрипта повторяет все сделанные до него вызовы провайдера, и за каждый из них приходится платить снова.
Возобновляемые загрузки при нестабильном соединении
Большие видеофайлы попадают в Booq по нестабильным соединениям, и загрузки, в том числе многогигабайтные, при плохой сети возобновляются, а не начинаются заново.
Общий механизм сейчас стандартизируется. Resumable Uploads for HTTP — действующий черновик (Internet-Draft) рабочей группы HTTP в IETF, ещё не RFC: если сервер может сообщить, сколько данных он обработал до обрыва, клиент продолжает с этого места, а не отправляет всё заново. Это ещё незавершённая работа, а не описание реализации в Booq.
Цена до запуска, возврат денег при сбое
Биллинг — часть пайплайна. Каждая задача в Booq показывает свою цену или начальную оценку до запуска. Кошелёк пополняется заранее в туманах, НДС показывается сразу, каждая транзакция попадает в постоянный реестр, а за неудавшуюся задачу деньги возвращаются автоматически. Возвраты защищены от двойной выплаты.
Последнее свойство заслуживает самого жёсткого тестирования: повторная попытка после тайм-аута — как раз тот момент, когда наивно реализованный возврат выплачивается дважды.
Переключатели вместо релизов
Разделы продукта в Booq включаются и выключаются без релиза. В классификации фиче-флагов (feature toggles) Пита Ходжсона это близко к ops toggle — операционному переключателю, который позволяет операторам быстро отключить функцию в продакшене или урезать её работу.
В том же духе разделён доступ. Клиенты, администраторы и сотрудники поддержки пользуются отдельно развёрнутыми приложениями, вход в одно из них не действует в другом, а консоли требуют второго фактора и разграничивают права по ролям.
Постмортем: как единообразие голоса проиграло тишине
Речь в Booq сначала намеренно была привязана к одному провайдеру, потому что другой провайдер означает другой голос. В дубляже единообразие казалось тем свойством, которое нужно защищать. Потом у этого провайдера случился сбой, и дубляжи собирались с тишиной на месте недостающих реплик.
Теперь при отказе речь переключается по цепочке провайдеров, по принципу «немного другой голос лучше тишины».
Как осознанно спроектировать цепочку фолбэка
Исходный выбор не был небрежным: он защищал реальное свойство. Кейс подытоживает смены курса, к которым привела эксплуатация платформы в продакшене: каждая из них «меняла удобное допущение на более безопасное поведение по умолчанию». Урок в том, чтобы решить, какой сбой вы готовы принять, до того как за вас это решит авария. Когда приоритетный провайдер речи недоступен, пайплайн может оставить пропуск, завершить задачу с ошибкой и вернуть деньги или взять другой голос. Только пропуск отдаёт слушателю дубляж с дырами.
Отсюда следует второе решение, и дальше — мой анализ, а не описание Booq: какой объём заменяет фолбэк. Если на другого провайдера переключается только недостающая реплика, голос этого говорящего меняется посреди сцены. Если переключается вся дорожка говорящего, дубляж остаётся единообразным, но переделывать приходится больше.
В книге Google по SRE описана родственная идея для перегруженных сервисов — плавная деградация (graceful degradation): делать меньше работы, снижая качество ответов. К дубляжу применимо предупреждение из той же книги: «путь в коде, которым вы никогда не пользуетесь, — это путь, который (часто) не работает», и её совет регулярно прогонять деградированный режим. Что я добавил бы к любой цепочке речевого фолбэка — как рекомендацию, а не как описание Booq, — это тестовые задачи по расписанию на внутренних клипах через каждого провайдера цепочки, чтобы было известно, что фолбэк работает, ещё до того, как он понадобится во время аварии.
Какой сбой правильный, зависит от продукта. Ассистент на этом сайте поступает наоборот: если ответ на вопрос ничем на сайте не подкреплён, он отвечает фиксированным отказом, а не догадкой, и если при этом он не считает, что вопрос касается меня, языковая модель вообще не вызывается. В вопросно-ответной системе промолчать — безопасный сбой, потому что уверенный неверный ответ хуже, чем отсутствие ответа. Эта схема описана в статье о гардрейлах против галлюцинаций в RAG, и на том же правиле построена страница лаборатории «RAG против без RAG». В дубляже тишина и есть сбой. Какой сбой допустим — решение о продукте, а не о модели.
Модерация, которая не заставляет пользователя ждать
Проверка контента в Booq раньше выполнялась прямо при создании проекта, поэтому пользователи ждали между завершённой загрузкой и страницей своего проекта. Теперь она идёт в фоне. Проверяются изображения, видео, аудио и текст, решение можно обжаловать, а готовый результат удерживается в статусе «идёт проверка контента», пока проверка не завершится. Результат не показывается как готовый, пока его проверка ещё идёт.
Этот паттерн переносится на любую медленную проверку в медиапайплайне: уберите её с пути запроса и сделайте промежуточное состояние явным.
Гейты релизов и бэкапы, которые кто-то прочитал
Деплой в продакшен в Booq перешёл с автоматического на ручное одобрение, которое становится доступным только после прохождения проверок на стейджинге. Каждый релиз проходит сборку, тесты, развёртывание на стейджинге и smoke-тест, прежде чем человек одобрит его для продакшена, а экстренный откат на предыдущую версию можно запустить вручную. Платформа работает на контейнерном кластере, описанном как код.
Бэкапы стали ежечасными, а самый свежий из них был прочитан от начала до конца, потому что бэкап, который никто ни разу не прочитал, — не бэкап. Книга Google по SRE говорит об этом ещё прямее: «Никто на самом деле не хочет делать бэкапы; чего люди действительно хотят, так это восстановления». Она же ставит планку выше: вы знаете, что можете восстановить недавнее состояние, только если действительно это делаете, поэтому тесты восстановления стоит по возможности автоматизировать и запускать непрерывно. Прочитать бэкап от начала до конца — это минимум, а не финишная черта.
Чек-лист: вопросы к любому пайплайну ИИ-дубляжа, своему или купленному
Отказы и фолбэк
Когда речевой провайдер отказывает посреди задачи, что получает слушатель: тишину, другой голос или неудавшуюся задачу с возвратом денег? Решите это до того, как решит авария.
Когда фолбэк всё-таки срабатывает, заменяет ли он одну реплику или всю дорожку говорящего?
Проверяется ли путь фолбэка намеренно, тестовыми задачами по расписанию, или только во время аварий?
Платформа и биллинг
Стоит ли каждый ИИ-провайдер за собственным шлюзом, чтобы смена модели, ротация ключа или обход провайдера не требовали релиза?
Выполняется ли тяжёлая работа из персистентных очередей с лимитами для каждого сервиса, вне веб-запроса?
Может ли длинный перевод продолжиться с чекпоинта, а большая загрузка — возобновиться после обрыва соединения?
Показывается ли цена или оценка до запуска задачи, и исключено ли, что возврат будет выплачен дважды?
Вынесена ли модерация с пути запроса и есть ли явное состояние «на проверке»?
Распознавание, тайминг и голоса
Проверено ли распознавание на вашем собственном аудио: акценты, дети, разговорная речь, несколько говорящих, звук фильмов и ток-шоу, а не только аудиокниги?
Засчитывает ли ваш подсчёт WER ошибку в пробеле с ZWNJ как целиком неверное слово? Сначала нормализуйте текст или используйте взвешенную метрику, например SW-WER.
Есть ли после диаризации у каждого обнаруженного говорящего реплики и голос?
Есть ли точка, где можно проверить и отредактировать субтитры до рендеринга?
Насколько строгим должен быть тайминг для этого контента: лица в кадре или закадровое повествование?
Получает ли персидский TTS целые предложения, а не фрагменты субтитров, разрезающие изафетную цепочку?
Релизы и восстановление
Одобряет ли человек выкладку в продакшен после проверок на стейджинге и smoke-тестов, и можно ли откатиться вручную?
Читал ли кто-нибудь бэкап от начала до конца?
Частые вопросы
Как работает ИИ-дубляж?
Пайплайн ИИ-дубляжа транскрибирует исходную речь и определяет, кто говорит, переводит каждую реплику так, чтобы её можно было произнести примерно за исходное время, назначает каждому говорящему отдельный синтетический голос, а затем выравнивает тайминг и сводит новую речь с исходным фоном. В продакшене эти этапы работают внутри платформы из очередей, шлюзов провайдеров с фолбэком и, в идеале, точки проверки перед рендерингом.
Может ли ИИ дублировать видео с английского на персидский?
Технически да: цепочка одна и та же для любой языковой пары. Дубляж на персидский добавляет на этапе голоса проблему, специфичную для языка: письмо не передаёт краткие гласные и изафет, поэтому произношение приходится выводить из контекста. Поддержка в массовых сервисах неравномерна: по состоянию на сентябрь 2026 года справка YouTube об автоматическом дубляже указывает фарси как исходный язык, который дублируется на английский, а английские видео как доступные для дубляжа на фарси там не указаны.
Синхронизирует ли ИИ-дубляж речь с движением губ?
Не обязательно, и не всегда это нужно. Исследования изохронии ставят именно такую цель: новая речь, выровненная по времени с исходным видео, включая движения рта, паузы и жесты. Насколько точно добиваться совпадения — проектный выбор. Дубляж вне кадра требует менее строгой синхронизации, чем дубляж говорящего, чей рот виден, а крупное исследование профессионального дубляжа, который делают люди, доказывает, что естественность голоса и качество перевода важнее ограничений синхронизации с губами, на которых обычно делают акцент.
Почему в ИИ-дубляже иногда бывает тишина или другой голос?
Одна из причин — отказ речевого провайдера посреди задачи. Пайплайн, привязанный к одному провайдеру, сохраняет единообразие голосов, но во время аварии может оставлять пропуски; пайплайн с цепочкой фолбэка заполняет реплику немного другим голосом. Booq перешёл от первой схемы ко второй после сбоя, из-за которого получились дубляжи с тишиной на месте недостающих реплик. Тишина может возникнуть и раньше по цепочке, когда распознавание теряет говорящего и переводить становится нечего.
Как оценивать распознавание персидской речи?
На собственном аудио, а не только на чистой начитанной речи. Включите региональные акценты, детские голоса, запись с несколькими говорящими и звук фильмов или ток-шоу — во всех этих условиях PSRB зафиксировал больше ошибок, — а также разговорную речь. Перед подсчётом нормализуйте ZWNJ, а также арабские и персидские формы букв йе и каф, или используйте метрику со взвешиванием замен, например SW-WER, и читайте сами ошибки, а не только их долю: одно число не отличает ошибку в пробеле от гладкого предложения, которого говорящий никогда не произносил.
Если вы взвешиваете разработку речевой системы или системы дубляжа, услуга «Речевой ИИ» охватывает TTS, ASR и пайплайны дубляжа, включая трудные персидские случаи.
Источники
Booq: перевод и дубляж видео с помощью ИИ с упором на персидский, кейс на этом сайте
Исследование синтеза персидской речи для MCI, кейс на этом сайте
Sedghiyeh и др., PSRB: A Comprehensive Benchmark for Evaluating Persian ASR Systems, arXiv, 2025 (полный текст)
Federico и др., From Speech-to-Speech Translation to Automatic Dubbing, arXiv, 2020
Chronopoulou и др., Jointly Optimizing Translations and Speech Timing to Improve Isochrony in Automatic Dubbing, arXiv, 2023
Lakew и др., Isometric MT: Neural Machine Translation for Automatic Dubbing, ICASSP 2022
Virkar и др., Prosodic Alignment for off-screen automatic dubbing, arXiv, 2022
Brannon, Virkar и Thompson, Dubbing in Practice: A Large Scale Study of Human Localization With Insights for Automatic Dubbing, TACL, 2023
Справка YouTube, Use automatic dubbing, проверено в сентябре 2026 года
Park и др., A Review of Speaker Diarization: Recent Advances with Deep Learning, Computer Speech & Language, 2022
Ryant и др., The Third DIHARD Diarization Challenge, arXiv, 2020
Rahmati и Sameti, GE2PE: Persian End-to-End Grapheme-to-Phoneme Conversion, Findings of EMNLP 2024
Doostmohammadi и др., Persian Ezafe Recognition Using Transformers and Its Role in Part-Of-Speech Tagging, arXiv, 2020
Ranjbar Kalahroodi, Faili и Shakery, ParsVoice: A Large-Scale Multi-Speaker Persian Speech Corpus for Text-to-Speech Synthesis, EMNLP 2026 (принята; arXiv v4, сентябрь 2026 года)
Google, Site Reliability Engineering: Addressing Cascading Failures
Google, Site Reliability Engineering: Data Integrity: What You Read Is What You Wrote
Рабочая группа IETF HTTP, Resumable Uploads for HTTP, Internet-Draft
Pete Hodgson, Feature Toggles (aka Feature Flags), martinfowler.com, 2016, редакция 2017 года