
Защита от галлюцинаций в RAG: пятиуровневая схема
Пять слоёв защиты, которые мешают RAG-ассистенту выдумывать ответы: отказ до поиска, порог сходства, системный промпт, шлюз по предложениям и правила речи.
RAG (retrieval-augmented generation, генерация с опорой на результаты поиска) не мешает модели выдумывать ответы, а слабый контекст может сделать её увереннее, а не осторожнее. Гардрейлы (guardrails) — защита от галлюцинаций в RAG — живут в основном в коде вокруг модели. Стройте их как пять слоёв в фиксированном порядке — так работает ассистент этого сайта:
До поиска отклоняйте вопросы, на которые ассистент не должен отвечать никогда.
Давайте модели только такие свидетельства, по которым можно проверить её ответ: фрагменты, прошедшие порог сходства, или, для вопросов о работе в целом, собственные записи сайта. Если нет ни того ни другого, отказывайте без вызова модели.
Считайте системный промпт единственным слоем, который модель может проигнорировать.
Выдавайте ответ по одному предложению и только после детерминированных проверок.
Никогда не позволяйте ассистенту говорить от лица человека, который за ним стоит.
Схему завершает проверка расходов перед вызовом модели.
Я построил этот сайт и поддерживаю его, ассистента в том числе. Никакой цифры точности для него я не публикую — раздел об измерениях объясняет почему.
Почему RAG всё равно галлюцинирует
В системе RAG ретривер возвращает фрагменты текста из корпуса, а языковая модель пишет ответ по ним. Галлюцинация — это ложное или ничем не подкреплённое утверждение, поданное так, будто оно верно.
Поиск сужает круг того, что модель, скорее всего, скажет. Границ он ей не ставит.
Поиск может сделать модель увереннее, а не точнее
Исследователи Google разделили два случая: найденный контекст, которого для ответа достаточно, и контекст, которого недостаточно. Пересказывая свою статью, представленную на ICLR 2025, авторы не смягчают формулировок: «хотя RAG в целом улучшает общее качество работы, он парадоксальным образом снижает способность модели воздерживаться от ответа, когда это уместно». В одном из примеров Gemma без контекста давала неверные ответы на 10,2% вопросов, а при недостаточном контексте — на 66,1%.
Умение вовремя промолчать окупается: предложенный авторами метод селективной генерации поднял долю верных ответов среди случаев, когда модель отвечала, на 2–10% для Gemini, GPT и Gemma.
Поиск по top-k возвращает k фрагментов независимо от того, относится ли хоть один из них к делу. Если о достаточности этих фрагментов судит только модель, решение воздержаться остаётся за тем самым компонентом, который, как показывает это исследование, часто ошибается.
Модели получают награду за угадывание
Калаи (Kalai) и соавторы утверждают, что «языковые модели галлюцинируют, потому что процедуры обучения и оценки вознаграждают угадывание, а не признание неопределённости». Когда за «не знаю» баллов не дают, угадывание повышает оценку. Инструкция признавать неопределённость идёт против этого стимула. Она помогает. Механизмом контроля она не является.
Коммерческие юридические инструменты тоже галлюцинировали
Некоторые поставщики систем юридического поиска подавали RAG как способ «устранить» галлюцинации. Первая предварительно зарегистрированная оценка ИИ-инструментов для юридического поиска показала, что доля галлюцинаций у каждого из продуктов LexisNexis и Thomson Reuters составила от 17% до 33%. Что это значит для юридических продуктов, разобрано в статье о том, что строить против галлюцинаций юридического ИИ.
Пять слоёв защиты: общая картина
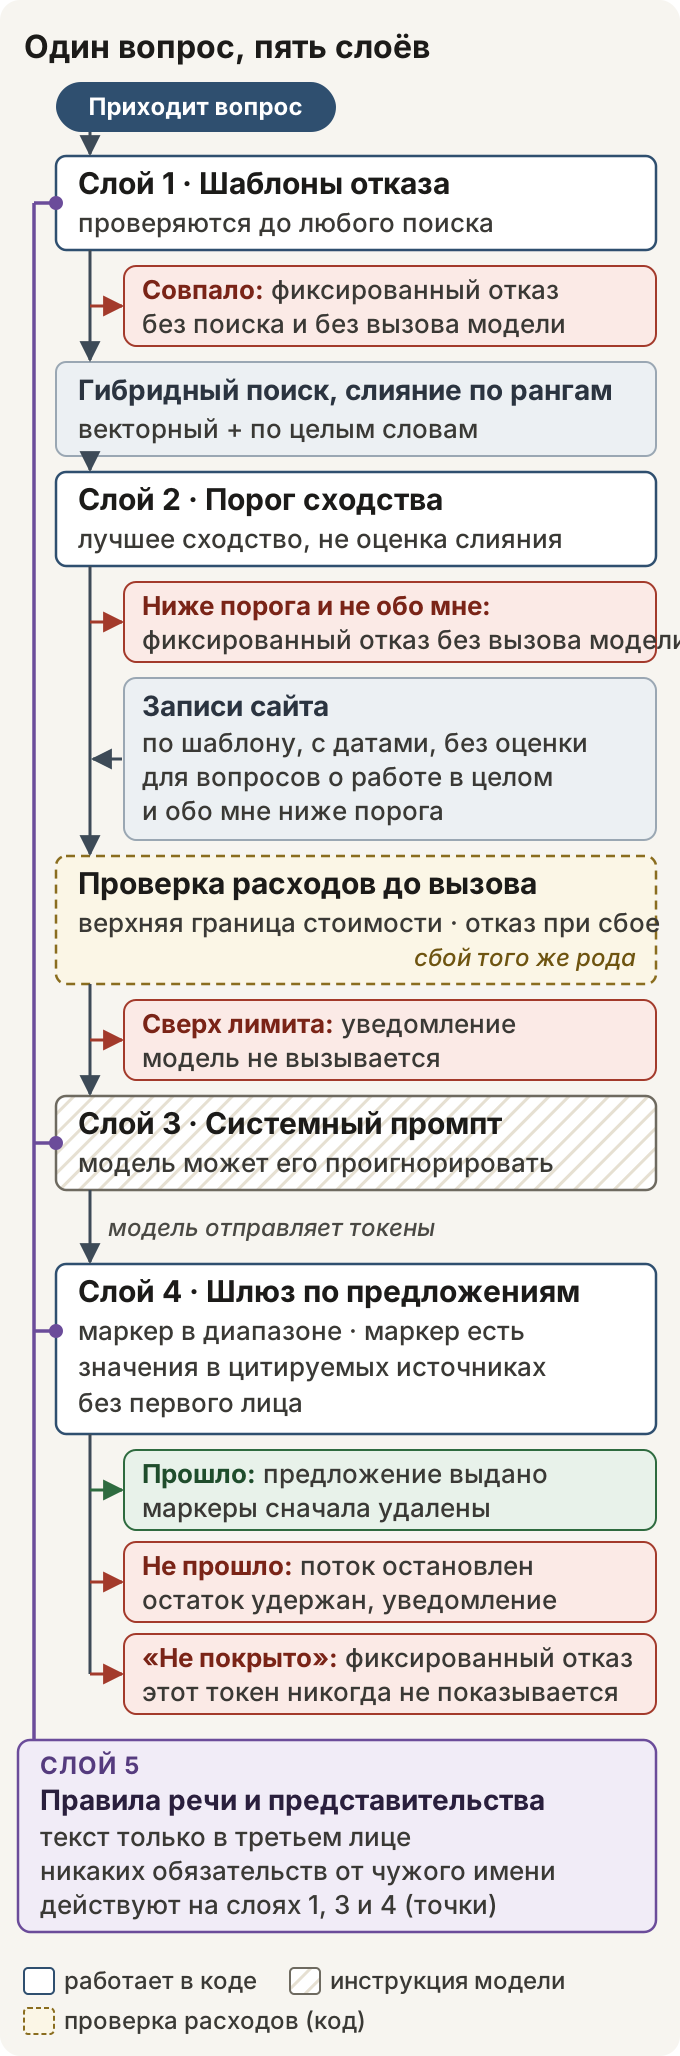
Слой | Что он останавливает | Где работает | Что происходит при срабатывании |
|---|---|---|---|
1. Шаблоны отказа | Ответы, которых ассистент давать не должен | Код | Фиксированный отказ до поиска |
2. Порог сходства | Ответы на слабых свидетельствах | Код | Фиксированный отказ, модель не вызывается |
3. Системный промпт | Нарушение правил, если модель подчиняется | Сама модель | Ничто само по себе его не обеспечивает |
4. Шлюз по предложениям | Утверждения без источника, выдуманные значения, первое лицо | Код | Поток останавливается, остаток удерживается |
5. Правила речи | Обязательства от чужого имени | Код и промпт | Через слои 1, 3 и 4 |
Порядок здесь важен не меньше самих слоёв. Оба слоя отказа выполняются до вызова языковой модели, а за промптом — единственным слоем, который зависит от готовности модели подчиниться, — следует детерминированная проверка. Проверка расходов, стоящая между порогом и промптом, выдумыванию не мешает, но относится к сбоям того же рода.
Слой 1: отказ до поиска
Первый сбой — это не отсутствующий ответ. Это ответ, которого не должно быть вовсе.
Вопросы, на которые корпус ответить может, а ассистент не должен
На этом сайте по вопросу об оплате поиск вернул бы страницу услуг. Текст релевантен, и ответить по нему — как раз ошибка: любая цифра, дата или обязательство, которые модель составит по этой странице, — это заявление, которого никто не делал. Релевантность — не разрешение.
Поэтому часть вопросов отклоняется до того, как что-либо будет превращено в вектор или найдено:
Условия сотрудничества: оплата, доступность для работы и наём.
Личные данные, которые сайт намеренно не публикует: номер телефона, домашний адрес, семейное положение или отношение к воинской службе, дата рождения.
Домыслы: прогнозы и сравнения с конкретными названными людьми.
Метазапросы, которые пытаются вытащить или переопределить инструкции.
Просьбы выполнить работу: написать код или текст, что-то перевести или решить — вместо вопроса об опубликованных работах.
Текст отказа фиксирован, это не вывод модели: отказ, сгенерированный моделью, — это отказ, от которого модель может сама себя и отговорить. Клиенты для модели эмбеддингов (той, что превращает текст в векторы) и для языковой модели создаются лениво, поэтому отказ на этом слое не делает ни одного внешнего вызова.
Для своей системы составьте список вопросов, правильный ответ на которые — «не от этого ассистента», что бы ни лежало в корпусе.
Шаблоны, а не классификатор
Набор отказов — это регулярные выражения для английского и персидского и списки фраз для остальных восьми языков сайта; все они применяются к нормализованному виду вопроса: регистр приведён к нижнему, арабские начертания букв — к персидским, персидские и арабские цифры — к латинским, арабские огласовки удалены, а невидимый разделитель нулевой ширины (ZWNJ) внутри персидских слов заменён пробелом. Вопрос проверяется ещё и с моим именем, прочитанным как местоимение, поэтому «Мохаммад Панахи свободен?» отклоняется так же, как «Он свободен?», а уточняющий вопрос проверяется вместе с предыдущим.
Это не классификатор. Классификатор, который прав в большинстве случаев, — всё равно обещание, которого этот сайт дать не может, потому что каждый его промах становится обязательством от чьего-то имени.
Ограничение очевидно: шаблоны не ловят перефразировки. Персидская орфография в число этих брешей не входит. Нормализация превращает разделитель нулевой ширины в пробел, поэтому слово, которое стандартная орфография пишет слитно, доходит до шаблонов разделённым надвое, а каждый персидский шаблон принимает обе формы — и с пробелом, и без него; так отклоняются и چقدر میگیرد, и چقدر میگیرد. Вопрос, заданный словами, которых в списке нет, всё равно пройдёт, и следующие слои существуют именно для него: промпт запрещает говорить об оплате и доступности для работы, а шлюз останавливает предложение, в котором есть знакомое ему слово в первом лице или цифра, которой нет в источниках. Это сужает зазор. Но не закрывает его. Списки для языков, кроме английского и персидского, короче, и перефразировки на них проходят чаще.
Слой 2: порог сходства, который отменяет вызов модели
После поиска ассистент берёт лучшее сходство между вопросом и фрагментами, которые он передал бы модели. Ниже порога вопрос, который не касается меня, отклоняется фиксированным текстом, и языковая модель не вызывается вовсе. Бесплатным этот отказ не назовёшь: в продакшене сторонний API уже превратил вопрос в вектор. Но вызов генерации он снимает, и слабое свидетельство не превращается в гладкий ответ. Вопросы обо мне идут другим путём, описанным ниже, потому что оценка сходства не отличает общий вопрос о чьей-то работе от постороннего.
Почему нельзя ставить порог на оценку RRF
Поиск здесь гибридный: плотный векторный поиск и поиск по ключевым словам с совпадением по целым словам, объединённые слиянием обратных рангов (reciprocal rank fusion, RRF). Как он справляется с персидским и английским, стоящими рядом, разобрано в статье гибридный поиск для персидского RAG.
RRF — хороший способ объединить ранжирования и плохое число для порога. В формулировке Кормака (Cormack), Кларка (Clarke) и Бюттхера (Büttcher) оценка документа — это сумма 1/(k + r(d)) по всем ранжированиям, где r(d) — его ранг в каждом списке, а значение k = 60 «было зафиксировано в ходе пилотного исследования». Оценка строится только из позиций, поэтому даже корпус из чистого шума даст документ на первом месте с лучшей из возможных итоговых оценок. Порог на этом числе измеряет ранг, а не релевантность.
Что порог сравнивает вместо этого
Каждый вид поиска, который может дать ограниченное сходство, его и сообщает:
Векторный поиск сообщает косинусное сходство, ограниченное диапазоном от 0 до 1. Порог использует сходство с вопросом в том виде, в каком он задан, а для уточняющего вопроса — ещё и с вопросом, соединённым с предыдущим. Если уточняющий вопрос сформулирован как позиция в списке, например «второй», к ним добавляется и тот пункт, на который он указывает: позиция читается из вопроса, список — из предыдущего ответа, по названиям и именам самого сайта или по тому, что ответ приводит в кавычках, и модели сообщается, о каком пункте речь. Пункт добавляется, только если и позицию, и список удаётся прочитать без сомнений; иначе вместо него добавляется начало предыдущего ответа. Проверяется формулировка, а не ответ: посторонний уточняющий вопрос, в котором случайно есть «второй», тоже получает начало ответа и может пройти порог; за ним по-прежнему стоят промпт и шлюз. Когда вопрос касается меня, поиск дополнительно ищет с добавленным моим именем. Это помогает упорядочить фрагменты, но никогда не учитывается в пороге: имя делает любой вопрос обо мне похожим на резюме, включая те, на которые сайт ответить не может.
Поиск по ключевым словам сообщает покрытие: долю значимых слов запроса длиной не менее трёх символов (в китайском — двух), найденных во фрагменте как целые слова. Частотные слова каждого языка сайта сначала отбрасываются, а покрытие учитывается в пороге, только если совпали хотя бы два разных значимых слова. Одно совпавшее слово — случайность. Для уточняющего вопроса, который говорит только о том, какой пункт имеется в виду, например «Расскажи подробнее о втором», значимые слова берутся из названия или имени, которое этому пункту даёт сам сайт.
За каждым фрагментом остаётся большее из двух значений, а порог сравнивается с лучшим из них по всем возвращённым фрагментам; фрагмент, который задаёт это значение, всегда среди них. Итоговая оценка слияния определяет только порядок.
Совпадение по целым словам важно. Если сопоставлять подстроки, «кран» найдётся внутри «экран», и у посторонних вопросов появляется видимость свидетельств. Если сервис эмбеддингов недоступен, поиск откатывается к одному лишь поиску по ключевым словам, и порог всё равно применяется.
Вопросы, на которые оценка сходства не отвечает
У вопроса «Чем он занимался в последнее время?» нет ближайшего соседа. Ответ на него — список, отсортированный по датам, и ни один фрагмент на такое не похож: на модели эмбеддингов этого сайта этот вопрос получил оценку ниже, чем вопрос о погоде. Поэтому вопросы о работе в целом распознаются шаблонами на каждом из десяти языков сайта, как и набор отказов. Это охватывает то, чем я занимаюсь сейчас или занимался недавно, мою карьеру, проекты, исследования, публикации, образование, навыки и услуги. На такие вопросы отвечают по записям сайта: записям из резюме, кейсов, статей и услуг, которые читаются из базы данных для каждого вопроса. Записи приходят на языке читателя, если есть перевод, а датированные упорядочены по собственным датам, от новых к старым.
Записи выбираются по правилу, а не по сходству, поэтому порог к ним не применяется. Больше ни от чего они не освобождены: шаблоны отказов срабатывают первыми, каждая датированная запись несёт свои даты с той точностью, с какой их показывает сайт, а каждое предложение, построенное на записи, проходит тот же шлюз.
Вопрос обо мне, который шаблоны не направляют к записям и который не подкреплён ни одним фрагментом, получает краткий обзор этих записей вместо отказа, потому что ошибочный отказ здесь сообщил бы читателю, что сайт не освещает то, что на нём есть. Если и записи на него не отвечают, модель по инструкции отвечает фиксированным токеном вместо текста, и читатель видит тот же фиксированный отказ. Так суждение модели становится ещё одним путём к отказу. Превратить отказ в ответ оно не может.
Как выбрать порог сходства для RAG
Универсального числа нет. Косинусное сходство зависит от модели эмбеддингов, от смеси языков и от корпуса, поэтому порог, подходящий одной модели, на другой может отклонять всё — или не отклонять ничего.
Проектное значение по умолчанию на этом сайте — 0,35, и набор тестов запускает с этим значением суррогатную модель эмбеддингов, то есть подставную модель, которая используется лишь в тестах. На рабочей модели эмбеддингов его пока не калибровали. Команда, которая выполняет только поиск, прогоняет через развёрнутую модель эмбеддингов вопросы золотого набора и предлагаемые сайтом вопросы, не вызывая модель, и рабочий порог меняется, только если этот прогон пройден. Это не то число, которое стоит копировать. Чтобы выбрать своё:
Прогоните вопросы, на которые ассистент обязан отвечать, и вопросы, в которых он обязан отказать, через ту модель эмбеддингов, которую разворачиваете, и сравните два распределения лучшего сходства.
Решите, сколькими вопросами с ответом вы готовы пожертвовать, чтобы остановить те, в которых нужен отказ. Там, где уверенный неверный ответ хуже, чем отсутствие ответа, ставьте порог выше.
Запишите, к какой модели эмбеддингов и к какому корпусу относится это число. Каждая новая страница в корпусе меняет то, с чем может совпасть посторонний вопрос, — эта статья в том числе.
Демо «RAG против без RAG» построено вокруг этой границы. Маршрута без опоры на источники в нём нет: вопрос, не связанный со мной и не подкреплённый ни одним фрагментом, останавливается, не доходя до языковой модели.
Слой 3: системный промпт — единственный слой, который модель может проигнорировать
И всё же промпт делает вполне реальную работу. Он требует от модели пользоваться только пронумерованными источниками, приложенными к вопросу; писать обо мне в третьем лице и на языке читателя; никогда не называть доступность для работы, оплату или сроки; никогда не выдумывать и не вычислять числа и даты; говорить «сейчас» только о том, что запись отмечает как текущее; заканчивать маркером источника каждое предложение, сообщающее факт; отвечать фиксированным токеном, когда источники не покрывают вопрос.
Обеспечить выполнение хоть чего-нибудь из этого он не может. Запись LLM07:2025 System Prompt Leakage в списке OWASP рекомендует держать гардрейлы вне модели: независимая система, которая проверяет вывод, «предпочтительнее инструкций в системном промпте». Руководство Anthropic по снижению числа галлюцинаций, где среди прочего модели разрешают сказать, что она не знает, столь же откровенно: «хотя эти приёмы существенно снижают число галлюцинаций, они не устраняют их полностью».
Поэтому промпт написан с допущением, что иногда его проигнорируют. Его задача — сделать выполнение правил самым простым путём, и у каждой инструкции с высоким риском есть детерминированный двойник:
Инструкция промпта | Детерминированный двойник |
|---|---|
Маркер источника в каждом предложении с фактом | Шлюз проверяет, что маркер есть и что он в допустимом диапазоне |
Никогда не выдумывать число | Каждое число, URL и адрес электронной почты должны встречаться в источнике, на который ссылается предложение |
Писать в третьем лице | Проверка на первое лицо в шлюзе |
Ни слова об оплате и доступности для работы | Шаблоны слоя 1, затем проверки значений и первого лица в шлюзе |
У одной инструкции полного двойника нет: «используй только то, что говорят источники» — для утверждения, в котором нет ни одного числа. Шлюз может потребовать для такого предложения корректный маркер. Решить, говорит ли это источник, он не может. Нет полного двойника и у правил о времени. Предложение, которое ставит два датированных события в неверном порядке или называет давнюю должность недавней, не содержит значения, которое шлюз мог бы проверить. Записи снижают этот риск, потому что приходят упорядоченными по датам и с отмеченными текущими позициями; устранить его они не могут.
Слой 4: проверка потока по одному предложению
Предложение, которое читатель уже прочёл, обратно не заберёшь. Документация NVIDIA NeMo Guardrails называет этот компромисс прямо: при включённом stream_first, а это значение по умолчанию, «если rail блокирует контент, пользователь уже получил токены». Этот сайт выбрал другую сторону. Текст удерживается до конца предложения, проверяется и только потом выдаётся — ценой примерно одного предложения задержки.
Каждое предложение проходит четыре проверки, и каждая из них — факт о строках, а не суждение о смысле:
Маркер в диапазоне: он указывает на источник, который действительно был передан.
Маркер присутствует в каждом содержательном предложении; короткое связующее предложение без значений проходит. Длина считается в словах, разделённых пробелами, кроме китайского, где пробелов нет: там каждые три иероглифа считаются за два слова.
Значения есть в цитируемых свидетельствах: каждое число, URL и адрес электронной почты встречается в источнике, на который ссылается предложение, причём персидские и арабские цифры перед сравнением приводятся к латинским.
Без первого лица — оно означало бы, что ассистент заговорил от моего имени.
При нарушении уже выданные предложения остаются, нарушившее предложение не отправляется никогда, а поток останавливается, и эта остановка отменяет генерацию на стороне провайдера. Читатель видит фиксированный текст о том, что остаток ответа не удалось подкрепить источниками этого сайта и потому он удержан. Маркеры проверяются, а затем удаляются, так что читатель видит связный текст, а не список литературы; у обрезанного ответа своё уведомление: прерванное предложение — не то же самое, что неподтверждённое.
«Подтверждено» не значит «верно». Значения сверяются с теми источниками, на которые ссылается предложение, а не с самим утверждением: предложение со ссылками на два источника может взять значение из любого из них, а предложение без значений проходит с любым маркером из допустимого диапазона. Шлюз не может показать, что утверждение верно, — и даже что процитированный фрагмент его содержит. Запись LLM09:2025 Misinformation в списке OWASP просит команды «автоматически проверять ключевые выходные данные»; это узкая детерминированная версия такой проверки. Как она устроена, разобрано в статье гардрейлы для стриминга LLM.
Слой 5: правила речи и представительства
Ассистент, который говорит от чьего-то имени, делает заявления за него
В деле Moffatt v. Air Canada (2024 BCCRT 149), о котором писали McCarthy Tétrault и Bristows, Трибунал по гражданским спорам Британской Колумбии разбирал случай, когда чат-бот авиакомпании дал клиенту понять, что тариф для летящих на похороны (bereavement fare) можно оформить задним числом. Позиция авиакомпании, по формулировке трибунала, сводилась к тому, что «чат-бот — это отдельное юридическое лицо, отвечающее за свои действия». Трибунал с этим не согласился: «Не имеет значения, поступает ли информация со статической страницы или от чат-бота».
Это инженерный контекст, а не юридическая консультация, и одно решение трибунала — не общее правило. Инженерный вывод более узкий: ассистент на вашем сайте говорит с авторитетом вашего сайта. Сумма оплаты или дата начала работ, написанные от моего лица, были бы заявлением, которого я никогда не делал. Уверенный неверный ответ хуже, чем отсутствие ответа; уверенное неверное обязательство — тем более.
Третье лицо, фиксированные тексты отказа и проверка на первое лицо
Ассистент — это никогда не я. Он пишет обо мне в третьем лице, а все отказы и уведомления — фиксированный текст. Правило речи применяется в трёх местах:
Слой 1 отклоняет вопросы об оплате, доступности для работы, найме и личных данных до поиска — на каждом языке сайта.
Слой 3 запрещает первое лицо и любые обязательства от моего имени.
Слой 4 останавливает поток, как только появляется слово в первом лице.
В персидском эта проверка слабее. Английский список первого лица покрывает местоимения. Персидский список составлен вручную и на полноту не претендует: персидский выражает лицо глагольными окончаниями, и правило, достаточно широкое, чтобы поймать их все, ловило бы и обычные слова с такой же концовкой. В списке есть местоимения и несколько глаголов с высоким риском, например هستم и دارم, каждый в обеих формах, которые может дать нормализация: проверка нормализует текст до разбиения на слова, поэтому میکنم доходит до неё как два токена, а میکنم — как один. Непокрытым остаётся окончание, а не написание. В персидском контроль больше опирается на промпт, и это записано, а не спрятано. Для остальных языков сайта список содержит личные и притяжательные местоимения первого лица, а для испанского, португальского, русского, арабского и хинди, где «я» обычно выражается одним глаголом, ещё и несколько глаголов в первом лице. В китайском, где слова не разделяются пробелами, проверка ищет 我 в любом месте предложения, кроме сложных слов с 自我, «само-», таких как 自我修正, «самокоррекция». В арабском одно слово первого лица исключено намеренно: нормализация букв, которая делает сопоставимыми персидское и арабское написание, превращает его в точную копию частого предлога.
Накрутка расходов и Denial of Wallet: сбой того же рода
Галлюцинация — это вывод, которого никто не санкционировал. Счёт без потолка — это расходы, которых никто не санкционировал. Второе OWASP относит к записи LLM10:2025 Unbounded Consumption, куда входит и Denial of Wallet: злоумышленники «эксплуатируют модель оплаты за использование облачных ИИ-сервисов, создавая непосильную финансовую нагрузку на поставщика». Среди мер защиты там перечислены ограничение размера ввода, лимиты запросов и квоты пользователей, таймауты и троттлинг, а также плавная деградация.
Бюджет до вызова, а не оповещение после
Проверка после вызова модели срабатывает, когда деньги уже потрачены. На этом сайте проверка месячных расходов выполняется после порога и до вызова модели. Она складывает израсходованное к этому моменту с верхней границей стоимости текущей реплики: весь промпт считается по одному токену на байт в кодировке UTF-8, плюс полный лимит вывода, включая запас на рассуждения. Если вместо этой границы сверяться с ожидаемой стоимостью, лимит именно так и пробивают.
Если сумма выходит за лимит, модель не вызывается, а читатель получает не сообщение об ошибке, а фиксированное уведомление о том, что месячный лимит исчерпан.
Счёт байтов — это потолок, а не щедрая догадка. Любой словарь, на который можно направить эту точку входа, — байтовый BPE, а в таком токенизаторе токен есть непустая последовательность байтов, поэтому никакой текст не может дать больше токенов, чем в нём байтов, ни на одном языке. Обойти эту границу мог бы только токенизатор, который расширяет текст перед разбиением, — ни один из этих токенизаторов так не делает. Граница заменила плоское правило «один токен на два символа», от которого этот сайт отказался: персидский налог на токены показал, что на cl100k_base это правило занижало истинное число токенов на каждом персидском предложении параллельного корпуса. Запас в этой границе большой — для персидского она резервирует в несколько раз больше, чем промпт стоит на самом деле, — и ошибается она в ту единственную сторону, в которую лимиту расходов ошибаться можно.
Остаются два ограничения. Проверка — не резервирование: расход читается и сравнивается, но не удерживается, поэтому пришедшие одновременно запросы могут пройти каждый по отдельности и вместе выйти за лимит; лимиты на один IP это окно сужают, но не закрывают. И счётчик — не полная бухгалтерская книга: он хранит стоимость вызовов модели только с этой точки входа, поэтому обращение к стороннему сервису эмбеддингов, которое стоит за каждым вопросом, остаётся вне его, а запись, потерянная, пока хранилище счётчика недоступно, не повторяется. Лимит — это гардрейл, а не счёт.
При сбое: по расходам — отказ, по лимитам запросов — пропуск
Если хранилище счётчика недоступно, расход неизвестен, а неизвестный расход при жёстком лимите читается безопасно ровно одним способом: отказать так, будто лимит уже исчерпан.
Ограничитель числа запросов, наоборот, при сбое запросы пропускает, потому что отказ кеша не должен ронять сайт. Худшее, что даёт открытый при сбое лимит запросов, — несколько лишних запросов; худшее, что даёт открытый при сбое лимит расходов, — счёт без потолка. Лимитов на один IP три, они восполняются за минуту, за час и за сутки, а ключом служит адрес, который увидел пограничный прокси, а не заголовок, который клиент может написать сам. Они замедляют скрипты; страховкой по расходам остаётся месячный лимит — гарантией он не является.
Читатель ушёл — платить больше не за что
Закрытая вкладка браузера не останавливает запрос, уже ушедший к модели. Сервер проверяет разрыв соединения внутри цикла стриминга и закрывает поток провайдера, а это отменяет запрос. Остановка шлюза делает то же самое: никто не должен платить за предложения, которых никто не увидит.
То, что было сгенерировано до обрыва, всё равно сгенерировано и всё равно попадает в счёт, поэтому расходы месяца его учитывают. Оба протокола провайдеров сообщают потребление в финальном событии, до которого оборванный поток не доходит, поэтому сервис сохраняет каждый полученный символ и заполняет только те пробелы, которые оставил провайдер, по одному токену на байт UTF-8. Там, где провайдер всё же отчитался, побеждают его цифры: реплика, дошедшая до конца, записывает ровно то, что он сказал, а не приближение к этому.
Как это измерять: точность отказов, recall@k и опора на источники
Значение имеют три свойства. Точность отказов показывает, отклоняет ли ассистент то, что обязан отклонить. Recall@k показывает, доходят ли свидетельства до модели. Опора на источники показывает, остаётся ли ответ внутри этих свидетельств. На этом сайте золотой набор (golden set) из вопросов на всех десяти языках сайта, в основном английских и персидских, оценивается детерминированно на каждом прогоне CI, без единого вызова модели.
Точность отказов: два набора и никаких частичных баллов
Отказ оценивается на двух наборах, потому что два слоя отказа ошибаются по-разному. Вопросы из набора шаблонных отказов должен поймать слой 1 до того, как запустится поиск; вопросы без свидетельств, никак с сайтом не связанные, должны остаться ниже порога и не должны распознаваться как вопросы обо мне. Третий набор проверяет, что вопросы о работе в целом доходят до записей сайта.
Чтобы сборка прошла, безупречный результат нужен на обоих наборах. Один пропущенный отказ — это выдуманное обязательство на сайте реального человека, и среднее его бы спрятало. Тот же прогон проверяет и обратный сбой: вопросы с ответом, отклонённые шаблонами или порогом. FAQ по оценке моделей, написанный Хэмелом Хусейном (Hamel Husain) и Шреей Шанкар (Shreya Shankar), предпочитает «прошло/не прошло» шкалам оценок, потому что «бинарные оценки заставляют мыслить яснее и размечать данные более единообразно».
Сами вопросы, в которых нужен отказ, я здесь не цитирую: эта статья попадёт в корпус ассистента, и цитата дала бы именно этим вопросам сильное совпадение по ключевым словам на этой самой странице.
Recall@k при k меньше значения по умолчанию
В золотом наборе recall@k спрашивает, есть ли среди top-k хотя бы один фрагмент, отвечающий на вопрос, то есть по сути это доля попаданий (hit rate). В заметке Anthropic о Contextual Retrieval взята более строгая величина — доля найденных релевантных документов, а мерой неудачи там служит «1 минус recall@20».
Золотой набор измеряет recall при k = 5, ниже top-k по умолчанию, равного 8, потому что на тестовом корпусе из нескольких десятков фрагментов восемь лучших — заметная доля всего, что там есть, и измерение в этой точке льстило бы поиску.
Опора на источники: применяется во время работы, а не оценивается офлайн
В офлайн-оценке опору на источники обычно измеряют метрикой faithfulness. Ragas определяет её как число утверждений ответа, которые подтверждает найденный контекст, делённое на общее число его утверждений, в диапазоне от 0 до 1; в стандартном виде утверждения выделяет и проверяет LLM.
LLM-судьи полезны и при этом смещены. Чжэн (Zheng) и соавторы обнаружили «смещения, связанные с позицией, многословием и самовосхвалением», а сильные судьи всё же достигали более 80% совпадения с человеческими предпочтениями. Хусейн и Шанкар советуют проверять у судьи долю истинно положительных и истинно отрицательных решений на отложенном размеченном наборе, а начинать с дешёвых программных проверок везде, где решение может принять правило.
Этот сайт выбрал путь программных проверок: шлюз применяет опору на источники во время работы, а ни метрика faithfulness, ни LLM-судья в CI не запускаются.
Чего мой золотой набор не доказывает
Модель эмбеддингов суррогатная. Поиск в CI использует хеширующую модель «мешок токенов» без выученных смыслов. Маршрутизация, слияние, ранжирование, отбор top-k и решение о свидетельствах вместе со сравнением с порогом — это рабочий код; в самом тесте воспроизведён только подсчёт оценок кандидатов, который в продакшене выполняет база данных. Поэтому CI ловит регрессии в механике маршрутизации и ранжирования, но не в запросе к базе данных и не в recall живого ассистента, а суррогатная модель вдобавок задействует разреженный список, которым продакшен не пользуется.
Наборы маленькие. В наборах двадцать один шаблонный отказ и одиннадцать вопросов без свидетельств. Требование «безупречно» на одиннадцати вопросах — защита от регрессии, а не доля отказов.
Живые проверки — это команды, а не задачи CI. Тест, который отправлял бы золотой набор развёрнутому поиску, по-прежнему пропускается. Команда, которая выполняет только поиск, прогоняет через развёрнутую модель эмбеддингов вопросы золотого набора и предлагаемые вопросы, не вызывая модель, а скрипт, запускаемый вручную после каждого импорта, задаёт живому ассистенту вопросы, в которых нужен отказ.
Ответы по записям проверяет только шлюз. CI проверяет на фиксированных тестовых данных, какие вопросы доходят до записей сайта и какие записи они получают, с заскриптованной заменой модели. Как настоящая модель формулирует ответ по ним, проверяется во время работы — шлюзом.
Поэтому я не публикую для ассистента ни цифры точности, ни доли отказов, ни recall: автоматический прогон работает на суррогатной модели эмбеддингов, живые проверки невелики и запускаются вручную, а этот сайт не оценивает на глаз числа, которых не измерял.
Структура вместо доверия в ассистенте по договорам
Я работал ИИ-инженером над Kartez Contract — трёхъязычным рабочим пространством для договоров, которое заказчик остановил за месяц до сдачи по причинам финансирования, связанным с войной. Там привязку модели к тексту обеспечивала структура, а не доверие: ответы опираются только на отобранные пункты, исправления обязаны дословно цитировать существующую формулировку, вывод следует фиксированным схемам, а при составлении текста модель работает с низкой случайностью. Это проектные ограничения, а не измеренная гарантия. Порог и шлюз, описанные выше, относятся к ассистенту этого сайта, а не к Kartez. Сам проект разобран в кейсе Kartez Contract. Как эти паттерны выглядят в ИИ для договоров и почему набор для оценки создаётся первым — в статье о том, что строить против галлюцинаций юридического ИИ.
Чек-лист: гардрейлы для промышленного RAG-ассистента
Сначала отказывайте по шаблонам. Вопросы об оплате, доступности для работы, личных данных и попытки вытащить инструкции отклоняйте до поиска.
Ставьте порог на сходство, а не на ранговую оценку. Косинусное сходство порог выдержит, покрытие целыми словами — тоже, если частотные слова отброшены и совпали хотя бы два значимых слова; оценка RRF — нет. Ниже порога отказывайте фиксированным текстом и не вызывайте модель.
На обзорные вопросы отвечайте по записям, а не по сходству. У списка, отсортированного по датам, нет ближайшего соседа.
Калибруйте порог на той модели эмбеддингов, которую разворачиваете. Порог, проверенный на суррогатной модели, — это значение по умолчанию.
У каждого правила промпта должен быть двойник вне модели.
Проверяйте поток по предложениям. Требуйте маркер, сверяйте числа, URL и адреса электронной почты дословно, удерживайте всё начиная с непрошедшего предложения и давайте обрыву отдельное уведомление.
Запрещайте первое лицо в ассистентах, которые говорят о человеке или компании, и записывайте, где проверка слабее.
Резервируйте верхнюю границу до вызова, а не щедрую догадку. Для байтового BPE такой границей служит число байтов промпта в UTF-8. Делайте резервирование атомарным, чтобы одновременные запросы не могли пройти все разом, отказывайте при недоступном счётчике и отменяйте работу на стороне провайдера при разрыве соединения.
Записывайте стоимость каждого вызова, включая оборванные: сохраняйте текст по мере стриминга и заполняйте только то, о чём финальное событие провайдера так и не сообщило.
Измеряйте отказы отдельно от recall. Указывайте модель эмбеддингов, размеры наборов и то, чего прогон не доказывает.
Частые вопросы
Устраняет ли RAG галлюцинации?
Нет. В предварительно зарегистрированном исследовании доля галлюцинаций у построенных на RAG юридических инструментов LexisNexis и Thomson Reuters составила от 17% до 33%, а недостаточный контекст способен сделать модель увереннее, а не осторожнее. Поиск улучшает шансы; гарантии дают проверки вне модели.
Какой порог сходства выбрать для RAG?
Универсального числа нет: распределения сходства зависят от модели эмбеддингов и от корпуса. Ставьте порог на ограниченное сходство — например, косинусное — и никогда на оценку слияния обратных рангов, а само значение подбирайте по вопросам с ответом и вопросам, требующим отказа, прогнав их через ту модель эмбеддингов, которую разворачиваете. Порог, проверенный только на суррогатной модели, — это значение по умолчанию, а не калибровка.
Достаточно ли системного промпта, чтобы остановить галлюцинации?
Нет. OWASP рекомендует «по возможности не использовать системные промпты для контроля поведения модели» и полагаться «на системы вне LLM», а руководство Anthropic говорит, что приёмы промптинга снижают число галлюцинаций, но не устраняют их. Промпт оставьте, но каждой важной инструкции дайте детерминированную проверку вне модели.
Может ли LLM-судья заменить детерминированные проверки?
Не для тех правил, которые может решить проверка строки: указывает ли маркер на реальный источник, встречается ли число в свидетельствах. У судей есть смещения, связанные с позицией, многословием и самовосхвалением. Применяйте их там, где код ответить не может, с бинарными метками и с судьёй, проверенным на человеческой разметке.
Как не дать LLM-чат-боту накрутить счёт?
До вызова модели атомарно зарезервируйте верхнюю границу его стоимости — для байтового BPE-токенизатора такой границей служит число байтов промпта в UTF-8, на любом языке — и отказывайте, если счётчик недоступен. Записывайте стоимость каждого вызова, включая оборванные: сохраняйте потоковый текст и заполняйте то, о чём финальное событие провайдера не сообщило. Вместо ошибки показывайте фиксированный текст, а при разрыве соединения с клиентом отменяйте генерацию на стороне провайдера. В списке OWASP этот риск называется LLM10:2025 Unbounded Consumption и включает Denial of Wallet.
Источники
Если вы проектируете ассистента, который должен отказывать так же надёжно, как отвечает, начните с диагностики проекта.