
Персидский налог на токены: цена неанглоязычных LLM-приложений
На 1 012 параллельных предложениях фарси потребовал 1,53× токенов английского на токенизаторе GPT-4o и 3,26× на GPT-4. Метод, результаты и что проверить.
Персидский текст (фарси) тратит больше токенов, чем английский, при одном и том же содержании. Эта надбавка и есть персидский налог на токены, и её размер зависит от токенизатора сильнее, чем от письменности. Я посчитал токены для одних и тех же 1 012 предложений на английском и фарси из бенчмарка FLORES-200. На o200k_base — кодировке, которую библиотека tiktoken от OpenAI сопоставляет с GPT-4o, — фарси потребовал 1,53× токенов английского, а на cl100k_base, которую она сопоставляет с GPT-4, — 3,26×. Это два крайних значения среди четырёх токенизаторов, которые используют модели генерации текста; bge-m3, токенизатор модели эмбеддингов, дал 1,10×. Claude и Gemini в это измерение не вошли: Anthropic не публикует токенизатор Claude, а локальный токенизатор, который SDK Google предлагает для Gemini, я не проверял. Оба поставщика считают токены своих моделей через API.
Эти числа — снимок на конкретную дату: измерение сделано 17 сентября 2026 года с зафиксированными версиями токенизаторов.
Почему фарси тратит больше токенов: байты, слияния и обучающие данные
В API языковых моделей счёт идёт на токены. В 2023 году Ahia и соавторы нашли свидетельства того, что «носители большого числа поддерживаемых языков переплачивают, получая при этом худшие результаты». Petrov и соавторы показали, что длина токенизации одного и того же текста в переводах на разные языки расходится «в некоторых случаях до 15 раз». Исследование 2025 года, охватившее более двухсот языков, сообщает о «часто в 3–5 раз более высоких значениях RTC» для языков с нелатинской письменностью и сложной морфологией; RTC — это «относительная стоимость токенизации» (Relative Tokenization Cost) в терминологии авторов.
Это и есть налог на токены: тот же смысл — счёт больше.
Байты — точка старта любого побайтового токенизатора
Побайтовый BPE-токенизатор (byte-pair encoding) — та самая конструкция, что стоит за GPT-4o, Qwen3 и DeepSeek-V3, — начинает с байтов текста в кодировке UTF-8 и склеивает частые последовательности байтов в токены. Латинская буква без диакритики занимает один байт; буквы йоруба с тоновыми знаками и точкой под буквой — два и больше. Персидская буква — два байта, а разделитель нулевой ширины (ZWNJ) внутри персидских слов — три. В FLORES персидский файл в UTF-8 весит 1,69× английского при 0,94× символов. Фарси не длиннее в символах. Он тяжелее в кодировке.
Что происходит дальше, зависит от слияний, которые токенизатор выучил на своих обучающих данных. Переход с cl100k_base на o200k_base сократил число персидских токенов на 53,5%, а английских — на 1,1%. Более новый словарь изменил фарси, а не английский.
Йоруба пишется латиницей и всё равно платит больше
Если бы налог определяла письменность, языки на латинице почти не платили бы его. Roy, Roy и Patel в своём аудите (доклад принят на воркшоп IJCAI 2026, препринт на arXiv с августа 2026 года) обнаружили, что «йоруба, несмотря на латинскую письменность, показывает самую высокую надбавку токенизации GPT-4o» — 2,37×. Авторы указывают на диакритику и на покрытие словаря. В этой работе йоруба — разведочное сравнение: его переводы получены машинным переводом и проверены вручную, тогда как валидированные случаи — бенгальский и хинди.
Мой прогон указывает в ту же сторону. На четырёх токенизаторах из пяти йоруба стоил дороже фарси, а арабский на четырёх из пяти — дешевле фарси. Исключение по арабскому — bge-m3, модель эмбеддингов, построенная на XLM-RoBERTa и её словаре. XLM-R обучали на ста языках из CC-100: 13 259 млн токенов фарси против 2 869 млн арабского, а йоруба среди них не было. Это согласуется с тем, что доля в обучающих данных значит больше, чем письменность. Но не доказывает этого.
Результаты: фарси, арабский и йоруба против английского
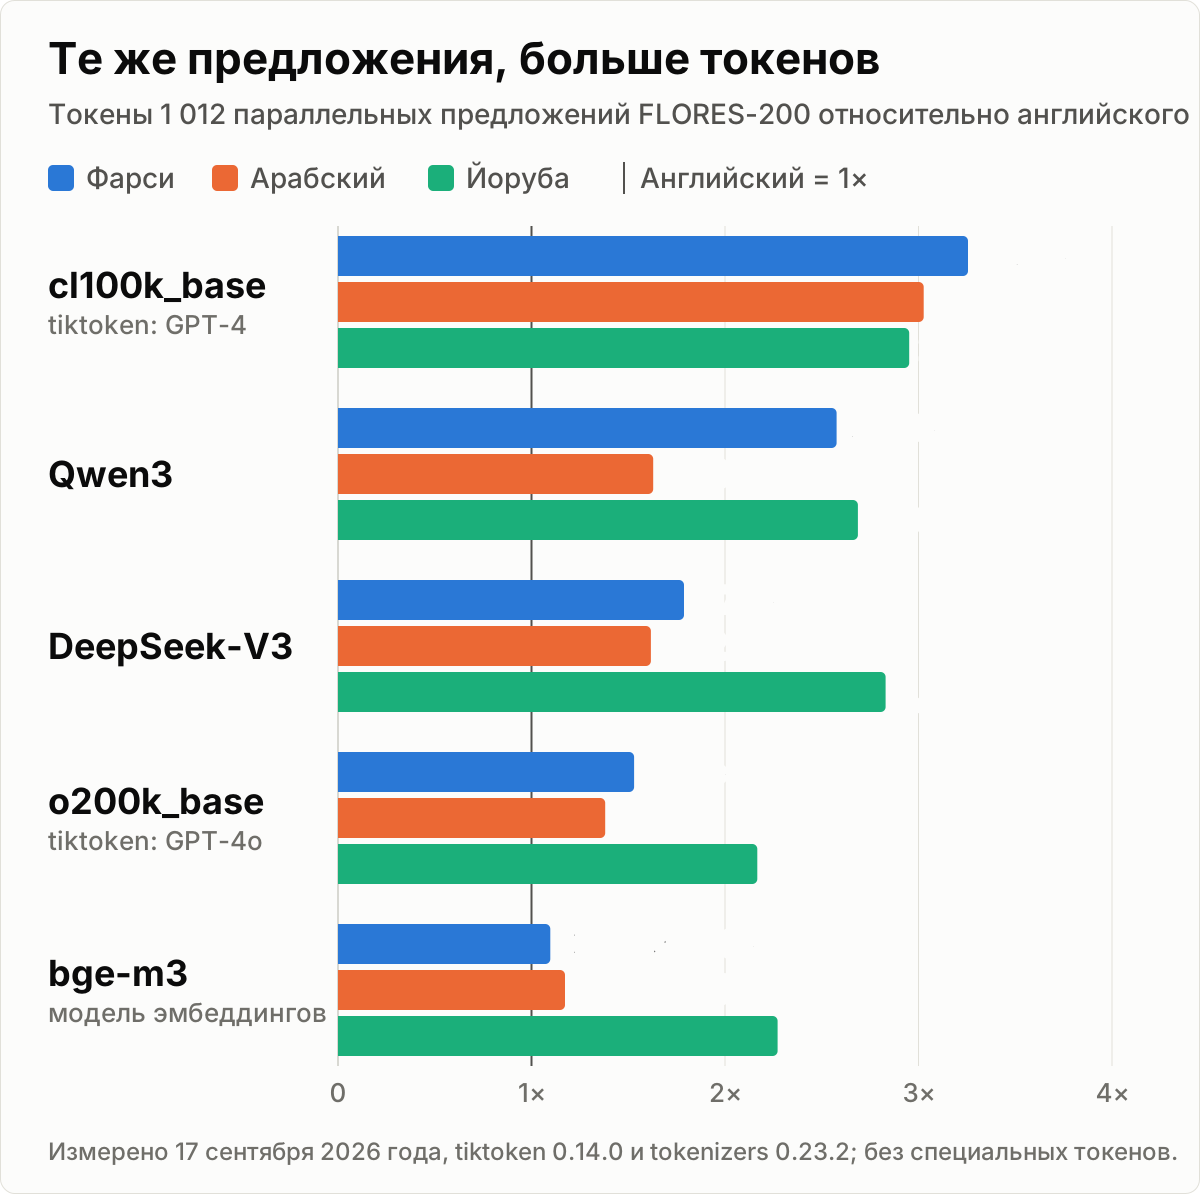
Каждая ячейка — сумма токенов языка, делённая на сумму токенов английского на том же токенизаторе:
Токенизатор | Фарси (× английского) | Арабский (× английского) | Йоруба (× английского) |
|---|---|---|---|
| 3,26× | 3,03× | 2,95× |
Qwen3 | 2,58× | 1,63× | 2,69× |
DeepSeek-V3 | 1,79× | 1,62× | 2,83× |
| 1,53× | 1,38× | 2,17× |
bge-m3 | 1,10× | 1,17× | 2,27× |
Самая большая переменная — сам токенизатор. Отношение для фарси на худшем токенизаторе (3,26×) примерно втрое выше, чем на лучшем (1,10×), и даже среди четырёх токенизаторов для генерации — примерно вдвое (3,26× против 1,53×). Qwen3 обходится с арабским заметно лучше, чем с фарси, 1,63× против 2,58×, так что одно число для арабской письменности не покрывает оба языка. Результат cl100k_base согласуется с опубликованными ранее подсчётами: в данных Petrov и соавторов по FLORES-200, где части dev и devtest посчитаны вместе, западный фарси даёт 3,28× английского — против моих 3,26× на одной только части devtest.
Суммы, из которых получены эти отношения, и размер файла каждого языка до того, как его коснулся токенизатор:
Показатель | Английский | Фарси | Арабский | Йоруба |
|---|---|---|---|---|
Символы | 131 966 | 123 830 | 116 320 | 126 848 |
Байты (UTF-8) | 132 096 | 223 504 | 211 276 | 168 857 |
Токены, | 27 182 | 88 513 | 82 288 | 80 247 |
Токены, Qwen3 | 27 621 | 71 183 | 44 991 | 74 226 |
Токены, DeepSeek-V3 | 27 041 | 48 342 | 43 713 | 76 526 |
Токены, | 26 873 | 41 116 | 37 117 | 58 238 |
Токены, bge-m3 | 30 661 | 33 631 | 35 979 | 69 672 |
На вашем корпусе число будет другим
Аудит Roy и соавторов измерял o200k_base на 120 задачах по отладке Python, переведённых с английского, и усреднял по задачам. Там арабский получил 1,44×, а йоруба — 2,37×, и оба — на машинных переводах. На прозе FLORES, которую переводили люди, o200k_base дал арабскому 1,38×, а йоруба — 2,17×. Тот же токенизатор, другой текст и другой способ перевода — другой результат. Прежде чем считать бюджет, посчитайте собственные промпты, найденные фрагменты и ответы.
Как я считал токены фарси
По-настоящему параллельный корпус
Команда NLLB описывает FLORES-200 как «бенчмарк, переведённый людьми»: одни и те же предложения, в одном и том же порядке, на каждом языке. Я взял его часть devtest под лицензией CC BY-SA 4.0 из официального архива и сверил хеш SHA-256: 1 012 предложений из Wikinews, Wikivoyage и Wikibooks на английском, западном фарси, современном стандартном арабском и йоруба.
Параллельность важнее объёма. Адаптированный перевод — скажем, двуязычное резюме — что-то добавляет, что-то выбрасывает и переформулирует, поэтому его отношение измеряет редактуру не меньше, чем токенизатор. У FLORES есть своё ограничение: это проза новостей, путеводителей и учебников, а не чат, код или договоры.
Открытые токенизаторы, зафиксированные ревизии и почему нет Claude и Gemini
Пять токенизаторов, и каждый скачивается без учётной записи:
tiktoken 0.14.0:
cl100k_baseиo200k_base. tiktoken сопоставляет GPT-4 и GPT-3.5 Turbo с первой кодировкой, а GPT-4o, o1, o3, GPT-4.1 и GPT-5 — со второй.Qwen3 (
Qwen/Qwen3-8B) и DeepSeek-V3 (deepseek-ai/DeepSeek-V3), оба — побайтовый BPE, загружены через Hugging Face tokenizers 0.23.2 на зафиксированных ревизиях Hub.bge-m3 (
BAAI/bge-m3) — модель эмбеддингов; её токенизатор — это SentencePiece Unigram со словарём XLM-R, а не побайтовый BPE. Unigram — другой алгоритм: он выбирает наиболее вероятное разбиение текста по фиксированному словарю. Он важен для поиска, а не для генерации.
Каждое предложение кодировалось отдельно, без специальных токенов, а результаты суммировались. Медианы по предложениям говорят то же, что и суммы. Суть умещается в несколько строк:
# after: tar -xzf flores200_dataset.tar.gz
import tiktoken
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer


def sentences(lang):
    with open(f"flores200_dataset/devtest/{lang}.devtest", encoding="utf-8") as f:
        return f.read().rstrip("\n").split("\n")


english, persian = sentences("eng_Latn"), sentences("pes_Arab")

o200k = tiktoken.get_encoding("o200k_base")
qwen3 = Tokenizer.from_file(
    hf_hub_download(
        "Qwen/Qwen3-8B",
        "tokenizer.json",
        revision="b968826d9c46dd6066d109eabc6255188de91218",
    )
)


def o200k_tokens(texts):
    return sum(len(o200k.encode_ordinary(t)) for t in texts)


def qwen3_tokens(texts):
    return sum(len(qwen3.encode(t, add_special_tokens=False).ids) for t in texts)


print(round(o200k_tokens(persian) / o200k_tokens(english), 2))
print(round(qwen3_tokens(persian) / qwen3_tokens(english), 2))
Протокол измерения — всё, что нужно, чтобы повторить прогон в точности:
corpus: https://dl.fbaipublicfiles.com/nllb/flores200_dataset.tar.gz
sha256: b8b0b76783024b85797e5cc75064eb83fc5288b41e9654dabc7be6ae944011f6
split: devtest
measured: 2026-09-17
libraries:
  tiktoken: 0.14.0
  tokenizers: 0.23.2
  huggingface_hub: 1.31.0
encodings: [cl100k_base, o200k_base]
hub_revisions:
  Qwen/Qwen3-8B: b968826d9c46dd6066d109eabc6255188de91218
  deepseek-ai/DeepSeek-V3: e815299b0bcbac849fa540c768ef21845365c9eb
  BAAI/bge-m3: 5617a9f61b028005a4858fdac845db406aefb181
method: each sentence encoded on its own, no special tokens, counts summed per language
Claude и Gemini отсутствуют намеренно. Anthropic не публикует токенизатор Claude, поэтому любое отношение для Claude было бы догадкой с десятичной запятой. Gen AI SDK для Python от Google содержит экспериментальный локальный токенизатор, работающий только с текстом и сопоставляющий часть моделей Gemini с открытыми токенизаторами Gemma; я его не измерял. Оба поставщика посчитают токены за вас. Эндпоинт count_tokens у Anthropic бесплатный, но с ограничением частоты вызовов, и документация называет результат «оценкой»; count_tokens у Gemini считает вход. Модели Claude 4.7 и новее используют более новый токенизатор, на котором тот же входной текст даёт «примерно на 30 процентов больше токенов, чем на прежних моделях». Счёт токенов принадлежит модели, а не поставщику.
Границы, которые держатся, и одна, которая не держится
Все четыре побайтовых BPE-токенизатора здесь режут текст на предтокены ещё до слияний, и у таких токенизаторов счёт зажат между двумя границами. Токенов не может быть больше, чем байтов текста в UTF-8 в том виде, в каком его нормализует токенизатор, потому что каждый токен покрывает хотя бы один байт. И их не может быть меньше, чем собственных предтокенов этого токенизатора — кусков, на которые его шаблон разбиения режет текст, — потому что слияния никогда не пересекают границу предтокена. Обе границы я проверил по предложениям на четырёх побайтовых BPE-токенизаторах и всех четырёх языках: 16 192 проверки, 0 нарушений.
Песочница токенизатора на этом сайте показывает оба числа для любого введённого текста, считая их прямо в браузере: разбиение на предтокены cl100k_base и байты текста в UTF-8. Для cl100k_base истинный счёт лежит между ними — это и написано в подписи под каждой панелью.
Нижняя граница принадлежит одному токенизатору. Разбиение cl100k_base не задаёт нижнюю границу для o200k_base: на 28 английских предложениях o200k_base потребовал меньше токенов, чем cl100k_base даёт предтокенов. К Unigram-модели bge-m3 не применима ни одна из этих границ.
Как налог на токены влияет на цену, задержку, контекст и лимиты
Цена
Поставщики API берут плату за токены, которые модель обрабатывает и генерирует. При одной и той же цене за токен тот же контент на фарси стоит примерно в полтора раза дороже английского на o200k_base и больше чем втрое дороже на cl100k_base. Когда и промпт, и ответ на фарси, надбавка ложится на обе стороны счёта.
Задержка
Темп задают выходные токены. Руководство OpenAI по задержке говорит, что «сокращение 50% выходных токенов может сократить задержку на ~50%». Урезание промпта значит куда меньше: «сокращение 50% промпта может дать выигрыш по задержке всего в 1–5%». Ответ на фарси, которому нужно больше токенов, чем его английскому эквиваленту, дольше идёт в потоке. Это рекомендация поставщика, приложенная к отношениям выше, а не моё измерение задержки.
Контекстное окно
В окно фиксированного размера помещается меньше фарси. Если поделить на отношение, то на этом корпусе то же окно вмещает на фарси 31% английского содержания на cl100k_base, 39% на Qwen3, 56% на DeepSeek-V3, 65% на o200k_base и 91% на bge-m3. Аудит Roy и соавторов делает тот же вывод для бенгальского: его надбавка 1,56× на GPT-4o сжимает «номинальное контекстное окно в 128k токенов до фактической ёмкости в 82k токенов английского эквивалента». В промпте RAG это означает место для меньшего числа найденных фрагментов.
Лимиты запросов
Лимиты тоже считаются в токенах. У API Claude они «измеряются в запросах в минуту (RPM), входных токенах в минуту (ITPM) и выходных токенах в минуту (OTPM)». При потолке на токены в минуту нагрузка, которой нужно больше токенов на запрос — а фарси нужно больше на каждом измеренном здесь токенизаторе, — упирается в лимит после меньшего числа запросов. У большинства моделей Claude чтения из кеша не идут в счёт входного лимита.
Нормализация, которая экономит токены, и нормализация, которая ломает полноту поиска
Две особенности персидского письма выглядят как дешёвая экономия токенов. Обе — ловушки.
ZWNJ (نیمفاصله) — это символ, а не пробел
У U+200C ZERO WIDTH NON-JOINER общая категория Unicode — Cf, управляющий символ форматирования, а не пробельный символ. Он не даёт соседним буквам соединиться, поэтому میشود читается как одно слово с видимым разрывом. В персидском файле FLORES он встречается 1 739 раз — в 735 из его 1 012 предложений.
Замена каждого ZWNJ пробелом изменила число персидских токенов на -1,59% на cl100k_base, -1,82% на o200k_base, -1,57% на Qwen3, -8,08% на DeepSeek-V3 и +0,00% на bge-m3. bge-m3 не сдвинулся, потому что его нормализатор и так приводит ZWNJ к пробелу: все 735 изменённых предложений сохранили те же идентификаторы токенов.
Экономия мала на трёх токенизаторах, больше на DeepSeek-V3 — и она меняет текст: одно слово превращается в два, и то, что вы храните, показываете и цитируете, уже не то, что написал автор. Храните ZWNJ в тексте, а вопрос о том, что считать одинаковым при сравнении, решайте отдельно. Этот сайт так и делает: ZWNJ приравнивается к пробелу только в том приведении, которое применяется внутри сравнений.
Арабские йе и каф против персидских йе и кехе
ARABIC LETTER YEH (U+064A) и ARABIC LETTER FARSI YEH (U+06CC) — разные символы, и то же верно для ARABIC LETTER KAF (U+0643) и ARABIC LETTER KEHEH (U+06A9). В начале и в середине слова они выглядят одинаково, в конце слова — по-разному. Сравнение строк всегда видит два разных символа. Даже FLORES их смешивает: в его персидском файле 11 арабских йе и 22 арабских каф рядом с 9 570 персидскими йе и 2 957 кехе.
Замена каждой персидской йе и кехе в персидском файле на арабские йе и каф изменила счёт токенов на +2,20% на cl100k_base, +9,49% на o200k_base, -7,48% на Qwen3, +10,39% на DeepSeek-V3 и +11,95% на bge-m3. Замена, которая экономит токены на одном токенизаторе, стоит токенов на остальных четырёх.
Настоящая проблема — полнота поиска. Если в хранимом тексте и в запросах разные кодовые точки, точное и лексическое сопоставление молча перестаёт работать. Этот сайт приводит персидский текст при записи: арабские йе и каф становятся персидскими формами, а ZWNJ остаётся. Поисковый запрос он приводит так же. Без этого запрос, набранный с арабской йе, ищет символ, которого в индексе нет, и не возвращает ничего.
Общее правило на самом деле более узкое: приводить только персидский текст, потому что в арабском арабские йе и каф — правильные буквы. Ретривер этого сайта такого различия пока не делает: он применяет персидское приведение к контенту и вопросам на любом языке, включая арабский. Статья о гибридном поиске для персидского RAG объясняет этот пробел и разбирает всё остальное, что относится к поиску.
Персидские цифры
Запись ASCII-цифр персидскими цифрами изменила счёт токенов в пределах от +0,48% до +1,47%. Это не повод менять то, что видит читатель.
Как снизить расходы на токены фарси: проверять, а не предполагать
Каждый пункт проверьте на собственном трафике, прежде чем на него опираться.
Выбирайте модель на своём тексте. На одних и тех же предложениях отношение фарси к английскому менялось от 1,10× до 3,26×.
Считайте эндпоинтом поставщика. Для Claude и Gemini измеренные здесь отношения не говорят ничего.
Пересчитывайте при смене модели. Более новый токенизатор способен сдвинуть любой выставленный бюджет.
Задавайте размер чанков и бюджеты контекста в токенах, отдельно для каждого языка. Лимит по символам, настроенный на английском, на фарси вмещает больше токенов: примерно на шестую часть больше на bge-m3 и примерно в три с половиной раза больше на
cl100k_base.Ограничивайте длину ответа. Выходные токены тянут за собой и задержку, и цену. Anthropic советует просить определённое число предложений или абзацев, а не число слов.
Кешируйте повторяющийся контекст, потом измерьте долю попаданий. Любая экономия зависит от того, как часто ваш префикс действительно повторяется.
Английский системный промпт считайте гипотезой. Он занимает меньше токенов, но измерения того, что он делает с ответами на фарси, у меня нет.
Не вырезайте ZWNJ и не меняйте начертания букв ради экономии токенов. Экономия мала или непостоянна — в отличие от ущерба тексту и сопоставлению.
Как планировать бюджет токенов для фарси
Правило «сколько символов в токене» — догадка для каждого токенизатора
У фарси — от 1,40 символа на токен на cl100k_base до 3,68 на bge-m3, а на o200k_base — 3,01. У английского — от 4,30 до 4,91. Документация Google по Gemini говорит, что «один токен — это примерно 4 символа», и ставит рядом счёт английских слов: правило по мерке английского, а не утверждение о фарси.
Резерв в один токен на каждые два персидских символа звучит щедро. Этот сайт раньше так и резервировал — поэтому я проверил правило на этих предложениях: оно оказалось ниже истинного счёта на всех 1 012 персидских предложениях на cl100k_base и на 976 предложениях на Qwen3. На o200k_base и bge-m3 оно держалось, а на DeepSeek-V3 не дотянуло на 6 предложениях. Правило, безопасное на одном токенизаторе, на следующем может оказаться оптимистичным, поэтому сайт больше его не применяет.
Жёсткий потолок: число байтов
Для побайтового BPE число байтов текста в том виде, в каком его нормализует токенизатор, — жёсткий потолок, но свободный. На шкале, где 0 — счёт предтокенов, а 1 — счёт байтов, английский держался на 0,015–0,017: почти каждый английский предтокен, грубо говоря слово, — это один токен. Фарси оказался на 0,07 на o200k_base и на 0,31 на cl100k_base: разбит на куски, но далеко не на байты. Значит, резерв по байтам сильно избыточен. Для потолка, который никому нельзя перейти, это верный компромисс; для прогноза — неверный. Для Claude и Gemini считайте их эндпоинтами до вызова и записывайте расход, о котором они сообщают после.
Резервируйте до вызова, записывайте после
Ассистент этого сайта разделяет эти две задачи. Прежде чем вызвать языковую модель, он прибавляет оценку запроса — верхнюю границу токенов промпта плюс полный потолок ответа — к записанному расходу за месяц и сравнивает сумму с месячным лимитом. Если счётчик расхода прочитать не удаётся, он отказывает в вызове. На лимите модель не вызывается, и читатель получает уведомление, а не ошибку. После вызова он записывает расход, о котором сообщил поставщик. Оценка решает только, можно ли начинать запрос; текущая сумма складывается из счётчиков токенов поставщика.
У обеих половин есть свои пределы, и направлены они в разные стороны. Предварительная оценка считает промпт как его длину в байтах UTF-8: это потолок из раздела выше, а не прогноз. Каждый словарь, на который можно направить ассистента, — побайтовый BPE, поэтому потолок держится, с какой бы моделью он ни говорил и на каком бы языке ни писал посетитель. Для фарси он резервирует в несколько раз больше, чем промпт стоит на самом деле, — на время одного запроса и никогда не записывая это как расход. Раньше промпт считался по тому самому фиксированному правилу «два символа на токен», проверенному выше, которое оказалось ниже истинного счёта на всех 1 012 персидских предложениях на cl100k_base. Слишком маленький резерв — это ошибка потолка в ту единственную сторону, в которую потолок ошибаться не должен, и правило изменили именно из-за этого измерения: строка документации у оценщика ссылается на тот же прогон из 1 012 предложений. Месячная сумма в любом случае строится из записанного расхода, а не из оценки.
Запись должна справляться с молчанием. И OpenAI, и Anthropic сообщают число выходных токенов после сгенерированного текста, а справочник OpenAI по стримингу предупреждает: если поток прерван или отменён, «вы можете не получить финальный чанк usage». Поток, оборванный раньше времени — гардрейлом в стриминге или закрытой вкладкой, — заканчивается до того, как придёт отчёт, а каждый уже выданный символ попадает в счёт. Поэтому ассистент сохраняет текст по мере стриминга, а там, где поставщик ничего не сообщил, закрывает пробел тем же числом байтов — записывая с избытком, а не с недостатком. Там, где поставщик дал хоть что-то, побеждают его числа: завершившийся ход диалога записывает ровно то, что измерено, а не приближение к этому. Статья о гардрейлах против галлюцинаций в RAG показывает, где эта проверка стоит среди остальных слоёв ассистента.
Тот же принцип работает и в продукте. В Booq, где я руковожу ИИ-инженерией, каждая задача показывает свою стоимость или стартовую оценку до запуска, а неудавшаяся задача автоматически возвращает списание — как описано в кейсе Booq.
Частые вопросы
Тратит ли фарси больше токенов, чем английский, в моделях OpenAI?
Да. На одних и тех же предложениях FLORES-200 фарси потребовал 1,53× токенов английского на o200k_base (по карте tiktoken — GPT-4o, GPT-4.1 и GPT-5) и 3,26× на cl100k_base (GPT-4). На вашем трафике отношение будет другим, поэтому посчитайте его сами.
Сколько токенов тратит фарси в Claude или Gemini?
Это измерение ответа не даёт. Anthropic не публикует токенизатор для Claude, а Google в своём Gen AI SDK предлагает экспериментальный локальный подсчёт для части моделей Gemini, построенный на открытых токенизаторах Gemma, — его я не измерял. Отношения выше не переносятся ни на одного из этих поставщиков. Пользуйтесь эндпоинтом count_tokens у Anthropic или count_tokens у Gemini на реальных запросах и считайте заново при смене модели.
Арабский дешевле фарси?
На четырёх из пяти измеренных здесь токенизаторов — да: на o200k_base арабскому понадобилось 1,38× токенов английского против 1,53× у фарси. На bge-m3 всё наоборот, 1,17× против 1,10×, и это согласуется с тем, что в обучающих данных XLM-R фарси заметно больше, чем арабского.
Стоит ли убирать ZWNJ или переходить на арабские начертания ради экономии токенов?
Нет. Замена ZWNJ пробелом изменила счёт от -1,57% до -8,08% на побайтовых токенизаторах и меняет сами слова. Арабские начертания сэкономили токены только на Qwen3, а в остальных случаях добавили от +2,20% до +11,95%. И то и другое ломает точное сопоставление, если только каждый запрос не меняется ровно так же.
Сколько символов в одном персидском токене?
Зависит от токенизатора: в этом измерении от 1,40 на cl100k_base до 3,68 на bge-m3 против 4,30–4,91 у английского. Фиксированное правило, безопасное на одном токенизаторе, на другом недосчитает. После этого прогона сайт отказался от собственного резерва «два символа на токен» и резервирует число байтов; это же и общий совет: резервируйте по потолку или по счёту поставщика, а не по эмпирическому правилу.
Источники
Репозиторий facebookresearch/flores: лицензии и примечание об архиве
No Language Left Behind: Scaling Human-Centered Machine Translation (NLLB Team и соавторы, 2022)
Language Model Tokenizers Introduce Unfairness Between Languages (Petrov и соавторы, NeurIPS 2023)
Petrov и соавторы, длины токенизации на FLORES-200 (tokenization_lengths.csv)
Petrov и соавторы, скрипт, объединяющий части dev и devtest FLORES-200 (compute_tokenizations.py)
Tokenization Disparities as Infrastructure Bias (Teklehaymanot и Nejdl, 2025)
Unsupervised Cross-lingual Representation Learning at Scale (Conneau и соавторы, XLM-R и CC-100)
tiktoken: карта соответствия моделей и кодировок (openai/tiktoken)
Google Gen AI Python SDK: экспериментальный локальный токенизатор (local_tokenizer.py)
Если вы планируете LLM-функцию для персоязычных пользователей, начните с диагностики проекта.