
KI-Synchronisation: Pipeline-Architektur und Lehren aus der Produktion
Wie eine KI-Dubbing-Pipeline im Betrieb arbeitet: vier Modellstufen, Tücken des Persischen und der Anbieter-Fallback, der nach einem Ausfall Stille ersetzte.
Eine KI-Dubbing-Pipeline verkettet vier Modellstufen: Transkription mit Sprechererkennung, eine Übersetzung, die in das Timing des Originals passt, eine eigene Stimme für jeden Sprecher sowie Timing-Abgleich und Endmischung. Die Modelle sind der Teil, den man mieten kann. Ob weiterhin Synchronfassungen ausgeliefert werden, hängt von der Plattform um sie herum ab: ein Gateway pro KI-Anbieter mit automatischem Fallback, persistente Warteschlangen, Arbeit, die nach einem Absturz fortgesetzt wird, ein Preis, der vor dem Auftrag angezeigt wird, und eine Erstattung, wenn er fehlschlägt. Bei Booq, wo ich CTO bin, führte der Ausfall eines Anbieters für die Sprachausgabe einmal zu Synchronfassungen mit Stille an den Stellen, an denen Sätze fehlten. Heute greift die Sprachausgabe auf eine Kette von Anbietern zurück: Eine etwas andere Stimme ist besser als Stille.
Wie eine KI-Dubbing-Pipeline funktioniert: vier Stufen
Die Forschung zur automatischen Synchronisation beschreibt eine ähnliche Kette. Federico und Kollegen (2020) gingen von einer Pipeline für Speech-to-Speech-Übersetzung aus und ergänzten, was eine Synchronisation braucht:
Maschinelle Übersetzung, die Ausgaben mit einer bevorzugten Länge erzeugt.
Prosodischen Abgleich (prosodic alignment): Phrasen und Pausen der Übersetzung werden auf die Sprachsegmente des Originals abgestimmt.
Text-to-Speech (TTS), bei dem die Dauer jeder Äußerung feinjustiert wird.
Audio-Rendering, das Hintergrundgeräusche und Nachhall hinzufügt, die aus dem Originalton extrahiert wurden.
Eine Pipeline, die ein Video mit mehreren Personen synchronisiert, muss außerdem wissen, wer gerade spricht.
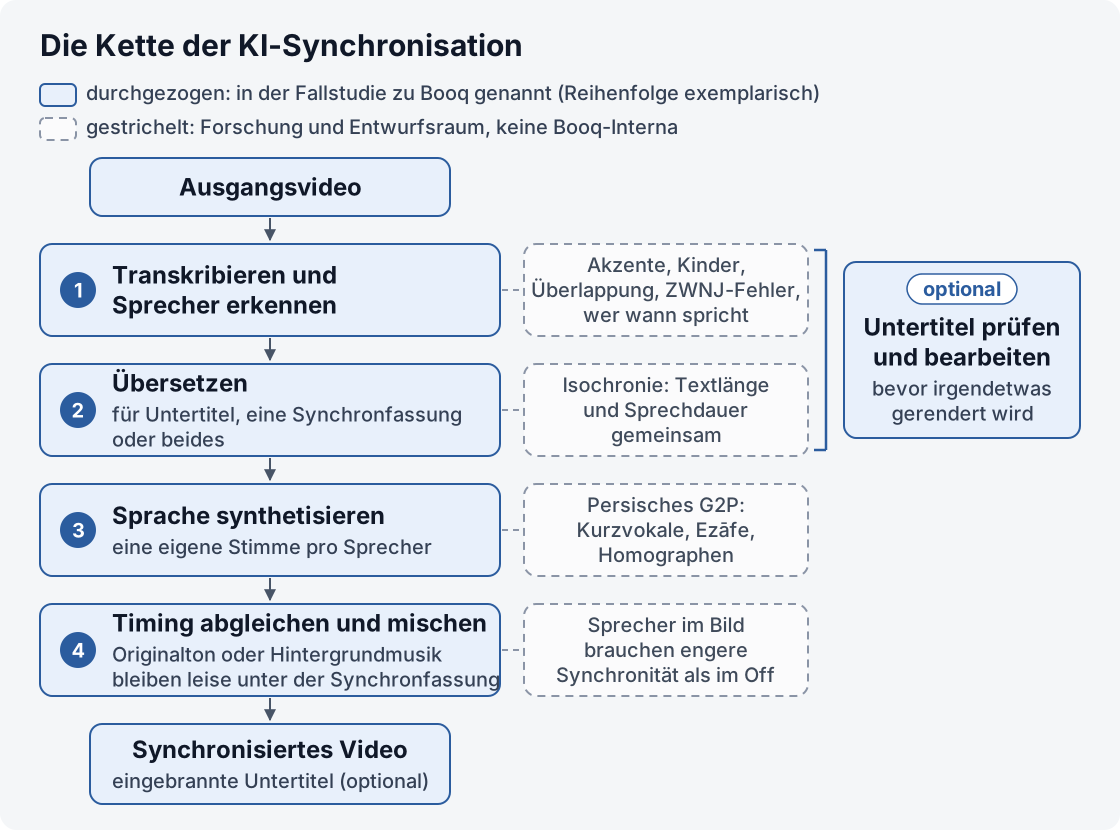
Diagramm der Kette in voller Größe öffnen

Die folgenden Abschnitte zu den einzelnen Stufen beschreiben Forschung und Entwurfsraum: was jede Stufe lösen muss und wo sie bricht. Sie beschreiben nicht die Interna eines Produkts, auch nicht die von Booq. Wo Booq darin vorkommt, steht dort nur, was die Fallstudie sagt, und der Abschnitt zur persischen Aussprache stützt sich auf meine eigene Forschung zur Sprachsynthese. Die Abschnitte zur Plattform sind aus erster Hand.
Stufe 1: Transkription und Sprechererkennung
Jede spätere Stufe erbt das Transkript. Ein Wort, das die Spracherkennung erfindet, wird genauso selbstsicher übersetzt, vertont und getimt wie ein Wort, das der Sprecher tatsächlich gesagt hat. Für Persisch liefert PSRB, ein 2025 veröffentlichter Benchmark, die nützlichsten öffentlichen Belege dafür, wo automatische Spracherkennung (ASR) danebenliegt.
Wo die Spracherkennung für Persisch scheitert
PSRB bewertet zehn ASR-Systeme, kommerzielle wie quelloffene. Das Fazit: Die Modelle schneiden bei persischer Standardsprache im Allgemeinen gut ab, haben aber Mühe mit regionalen Akzenten, Kindersprache und bestimmten sprachlichen Herausforderungen. Die Details lesen sich wie eine Beschreibung genau jenes Audiomaterials, das synchronisiert werden soll:
Akzente. Von den 12 untersuchten Akzenten schnitten die aus Maschhad und Yazd bei der Erkennungsgenauigkeit am schlechtesten ab.
Kinder. Kindliche Sprecher wurden am schlechtesten erkannt.
Mehrere Sprecher. Jedes Modell machte bei Audio mit mehreren Sprechern mehr Fehler als bei Audio mit einem einzigen Sprecher. Die Autoren nennen überlappende Sprache als die größte Herausforderung in solchem Audio, obwohl der Benchmark Überlappungen auf ein Minimum beschränkte, und einige Modelle ließen gelegentlich einen ganzen Sprecher im Transkript weg.
Genre. Hörbücher ergaben die niedrigsten Fehlerraten. Talkshows, Animationen und Filme, in denen spontane Dialoge, überlappende Sprache und Hintergrundgeräusche üblich sind, schnitten deutlich schlechter ab.
Register. Die Sprache im Benchmark ist zu 71,3 Prozent informell.
Das Paper nennt außerdem Fehlertypen, die für persische Schrift und Sprache spezifisch sind:
Wortgrenzen. Der Plural درختها („Bäume“) wird mit einem Zero-Width Non-Joiner (ZWNJ) geschrieben. Fehler entstehen, wenn der ZWNJ fehlt oder ersetzt wird: درختها oder درخت ها.
Wechsel der Formalität. Informelles میخوام برم („ich will gehen“) kann als formelles میخواهم بروم zurückkommen, oder umgekehrt.
He-Kasreh. Das kurze /e/, das Besitz oder Verbindung markiert, kann als Buchstabe He (ه) ausgeschrieben werden: کتاب او („sein Buch“) kann als کتابه او transkribiert werden. Das ist die ausgeschriebene Ezāfe, derselbe ungeschriebene Laut, auf den Stufe 3 zurückkommt.
Paraphrase. خوش میگذره („es macht Spaß“) kann zu حال میده („es fühlt sich gut an“) werden. Die Bedeutung bleibt erhalten, die Wörter nicht.
Halluzination. Flüssiger, kohärenter Text, der überhaupt nicht auf dem Audio beruht.
Die einfache Wortfehlerrate (WER) wertet jede Substitution als komplett falsches Wort; ein ZWNJ-Fehler kann also so viel kosten wie ein anderes Wort oder sogar mehr: Wird der ZWNJ zu einem Leerzeichen, wird aus einem Wort zwei, und das zählt als Substitution plus Einfügung. PSRB schlägt eine nach Substitutionen gewichtete Variante vor, SW-WER: Für jede Substitution wird die Zeichenfehlerrate berechnet und mit der Anzahl der Wörter in diesem Alignment multipliziert, sodass ein Leerzeichenfehler weniger kostet als ein anderes Wort. Retrieval über persischen Text muss dieselben Zeichen normalisieren, wie der Artikel Hybride Suche für persisches RAG erklärt.
Die Konsequenz für den Entwurf, so wie ich die Ergebnisse lese: Die Erkennung ist gerade bei dem Audiomaterial am schwächsten, das synchronisiert werden soll, und ein halluzinierter oder paraphrasierter Satz bleibt nicht im Transkript. Er wird zu einem selbstsicher synchronisierten Satz. Das spricht für einen Prüfpunkt vor dem Rendering. Booq bietet beide Modi: vollautomatisch durchlaufen lassen oder anhalten, um Untertitel zu prüfen und zu bearbeiten, bevor irgendetwas gerendert wird.
Speaker Diarization: Wer hat wann gesprochen?
Park und Kollegen definieren Speaker Diarization (Sprecherdiarisierung) als die Aufgabe, zu bestimmen, „wer wann gesprochen hat“. Bei einer Synchronisation entscheidet sie, welche Stimme jeder Satz erhält. Die Third DIHARD Diarization Challenge bewertete Systeme in 11 unterschiedlichen Domänen und kam zu dem Schluss, dass das Problem für viele davon, Webvideos eingeschlossen, „noch lange nicht gelöst ist“.
Die Prüfung, die ich in jeder Pipeline hinter die Diarization setzen würde, ist einfach: Hat jeder erkannte Sprecher Sätze, und hat jeder Satz einen Sprecher? Einige Systeme in PSRB ließen einen ganzen Sprecher im Transkript weg, und ein weggelassener Sprecher wird zu einer fehlenden Sprachspur.
Stufe 2: eine Übersetzung, die in die Zeit passt
Eine Synchronisation stellt die Übersetzung vor eine zusätzliche Bedingung: Der neue Satz muss in etwa der Zeit gesprochen werden, die das Original gebraucht hat. Wer frei übersetzt, zwingt die synthetische Stimme zur Eile, oder der Satz läuft in den nächsten hinein.
Isochronie: Länge und Sprechdauer sind ein einziges Problem
In der Forschung heißt das Isochronie. Chronopoulou und Kollegen (2023) beschreiben sie als neue Sprache, die zeitlich auf das Originalvideo abgestimmt ist, „einschließlich Mundbewegungen, Pausen, Handgesten“. Sie trainieren ein Modell, das die Übersetzung und ihre Sprechdauer gemeinsam optimiert, und berichten von Sprache, die besser zum Timing des Originals passt als in früheren Arbeiten, bei einer einfacheren Architektur.
Frühere Arbeiten steuerten die Länge im Text. Isometric MT (Lakew und Kollegen, ICASSP 2022) nennt als Beispielziel eine Übersetzung innerhalb von ±10 Prozent der Länge des Ausgangstexts, gemessen in Zeichen, und benennt den Preis offen: Wer die Ausgabelänge steuert, bezahlt mit Übersetzungsqualität, und die übliche Abhilfe besteht darin, mehrere Kandidatenübersetzungen (N-best-Hypothesen) zu erzeugen und sie anschließend neu zu ranken. Die ±10 Prozent sind das Beispiel eines einzelnen Papers, keine Branchenregel, und Zeichen sind nur ein Näherungswert dafür, wie lange das Aussprechen eines Satzes dauert.
Stimmt das Sprechtempo nicht, ist das Ergebnis hörbar. Die YouTube-Hilfeseite zur automatischen Synchronisation nennt das Sprechtempo unter den Gründen, aus denen ein Video möglicherweise nicht infrage kommt: Zu schnelle Originalsprache „würde zu einer beschleunigten Synchronfassung führen, die sich nicht anhören lässt“.
Wie genau muss das Timing sein?
Strenger im Bild als im Off, und gemessen an der professionellen Praxis weniger absolut, als die Forschung es oft behandelt. Brannon, Virkar und Thompson (TACL 2023) untersuchten, wie Menschen synchronisieren, anhand von 319,57 Stunden Video aus 54 professionell produzierten Titeln. Ihre Ergebnisse stellen mehrere Annahmen infrage, die in der Literatur sowohl zur menschlichen als auch zur automatischen Synchronisation verbreitet sind. Sie argumentieren, dass Natürlichkeit der Stimme und Übersetzungsqualität wichtiger sind als die üblicherweise betonten Bedingungen der Isometrie (Zeichenlänge) und der Lippensynchronität, und plädieren für eine differenziertere Sicht darauf, wie viel Timing-Bedingungen ausmachen.
Auch ob der Sprecher im Bild ist, spielt eine Rolle. Virkar und Kollegen (2022) nahmen ihr Modell für prosodischen Abgleich, das sie zuvor für die Synchronisation von Sprechern im Bild entwickelt hatten, und erweiterten es auf die Synchronisation im Off, die „weniger strenge Synchronisationsbedingungen erfordert“ als die Synchronisation eines Sprechers, dessen Mund zu sehen ist. Das Timing-Budget ist deshalb eine Entscheidung pro Szene, keine globale Einstellung.
Zu Booq lautet die veröffentlichte Aussage, dass das Timing am Original ausgerichtet wird. Mehr sagt die Fallstudie über das Timing nicht, und mehr behaupte ich hier auch nicht.
Stufe 3: eine eigene Stimme für jeden Sprecher
Bei Booq erhält jeder erkannte Sprecher eine eigene Stimme. Jede Synchronisation mit mehreren Sprechern verlangt von ihren Stimmen zwei Eigenschaften: Zwei Sprecher sollen nicht gleich klingen, und ein Sprecher soll vom ersten bis zum letzten Satz dieselbe Stimme behalten. Merken Sie sich die zweite; im Post-Mortem weiter unten geht es darum, wie sie den Kürzeren zog.
Offene persische Sprachdaten sind rar. Die Autoren von ParsVoice schreiben, Persisch sei „in offenen Sprach-Text-Ressourcen nach wie vor erheblich unterrepräsentiert“. Ihr Korpus enthält eine TTS-taugliche Teilmenge von 2.200 Stunden, mehr als 25-mal so groß wie der größte zuvor verfügbare offene persische TTS-Datensatz. Daten sind die eine Einschränkung. Die andere kommt, bevor überhaupt Audio existiert: die Entscheidung, wie der Text ausgesprochen wird.
Persische Aussprache: Kurzvokale, Ezāfe und Homographen
Von Juni 2021 bis September 2022 habe ich an Forschung zur persischen Sprachsynthese (Text-to-Speech) gearbeitet. Sie wurde von MCI (Hamrah-e Aval), dem größten Mobilfunkbetreiber Irans, beauftragt und betreut und von der National Elites Foundation im Rahmen ihres Programms „Shahid Ahmadi Roshan“ koordiniert. Das Schwierige war sprachlicher Natur. In dieser Pipeline durchläuft geschriebener Text zuerst eine Graphem-zu-Phonem-Umwandlung (G2P), die festlegt, wie er ausgesprochen wird. Ein Text-to-Speech-Modell und ein Vocoder erzeugen dann die Sprache; der Vocoder ist die Komponente, die die akustische Ausgabe des Modells in eine Audio-Wellenform umwandelt. Die persische Schrift macht den ersten Schritt auf dreierlei Weise mehrdeutig:
Kurzvokale werden nicht geschrieben, daher legt der Text allein die Aussprache nicht fest.
Die Ezāfe-Konstruktion wird ebenfalls nicht geschrieben und muss erschlossen werden.
Homographen sind verschiedene Wörter mit derselben Schreibweise und lassen sich ohne Kontext nicht unterscheiden.
Die veröffentlichte Forschung sagt dasselbe. Die Autoren von GE2PE (Findings of EMNLP 2024) beschreiben die Ezāfe als einen /e/-Laut, der Nomen mit Adjektiven und beschreibenden Nomen verbindet, und geben ein Beispiel für Homographen: /kerm/, /kerem/ und /karam/ sind in der Schrift identisch, کرم. Sie folgern, dass G2P für Persisch eine Eingabe auf Phrasen- oder Satzebene braucht, um akzeptable Ergebnisse zu erzielen. Doostmohammadi und Kollegen (2020) ergänzen, dass die Ezāfe in persischer Schrift fast immer unmarkiert bleibt, was zu Fehlern beim Lesen komplexer Sätze und in der Sprachverarbeitung führt. Das Projekt ist in der Fallstudie zur persischen Sprachsynthese beschrieben.
Die Konsequenz für den Entwurf ist meine eigene Schlussfolgerung, kein Befund dieser Paper: Füttern Sie persisches TTS nicht mit den Fragmenten, in die eine Untertitelspur geschnitten ist. Ein Untertitelumbruch kann eine Ezāfe-Kette zerteilen oder ein Homograph von den Wörtern trennen, die es eindeutig machen. Wird ketāb-e dust-e man („das Buch meines Freundes“) auf zwei Untertitel verteilt und endet das erste Fragment bei ketāb, sagt in diesem Fragment nichts mehr, dass ketāb die Ezāfe /e/ trägt. Synthetisieren Sie ganze Sätze, und passen Sie das Audio danach in die Timeline ein.
Stufe 4: Timing-Abgleich und Endmischung
Die letzte Stufe macht aus einzelnen Clips eine Tonspur, die zum Video gehört. In der Pipeline von Federico fügt das Rendering Hintergrundgeräusche und Nachhall hinzu, die aus dem Originalton extrahiert wurden, damit die neue Stimme in derselben akustischen Umgebung sitzt wie das Bild.
Bei Booq kann das fertige Ergebnis gestaltete, eingebrannte Untertitel für Hochformat- und Breitbildvideos enthalten, wobei Originalton oder Hintergrundmusik leise unter der Synchronfassung erhalten bleiben. Eingebrannte Untertitel sind Teil des Bildes; ihr Layout muss deshalb vor dem Rendering für jedes Seitenverhältnis festgelegt werden, und kein Player kann es später korrigieren.
Zu dieser Stufe gehören zwei Entwurfsfragen. Die erste: Was geschieht mit einem Satz, dessen synthetisiertes Audio auch nach der Übersetzung noch zu lang ist? Forschung und Praxis bieten drei Hebel, und die Wahl zwischen ihnen ist eine Entwurfsentscheidung, kein Befund:
Den Satz schon bei der Übersetzung kürzen. Hier setzen Isometric MT und Modelle an, die Übersetzung und Dauer gemeinsam optimieren.
Die Dauer jeder Äußerung im TTS feinjustieren. Die Pipeline von Federico justiert die Dauer pro Äußerung fein.
Die Stimme beschleunigen, in Grenzen. Dieser Hebel stammt aus der Praxis, nicht aus der Forschung, und er funktioniert nur bis zu einem gewissen Punkt: Die YouTube-Hilfeseite warnt, dass sich eine beschleunigte Synchronfassung irgendwann nicht mehr anhören lässt.
Die zweite Frage: Was hört der Zuhörer dort, wo ein Satz fehlt? Sie erwies sich als Architekturfrage, nicht als Audiofrage.
Die Plattform um die Modelle herum
Alles bisher Beschriebene ist Forschung, die man lesen kann, und Modelle, die man mieten kann. Bei Booq hängt jede Funktion von externen KI-Anbietern ab, und jeder von ihnen kann unabhängig von den anderen ausfallen oder sich ändern. Als CTO habe ich die Architektur von Booq definiert und die Plattform vom ersten Commit bis in den Produktivbetrieb gebracht; die Fallstudie zu Booq beschreibt die Plattform. Jede Lehre aus ihrem Post-Mortem liegt um die Modelle herum, nicht in ihnen.
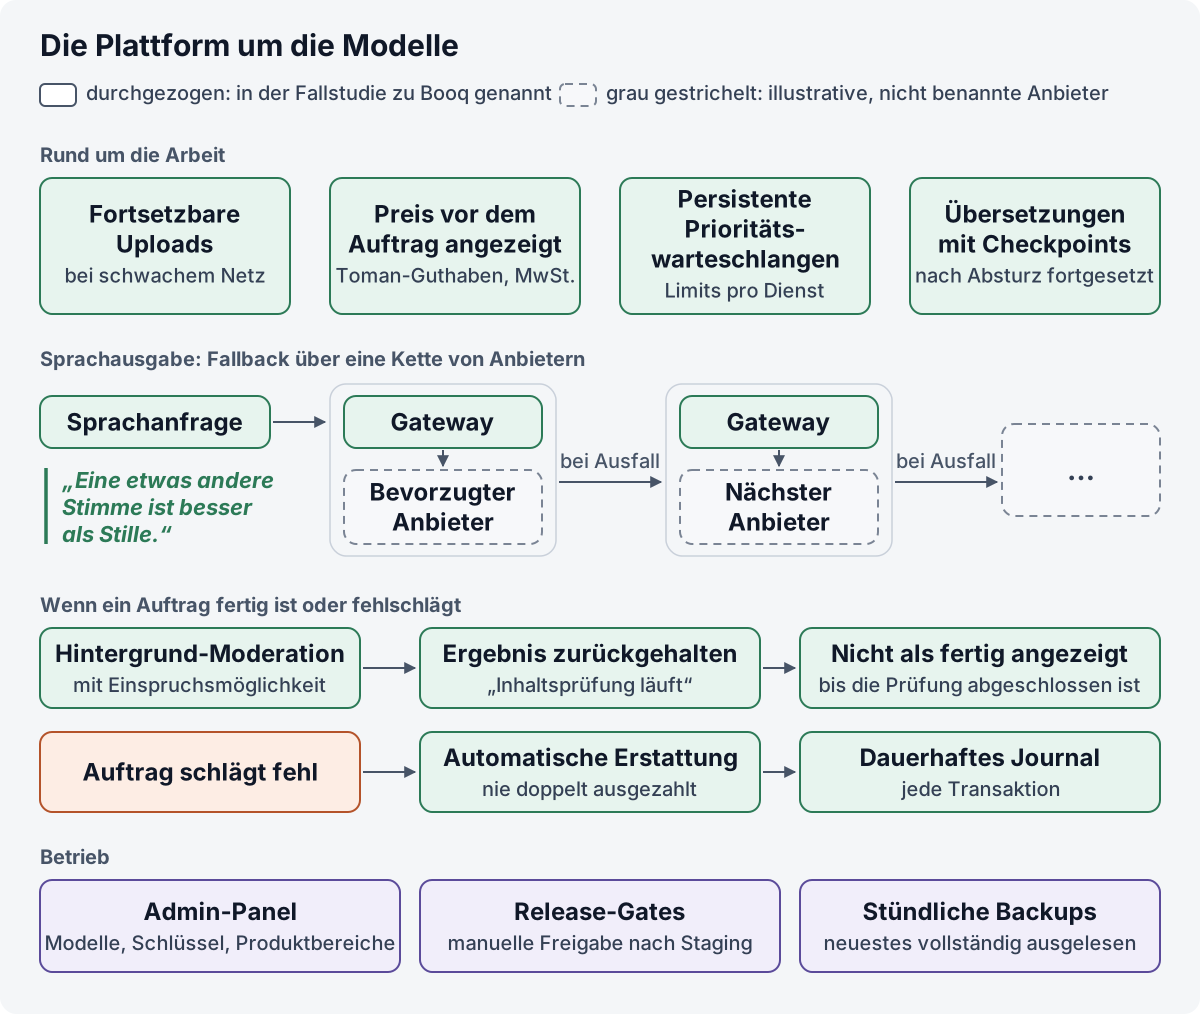
Plattformdiagramm in voller Größe öffnen

Ein Gateway pro KI-Anbieter
Booq besteht aus unabhängigen Diensten hinter einer einzigen Web-App, mit einem eigenen Gateway für jeden KI-Anbieter. Genau diese eine Entscheidung macht es möglich, ein Modell zu wechseln, einen Schlüssel auszutauschen oder einen ausfallenden Anbieter automatisch zu umgehen, ohne den Rest des Produkts anzutasten. Modelle und Anbieterschlüssel werden im Admin-Panel geändert, ohne erneutes Deployment. Die Fallstudie nennt zu jedem Gateway einen automatischen Fallback, und das Post-Mortem weiter unten zeigt, warum die Sprachausgabe ihn brauchte.
Persistente Prioritätswarteschlangen und Checkpoints
Die Synchronisation eines langen Videos gehört nicht in eine Web-Anfrage. Bei Booq wartet rechenintensive Verarbeitung stattdessen in persistenten Prioritätswarteschlangen mit Limits pro Dienst. Genau diese Limits pro Dienst verhindern, dass ein ausgelasteter Dienst die anderen aushungert.
Übersetzungen speichern Checkpoints und machen nach einem Absturz dort weiter, wo sie unterbrochen wurden. Ohne Checkpoints wiederholt ein Absturz kurz vor dem Ende eines langen Transkripts jeden Anbieteraufruf, der davor stattgefunden hat, und jeder dieser Aufrufe wird noch einmal bezahlt.
Fortsetzbare Uploads bei instabilen Verbindungen
Große Videodateien erreichen Booq über instabile Verbindungen, und Uploads, auch solche mit mehreren Gigabyte, werden bei schlechtem Netz fortgesetzt, statt von vorn zu beginnen.
Der allgemeine Mechanismus wird gerade standardisiert. Resumable Uploads for HTTP ist ein aktiver Internet-Draft der HTTP-Arbeitsgruppe der IETF, noch kein RFC: Kann der Server angeben, wie viele Daten er vor der Unterbrechung verarbeitet hat, setzt der Client an dieser Stelle fort, statt alles erneut zu senden. Das ist ein Entwurf in Arbeit, keine Beschreibung der Implementierung von Booq.
Preis vor dem Auftrag, Erstattung bei Fehlschlag
Die Abrechnung ist Teil der Pipeline. Jeder Auftrag bei Booq zeigt vor dem Start seinen Preis oder eine erste Schätzung. Das Guthabenkonto ist ein Prepaid-Konto in Toman mit vorab ausgewiesener Mehrwertsteuer, jede Transaktion landet in einem dauerhaften Transaktionsjournal, und ein fehlgeschlagener Auftrag wird automatisch erstattet. Erstattungen sind gegen doppelte Auszahlung abgesichert.
Diese letzte Eigenschaft verdient die härtesten Tests: Ein Retry nach einem Timeout ist genau der Moment, in dem eine naive Erstattung doppelt auszahlt.
Schalter statt Releases
Produktbereiche werden bei Booq ohne Release ein- oder ausgeschaltet. In Pete Hodgsons Taxonomie der Feature Toggles kommt das einem Ops Toggle nahe: einem Schalter, mit dem Betreiber eine Funktion im Produktivbetrieb schnell abschalten oder einschränken können.
Der Zugriff ist nach demselben Prinzip getrennt. Kunden, Administratoren und Supportmitarbeiter nutzen jeweils eine separat bereitgestellte App, eine Anmeldung in der einen gilt in keiner anderen, und die Konsolen verlangen einen zweiten Faktor und arbeiten mit rollenbasierten Berechtigungen.
Post-Mortem: als die Stimmkonsistenz gegen die Stille verlor
Die Sprachausgabe bei Booq war zunächst bewusst an einen einzigen Anbieter gebunden, denn ein anderer Anbieter bedeutet eine andere Stimme. Bei einer Synchronisation schien Konsistenz die Eigenschaft zu sein, die es zu schützen galt. Dann fiel dieser Anbieter aus, und Synchronfassungen wurden mit Stille an den Stellen zusammengesetzt, an denen Sätze fehlten.
Heute greift die Sprachausgabe auf eine Fallback-Kette aus mehreren Anbietern zurück, nach dem Grundsatz, dass eine etwas andere Stimme besser ist als Stille.
Eine Fallback-Kette bewusst entwerfen
Die ursprüngliche Wahl war nicht leichtfertig; sie schützte eine echte Eigenschaft. Die Fallstudie fasst die Kurskorrekturen zusammen, zu denen der Produktivbetrieb der Plattform führte: Jede davon „ersetzte eine bequeme Annahme durch einen sichereren Standard“. Die Lehre: Entscheiden Sie, welchen Fehler Sie in Kauf nehmen, bevor ein Ausfall es für Sie entscheidet. Ist der bevorzugte Anbieter für die Sprachausgabe ausgefallen, kann eine Pipeline eine Lücke lassen, den Auftrag als fehlgeschlagen beenden und erstatten oder eine andere Stimme verwenden. Nur die Lücke liefert dem Zuhörer eine Synchronfassung mit Löchern.
Daraus folgt eine zweite Entscheidung, und was jetzt kommt, ist meine Analyse, keine Beschreibung von Booq: wie viel ein Fallback ersetzt. Wechselt nur der fehlende Satz den Anbieter, ändert sich die Stimme dieses Sprechers mitten in der Szene. Wechselt die gesamte Spur des Sprechers, bleibt die Synchronfassung konsistent, aber mehr Arbeit muss neu erledigt werden.
Das SRE-Buch von Google beschreibt für überlastete Dienste eine verwandte Idee, Graceful Degradation: weniger Arbeit leisten, indem man die Qualität der Antworten senkt. Übertragbar ist seine Warnung, dass „der Codepfad, den man nie benutzt, der Codepfad ist, der (oft) nicht funktioniert“, und sein Rat, den eingeschränkten Modus regelmäßig zu üben. Was ich jeder Fallback-Kette für die Sprachausgabe hinzufügen würde, als Empfehlung und nicht als Beschreibung von Booq: geplante Testaufträge mit internen Clips über jeden Anbieter der Kette, damit feststeht, dass der Fallback funktioniert, bevor ein Ausfall ihn braucht.
Welcher Fehler der richtige ist, hängt vom Produkt ab. Der Assistent auf dieser Website macht das Gegenteil: Findet sich auf der Website nichts, was eine Frage stützt, lehnt er sie mit einem festen Text ab, statt zu raten, und betrifft die Frage aus seiner Sicht nicht mich, wird das Sprachmodell gar nicht erst aufgerufen. Beim Beantworten von Fragen ist Schweigen der sichere Fehler, denn eine selbstsichere falsche Antwort ist schlimmer als keine Antwort. Das Design beschreibt der Artikel Guardrails gegen RAG-Halluzinationen, und die Seite RAG mit und ohne Retrieval im KI-Labor beruht auf derselben Regel. Bei einer Synchronisation ist Stille der Fehler. Welcher Fehler akzeptabel ist, ist eine Produktentscheidung, keine Modellentscheidung.
Moderation, ohne Nutzer warten zu lassen
Die Inhaltsprüfung lief bei Booq früher innerhalb der Projekterstellung, sodass Nutzer zwischen dem abgeschlossenen Upload und ihrer Projektseite warten mussten. Heute läuft sie im Hintergrund. Bilder, Videos, Audio und Text werden geprüft, mit der Möglichkeit zum Einspruch, und ein fertiges Ergebnis bleibt im Status „Inhaltsprüfung läuft“, bis die Prüfung abgeschlossen ist. Kein Ergebnis wird als fertig präsentiert, solange seine Prüfung noch läuft.
Das Muster lässt sich auf jede langsame Prüfung in einer Medien-Pipeline übertragen: Nehmen Sie sie aus dem Request-Pfad, und machen Sie den Zwischenzustand explizit.
Release-Gates und Backups, die jemand gelesen hat
Produktions-Deployments laufen bei Booq nicht mehr automatisch, sondern erfordern eine manuelle Freigabe, die erst nach bestandenen Staging-Prüfungen möglich wird. Jedes Release durchläuft Build, Tests, ein Staging-Deployment und einen Smoke-Test, bevor ein Mensch es für den Produktivbetrieb freigibt, und ein Notfall-Rollback auf die vorherige Version lässt sich manuell auslösen. Die Plattform läuft auf einem als Code definierten Container-Cluster.
Backups laufen jetzt stündlich, und das neueste wurde vollständig ausgelesen, denn ein Backup, das nie jemand gelesen hat, ist kein Backup. Das SRE-Buch von Google sagt es noch deutlicher: „Niemand will wirklich Backups machen; was die Leute wirklich wollen, sind Wiederherstellungen.“ Es legt die Latte auch höher: Man weiß nur dann, dass man den jüngsten Zustand wiederherstellen kann, wenn man es tatsächlich tut; Wiederherstellungstests sollten daher, wo immer möglich, automatisiert sein und kontinuierlich laufen. Ein Backup vollständig auszulesen ist das Minimum, nicht die Ziellinie.
Selbst bauen oder einkaufen: Checkliste für jede KI-Dubbing-Pipeline
Fehler und Fallback
Wenn ein Anbieter für die Sprachausgabe mitten im Auftrag ausfällt, was bekommt der Zuhörer: Stille, eine andere Stimme oder einen fehlgeschlagenen Auftrag mit Erstattung? Entscheiden Sie es, bevor ein Ausfall es entscheidet.
Wenn der Fallback greift, ersetzt er einen einzelnen Satz oder die gesamte Spur des Sprechers?
Wird der Fallback-Pfad gezielt geübt, mit geplanten Testaufträgen, oder nur bei Ausfällen?
Plattform und Abrechnung
Liegt jeder KI-Anbieter hinter einem eigenen Gateway, sodass ein Modellwechsel, ein Schlüsseltausch oder das Umgehen eines Anbieters kein Release ist?
Läuft rechenintensive Arbeit aus persistenten Warteschlangen mit Limits pro Dienst, außerhalb der Web-Anfrage?
Kann eine lange Übersetzung an einem Checkpoint wieder ansetzen, und kann ein großer Upload nach einem Verbindungsabbruch fortgesetzt werden?
Wird der Preis oder die Schätzung angezeigt, bevor der Auftrag läuft, und ist ausgeschlossen, dass eine Erstattung doppelt ausgezahlt wird?
Liegt die Moderation außerhalb des Request-Pfads, mit einem expliziten Status „in Prüfung“?
Erkennung, Timing und Stimmen
Wurde die Erkennung mit Ihrem eigenen Audio getestet: Akzente, Kinder, informelle Sprache, mehrere Sprecher, Ton aus Filmen und Talkshows, nicht nur Hörbücher?
Wertet Ihre WER-Berechnung einen ZWNJ-Leerzeichenfehler als komplett falsches Wort? Normalisieren Sie zuerst, oder verwenden Sie eine gewichtete Metrik wie SW-WER.
Hat nach der Diarization jeder erkannte Sprecher Sätze und eine Stimme?
Gibt es einen Punkt, an dem Untertitel vor dem Rendering geprüft und bearbeitet werden können?
Wie genau muss das Timing für diesen Inhalt sein: Gesichter im Bild oder Erzählstimme im Off?
Erhält persisches TTS ganze Sätze statt Untertitelfragmenten, die eine Ezāfe-Kette zerschneiden?
Release und Wiederherstellung
Gibt ein Mensch den Produktivbetrieb nach Staging- und Smoke-Prüfungen frei, und können Sie manuell zurückrollen?
Hat jemand ein Backup vollständig ausgelesen?
Häufige Fragen
Wie funktioniert KI-Synchronisation?
Eine KI-Dubbing-Pipeline transkribiert die Originalsprache und erkennt, wer spricht, übersetzt jeden Satz so, dass er in etwa der ursprünglichen Zeit gesprochen werden kann, gibt jedem Sprecher eine eigene synthetische Stimme, gleicht dann das Timing ab und mischt die neue Sprache mit dem Hintergrund des Originals. Im Produktivbetrieb laufen diese Stufen innerhalb einer Plattform aus Warteschlangen, Anbieter-Gateways mit Fallback und idealerweise einem Prüfpunkt vor dem Rendering.
Kann KI englische Videos ins Persische synchronisieren?
Technisch ja: Die Kette ist für jedes Sprachpaar dieselbe. Die Synchronisation ins Persische bringt in der Stimmstufe ein sprachspezifisches Problem mit sich, weil die Schrift Kurzvokale und die Ezāfe ungeschrieben lässt; die Aussprache muss daher aus dem Kontext erschlossen werden. Die Unterstützung durch verbreitete Dienste ist uneinheitlich: Mit Stand September 2026 führt die YouTube-Hilfeseite zur automatischen Synchronisation Farsi als Ausgangssprache auf, die ins Englische synchronisiert wird, und englische Videos sind dort nicht als ins Farsi synchronisierbar aufgeführt.
Ist KI-Synchronisation lippensynchron?
Nicht zwingend, und sie muss es auch nicht immer sein. Die Isochronie-Forschung setzt sich dieses Ziel: neue Sprache, die zeitlich auf das Originalvideo abgestimmt ist, einschließlich Mundbewegungen, Pausen und Gesten. Wie eng die Übereinstimmung sein soll, ist eine Entwurfsentscheidung. Die Synchronisation im Off braucht eine weniger strenge Synchronität als die eines Sprechers, dessen Mund zu sehen ist, und eine große Studie über professionelle menschliche Synchronisation argumentiert, dass Natürlichkeit der Stimme und Übersetzungsqualität wichtiger sind als die üblicherweise betonten Anforderungen an die Lippensynchronität.
Warum enthält eine KI-Synchronfassung manchmal Stille oder eine andere Stimme?
Eine Ursache ist ein Anbieter für die Sprachausgabe, der mitten im Auftrag ausfällt. Eine an einen einzigen Anbieter gebundene Pipeline hält die Stimmen konsistent, kann bei einem Ausfall aber Lücken lassen; eine Pipeline mit Fallback-Kette füllt den Satz mit einer etwas anderen Stimme. Booq ist vom ersten zum zweiten Design gewechselt, nachdem ein Ausfall Synchronfassungen mit Stille an den Stellen erzeugt hatte, an denen Sätze fehlten. Stille kann auch weiter vorn in der Pipeline entstehen, wenn die Erkennung einen Sprecher weglässt und nichts zum Übersetzen übrig bleibt.
Wie sollte man Spracherkennung für Persisch evaluieren?
Mit Ihrem eigenen Audio, nicht nur mit sauber vorgelesener Sprache. Nehmen Sie regionale Akzente, Kinderstimmen, mehrere Sprecher und Ton aus Filmen oder Talkshows auf, alles Bedingungen, unter denen PSRB mehr Fehler fand, dazu informelle Sprache. Normalisieren Sie vor der Bewertung den ZWNJ sowie die arabischen und persischen Formen der Buchstaben Yeh und Kaf, oder verwenden Sie eine nach Substitutionen gewichtete Metrik wie SW-WER, und lesen Sie neben der Rate auch die Fehler selbst: Eine einzelne Zahl unterscheidet nicht zwischen einem Leerzeichenfehler und einem flüssigen Satz, den der Sprecher nie gesagt hat.
Wenn Sie ein Vorhaben zu Sprache oder Synchronisation abwägen: Der Service Sprach-KI umfasst TTS, ASR und Dubbing-Pipelines, einschließlich der schwierigen Fälle im Persischen.
Quellen
Booq: KI-gestützte Videoübersetzung und Synchronisation mit Fokus auf Persisch, Fallstudie auf dieser Website
Forschung zu persischer Sprachsynthese für MCI, Fallstudie auf dieser Website
Sedghiyeh et al., PSRB: A Comprehensive Benchmark for Evaluating Persian ASR Systems, arXiv, 2025 (Volltext)
Federico et al., From Speech-to-Speech Translation to Automatic Dubbing, arXiv, 2020
Chronopoulou et al., Jointly Optimizing Translations and Speech Timing to Improve Isochrony in Automatic Dubbing, arXiv, 2023
Lakew et al., Isometric MT: Neural Machine Translation for Automatic Dubbing, ICASSP 2022
Virkar et al., Prosodic Alignment for off-screen automatic dubbing, arXiv, 2022
Brannon, Virkar und Thompson, Dubbing in Practice: A Large Scale Study of Human Localization With Insights for Automatic Dubbing, TACL, 2023
YouTube-Hilfe, Use automatic dubbing, geprüft im September 2026
Park et al., A Review of Speaker Diarization: Recent Advances with Deep Learning, Computer Speech & Language, 2022
Ryant et al., The Third DIHARD Diarization Challenge, arXiv, 2020
Rahmati und Sameti, GE2PE: Persian End-to-End Grapheme-to-Phoneme Conversion, Findings of EMNLP 2024
Doostmohammadi et al., Persian Ezafe Recognition Using Transformers and Its Role in Part-Of-Speech Tagging, arXiv, 2020
Ranjbar Kalahroodi, Faili und Shakery, ParsVoice: A Large-Scale Multi-Speaker Persian Speech Corpus for Text-to-Speech Synthesis, EMNLP 2026 (angenommen; arXiv v4, September 2026)
Google, Site Reliability Engineering: Addressing Cascading Failures
Google, Site Reliability Engineering: Data Integrity: What You Read Is What You Wrote
IETF HTTP Working Group, Resumable Uploads for HTTP, Internet-Draft
Pete Hodgson, Feature Toggles (aka Feature Flags), martinfowler.com, 2016, überarbeitet 2017