
Guardrails gegen RAG-Halluzinationen: ein Design in fünf Schichten
Fünf Guardrails gegen erfundene Antworten in RAG: Ablehnung vor dem Retrieval, Ähnlichkeitsschwelle, System-Prompt, Satz-Gate und Regeln für die Stimme.
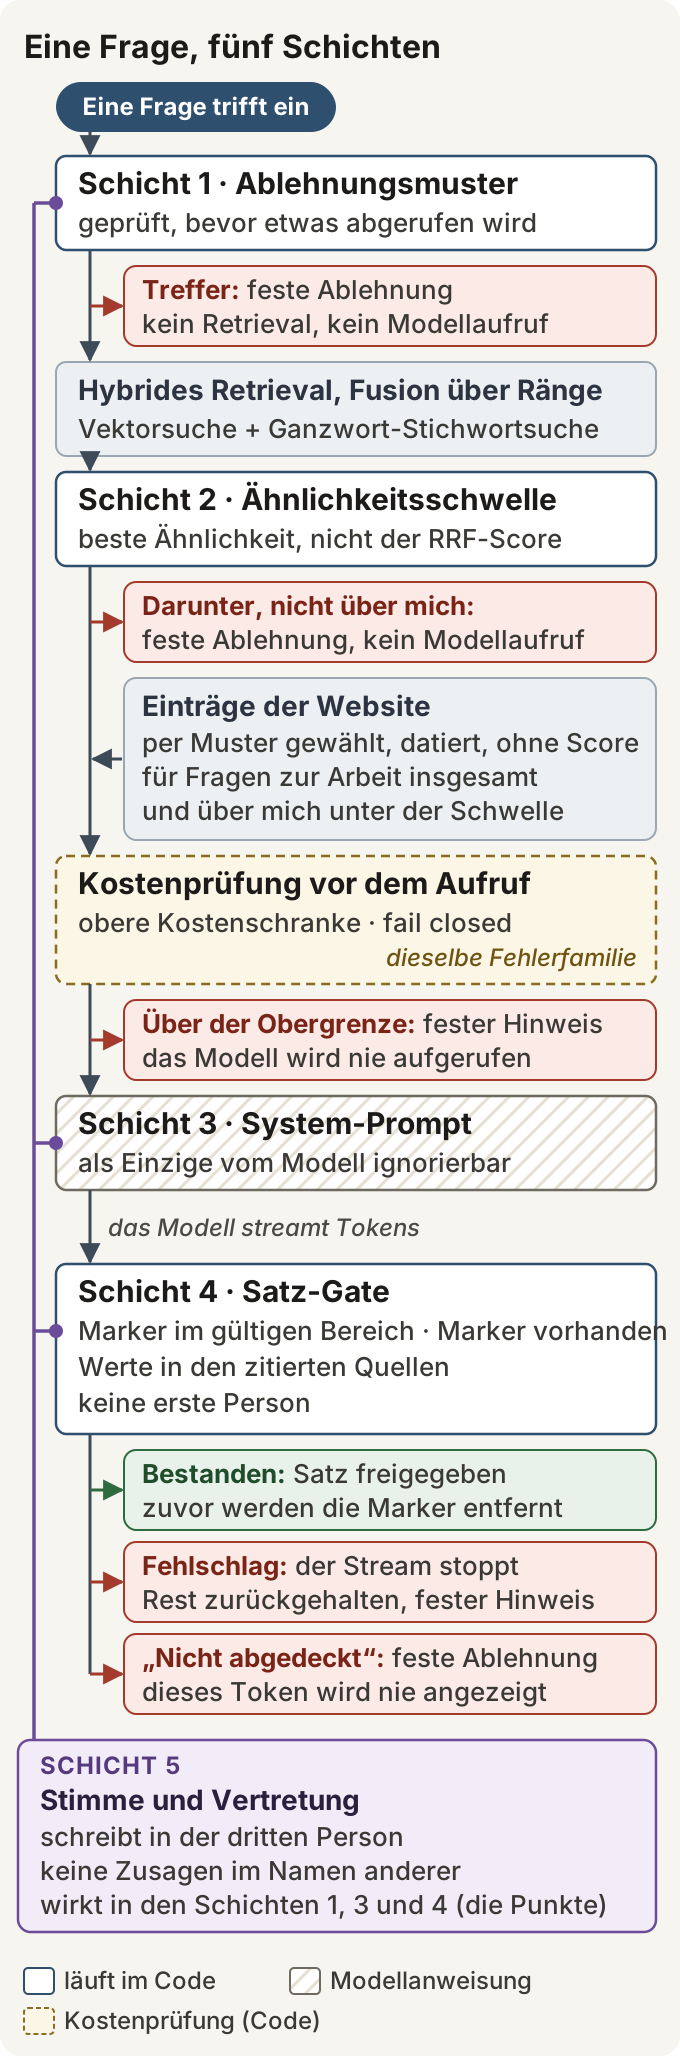
Retrieval-Augmented Generation (RAG) hindert ein Modell nicht daran, Antworten zu erfinden, und schwacher Kontext kann es selbstsicherer machen statt vorsichtiger. Guardrails gegen RAG-Halluzinationen gehören deshalb überwiegend in den Code rund um das Modell. Bauen Sie sie als fünf Schichten in fester Reihenfolge, so wie der Assistent dieser Website arbeitet:
Fragen, die der Assistent nie beantworten darf, schon vor dem Retrieval ablehnen.
Dem Modell nur Belege geben, an denen sich seine Antwort messen lässt: Passagen, die eine Ähnlichkeitsschwelle erreichen, oder die eigenen Einträge der Website für Fragen zur Arbeit insgesamt. Gibt es keins von beiden, ohne Modellaufruf ablehnen.
Den System-Prompt als die eine Schicht behandeln, die das Modell ignorieren kann.
Die Antwort Satz für Satz freigeben, erst nach deterministischen Prüfungen.
Den Assistenten nie als die Person sprechen lassen, die hinter ihm steht.
Eine Kostenprüfung vor dem Modellaufruf vervollständigt das Design.
Ich habe diese Website gebaut und betreue sie, den Assistenten eingeschlossen. Ich veröffentliche keine Genauigkeitszahl für ihn; der Abschnitt über die Messung erklärt, warum.
Warum RAG weiterhin halluziniert
In einem RAG-System liefert ein Retriever Passagen aus einem Korpus, und das Sprachmodell schreibt seine Antwort daraus. Eine Halluzination ist eine falsche oder unbelegte Aussage, vorgetragen, als wäre sie wahr.
Retrieval verengt, was ein Modell wahrscheinlich sagt. Es setzt ihm keine Grenze.
Retrieval kann ein Modell selbstsicherer machen, nicht korrekter
Forschende bei Google haben zwei Fälle getrennt: abgerufenen Kontext, der zur Beantwortung der Frage ausreicht, und Kontext, der das nicht tut. In der Zusammenfassung ihres Papers, das auf der ICLR 2025 vorgestellt wurde, werden die Autoren deutlich: RAG verbessere zwar „im Allgemeinen die Gesamtleistung“, verringere aber „paradoxerweise die Fähigkeit des Modells, sich einer Antwort zu enthalten, wenn das angebracht wäre“. In einem Beispiel gab Gemma ohne Kontext auf 10,2 Prozent der Fragen falsche Antworten, mit unzureichendem Kontext auf 66,1 Prozent.
Zu wissen, wann man nicht antwortet, zahlt sich aus: Die selektive Generierung der Autoren erhöhte den Anteil richtiger Antworten unter den Fällen, in denen das Modell antwortete, für Gemini, GPT und Gemma um 2 bis 10 Prozent.
Ein Top-k-Retriever liefert k Passagen, ob eine davon relevant ist oder nicht. Urteilt allein das Modell darüber, ob sie ausreichen, liegt die Entscheidung zur Enthaltung bei genau der Komponente, die laut dieser Forschung dabei oft danebenliegt.
Modelle werden fürs Raten belohnt
Kalai und Kollegen argumentieren, Sprachmodelle halluzinierten, „weil die Trainings- und Evaluationsverfahren das Raten stärker belohnen als das Eingeständnis von Unsicherheit“. Wenn eine Bewertung für „Ich weiß es nicht“ keine Punkte vergibt, hebt Raten den Score. Eine Anweisung, Unsicherheit einzuräumen, arbeitet gegen diesen Anreiz. Sie hilft. Eine Kontrolle ist sie nicht.
Auch kommerzielle Rechtstools halluzinierten
Manche Anbieter juristischer Recherchewerkzeuge hatten RAG als etwas beworben, das Halluzinationen „beseitigt“. Die erste präregistrierte Evaluation KI-gestützter Werkzeuge für die juristische Recherche ergab, dass der Anteil halluzinierter Antworten bei den Produkten von LexisNexis und Thomson Reuters jeweils zwischen 17 Prozent und 33 Prozent lag. Was das für juristische Produkte bedeutet, behandelt Was man gegen Halluzinationen juristischer KI bauen sollte.
Die fünf Schichten im Überblick
Schicht | Was sie verhindert | Läuft in | Wenn sie greift |
|---|---|---|---|
1. Ablehnungsmuster | Antworten, die der Assistent nie geben darf | Code | Feste Ablehnung vor dem Retrieval |
2. Ähnlichkeitsschwelle | Antworten auf schwacher Beleglage | Code | Feste Ablehnung, kein Modellaufruf |
3. System-Prompt | Regelbrüche, sofern das Modell mitspielt | Im Modell | Nichts erzwingt ihn von allein |
4. Satz-Gate | Unbelegte Aussagen, erfundene Werte, erste Person | Code | Stream stoppt, der Rest wird zurückgehalten |
5. Regeln für die Stimme | Zusagen im Namen eines anderen | Code und Prompt | Über die Schichten 1, 3 und 4 |
Die Reihenfolge zählt so viel wie die Schichten selbst. Beide Ablehnungsschichten laufen, bevor das Sprachmodell aufgerufen wird, und auf den Prompt, die einzige Schicht, die von der Kooperation des Modells abhängt, folgt eine deterministische Prüfung. Die Kostenprüfung zwischen Schwelle und Prompt verhindert keine Erfindungen, gehört aber zur selben Fehlerfamilie.
Schicht 1: ablehnen, bevor Sie abrufen
Der erste Fehler ist nicht die fehlende Antwort. Es ist eine Antwort, die es gar nicht geben dürfte.
Fragen, die Ihr Korpus beantworten kann, Ihr Assistent aber nicht beantworten darf
Auf dieser Website würde eine Frage nach Honoraren die Leistungsseite abrufen. Der Text ist relevant, und genau daraus zu antworten ist der Fehler: Jede Zahl, jedes Datum und jede Zusage, die das Modell aus dieser Seite zusammensetzt, ist eine Erklärung, die niemand abgegeben hat. Relevanz ist keine Erlaubnis.
Manche Fragen werden deshalb abgelehnt, bevor irgendetwas eingebettet oder abgerufen wird:
Konditionen einer Zusammenarbeit: Honorare, Verfügbarkeit und Beauftragung.
Private Angaben, die die Website bewusst nicht veröffentlicht, etwa Telefonnummer, Wohnanschrift, Familienstand, Wehrdienststatus oder Geburtsdatum.
Spekulation: Prognosen und Vergleiche mit namentlich genannten Personen.
Meta-Anfragen, die die Anweisungen auslesen oder überschreiben wollen.
Arbeitsaufträge: Code oder Texte schreiben, etwas übersetzen oder lösen, statt nach den veröffentlichten Arbeiten zu fragen.
Der Ablehnungstext ist fester Text, keine Modellausgabe: Eine Ablehnung, die das Modell schreibt, ist eine Ablehnung, aus der sich das Modell auch wieder herausreden kann. Die Clients für den Embedder (das Modell, das Text in Vektoren verwandelt) und für das Sprachmodell werden erst bei Bedarf erzeugt; eine Ablehnung an dieser Stelle löst also keinen externen Aufruf aus.
Schreiben Sie für Ihr eigenes System die Fragen auf, deren richtige Antwort „nicht von diesem Assistenten“ lautet, ganz gleich, was im Korpus steht.
Muster statt Klassifikator
Die Ablehnungsmenge besteht aus regulären Ausdrücken für Englisch und Persisch und aus Phrasenlisten für die acht übrigen Sprachen der Website, alle angewendet auf eine für den Abgleich normalisierte Frage: kleingeschrieben, arabische Buchstabenformen auf die persischen abgebildet, persische und arabische Ziffern auf lateinische, arabische Vokalzeichen entfernt und der Zero-Width Non-Joiner innerhalb persischer Wörter durch ein Leerzeichen ersetzt. Die Frage wird außerdem mit meinem Namen als Pronomen gelesen, sodass „what are Mohammad Panahi’s rates?“ abgelehnt wird wie „what are his rates?“, und eine Anschlussfrage wird zusammen mit der Frage davor geprüft.
Ein Klassifikator ist das nicht. Ein Klassifikator, der meistens richtigliegt, bleibt ein Versprechen, das diese Website nicht geben kann, denn seine Fehlschläge sind Zusagen im Namen einer Person.
Die Grenze liegt auf der Hand: Muster erkennen Umformulierungen nicht. Die persische Schreibweise gehört nicht zu diesen Lücken. Weil die Normalisierung aus einem Zero-Width Non-Joiner ein Leerzeichen macht, kommt ein Wort, das die Standardorthografie zusammenschreibt, getrennt bei den Mustern an, und jedes persische Muster akzeptiert beide Formen; چقدر میگیرد und چقدر میگیرد werden also beide abgelehnt. Eine Frage in Worten, die die Liste nicht kennt, kommt trotzdem durch, und dafür sind die späteren Schichten da: Der Prompt verbietet Honorare und Verfügbarkeit, und das Gate stoppt einen Satz, der ein erkanntes Wort in der ersten Person oder eine Zahl enthält, die in den Quellen nicht vorkommt. Das verkleinert die Lücke. Es schließt sie nicht. Die Listen für andere Sprachen als Englisch und Persisch sind kürzer, und Umformulierungen kommen dort öfter durch.
Schicht 2: eine Ähnlichkeitsschwelle, die den Modellaufruf überspringt
Nach dem Retrieval nimmt der Assistent die beste Ähnlichkeit zwischen der Frage und den Passagen, die er dem Modell übergeben würde. Unterhalb einer Schwelle wird eine Frage, die nicht mich betrifft, mit festem Text abgelehnt, und das Sprachmodell wird nie aufgerufen. Kostenlos ist diese Ablehnung nicht, denn im Produktivbetrieb hat eine gehostete API die Frage bereits eingebettet; sie spart aber den Generierungsaufruf, sodass aus schwachen Belegen nie eine flüssige Antwort wird. Fragen, die mich betreffen, nehmen einen anderen Weg, der weiter unten beschrieben ist, denn ein Ähnlichkeitswert kann eine allgemeine Frage zur Arbeit eines Menschen nicht von einer themenfremden unterscheiden.
Warum sich ein Reciprocal-Rank-Fusion-Score nicht als Schwelle eignet
Der Retriever ist hybrid: dichte Vektorsuche und Stichwortsuche auf ganzen Wörtern, fusioniert mit Reciprocal Rank Fusion (RRF). Wie das mit Persisch und Englisch nebeneinander umgeht, steht in hybride Suche für RAG auf Persisch.
RRF ist ein guter Weg, Rankings zu kombinieren, und eine schlechte Zahl für eine Schwelle. In der Formulierung von Cormack, Clarke und Büttcher ist der Score eines Dokuments die Summe von 1/(k + r(d)) über die Rankings, wobei r(d) sein Rang in der jeweiligen Liste ist und k = 60 „in einer Pilotuntersuchung festgelegt“ wurde. Der Score entsteht allein aus Positionen; deshalb liefert selbst ein Korpus aus reinem Rauschen ein erstplatziertes Dokument mit dem besten verfügbaren fusionierten Score. Eine Schwelle auf dieser Zahl misst den Rang, nicht die Relevanz.
Womit die Schwelle stattdessen vergleicht
Jeder Retriever, der eine beschränkte Ähnlichkeit liefern kann, meldet eine:
Die Vektorsuche meldet die Kosinusähnlichkeit, auf den Bereich 0 bis 1 begrenzt. Die Schwelle nutzt die Ähnlichkeit zur Frage, wie sie gestellt wurde, und bei einer Anschlussfrage zur Frage zusammen mit der vorherigen. Ist eine Anschlussfrage als Position in einer Liste formuliert, etwa „das zweite“, kommt der Eintrag hinzu, auf den sie zeigt: Die Position wird aus der Frage gelesen, die Liste aus der vorherigen Antwort, anhand der Titel und Namen der Website oder dessen, was die Antwort zitiert, und dem Modell wird gesagt, welcher Eintrag gemeint ist. Der Eintrag kommt nur hinzu, wenn sich Position und Liste zweifelsfrei lesen lassen; sonst kommt stattdessen der Anfang der vorherigen Antwort hinzu. Geprüft wird die Formulierung, nicht die Antwort: Auch eine themenfremde Anschlussfrage, die zufällig „das zweite“ sagt, bekommt den Anfang der Antwort dazu und kann die Schwelle überschreiten; Prompt und Gate stehen dann immer noch dahinter. Betrifft eine Frage mich, sucht das Retrieval zusätzlich mit meinem Namen in der Anfrage. Das hilft beim Ordnen der Passagen, zählt aber nie für die Schwelle: Ein Name lässt jede Frage über mich nah am Lebenslauf erscheinen, auch solche, die die Website nicht beantworten kann.
Die Stichwortsuche meldet die Abdeckung: den Anteil der inhaltstragenden Wörter der Frage, drei Zeichen oder länger (im Chinesischen zwei), die als ganze Wörter in der Passage vorkommen. Häufige Wörter werden vorher entfernt, in jeder Sprache der Website, und die Abdeckung zählt für die Schwelle nur, wenn mindestens zwei verschiedene Inhaltswörter treffen. Ein einzelner Treffer ist Zufall. Bei einer Anschlussfrage, die nur sagt, welcher Eintrag gemeint ist, etwa „Erzähl mir mehr über das zweite“, sind die Inhaltswörter die des Titels oder Namens, den die Website diesem Eintrag gibt.
Jede Passage behält den höheren der beiden Werte, und die Schwelle wird mit dem besten Wert über die zurückgegebenen Passagen verglichen; die Passage, die ihn liefert, ist immer darunter. Der fusionierte Score entscheidet nur die Reihenfolge.
Ganze Wörter sind wichtig. Gleicht man stattdessen Teilzeichenketten ab, steckt „Art“ in „Start“, und Fragen ohne Bezug sehen auf einmal wie Belege aus. Ist der Embedding-Dienst nicht erreichbar, fällt das Retrieval auf die reine Stichwortsuche zurück, und die Schwelle gilt weiter.
Fragen, die kein Ähnlichkeitswert beantworten kann
„Was hat er in letzter Zeit gemacht?“ hat keinen nächsten Nachbarn. Die Antwort ist eine nach Datum sortierte Liste, und keine Passage ähnelt so etwas: Mit dem Embedder dieser Website erzielte die Frage einen niedrigeren Wert als eine Frage nach dem Wetter. Fragen zur Arbeit insgesamt werden deshalb über Muster in allen zehn Sprachen der Website erkannt, wie die Ablehnungsmenge. Das umfasst, was ich jetzt oder zuletzt mache, meinen Werdegang, Projekte, Forschung, Texte, Ausbildung, Fähigkeiten und Leistungen. Beantwortet werden solche Fragen aus den Einträgen der Website: Einträgen aus dem Lebenslauf, den Fallstudien, den Artikeln und den Leistungen, die für jede Frage aus der Datenbank gelesen werden. Die Einträge kommen in der Sprache des Lesers, wo es eine Übersetzung gibt, und die datierten werden nach ihren eigenen Daten sortiert, die neuesten zuerst.
Einträge werden per Regel ausgewählt, nicht per Ähnlichkeit, deshalb gilt die Schwelle für sie nicht. Von nichts anderem sind sie ausgenommen: Die Ablehnungsmuster laufen zuerst, jeder datierte Eintrag trägt seine Daten in der Genauigkeit, in der die Website sie zeigt, und jeder Satz, der auf einem Eintrag aufbaut, durchläuft dasselbe Gate.
Eine Frage über mich, die die Muster nicht zu den Einträgen leiten und die keine Passage stützt, bekommt statt einer Ablehnung einen kurzen Überblick aus diesen Einträgen, denn eine falsche Ablehnung würde dem Leser dort sagen, die Website behandle etwas nicht, das sie behandelt. Beantworten auch die Einträge sie nicht, ist das Modell angewiesen, statt Fließtext ein festes Token zu antworten, und der Leser sieht dieselbe feste Ablehnung. So wird das Urteil des Modells zu einem weiteren Weg zur Ablehnung. Eine Ablehnung verwandelt es nie in eine Antwort.
So wählen Sie eine Ähnlichkeitsschwelle für RAG
Eine übertragbare Zahl gibt es nicht. Die Kosinusähnlichkeit hängt vom Embedding-Modell, der Sprachmischung und dem Korpus ab; eine Schwelle, die zu einem Embedder passt, kann bei einem anderen alles ablehnen oder nichts.
Als Standardwert sieht das Design dieser Website 0,35 vor, und die Testsuite lässt mit diesem Wert einen Ersatz-Embedder laufen, ein Modell, das ausschließlich in Tests läuft. Gegen den produktiv eingesetzten Embedder ist er noch nicht kalibriert. Ein Befehl, der nur das Retrieval ausführt, schickt die Fragen des Golden Sets und die vorgeschlagenen Fragen der Website durch den ausgerollten Embedder, ohne das Modell aufzurufen, und der Wert in Produktion ändert sich nur, wenn dieser Lauf besteht. Die 0,35 ist kein Wert zum Abschreiben. So bestimmen Sie Ihren:
Lassen Sie Fragen, die der Assistent beantworten muss, und Fragen, die er ablehnen muss, durch den Embedder laufen, den Sie ausrollen, und vergleichen Sie die beiden Verteilungen der besten Ähnlichkeit.
Entscheiden Sie, wie viele beantwortbare Fragen Sie aufgeben, um die abzulehnenden zu stoppen. Wo eine selbstsichere falsche Antwort schlimmer ist als keine Antwort, setzen Sie die Schwelle höher.
Halten Sie fest, zu welchem Embedder und welchem Korpus die Zahl gehört. Jede Seite, die in den Korpus kommt, verändert, worauf eine themenfremde Frage passen kann, dieser Artikel eingeschlossen.
Die Demo RAG vs. ohne ist genau um diese Grenze herum gebaut. Sie hat keinen Pfad ohne Quellen: Eine Frage, die nichts mit mir zu tun hat und die keine Passage stützt, endet, bevor das Sprachmodell erreicht wird.
Schicht 3: Der System-Prompt ist die einzige Schicht, die ein Modell ignorieren kann
Der Prompt leistet trotzdem echte Arbeit. Er weist das Modell an, nur die nummerierten Quellen zu verwenden, die mit der Frage geliefert werden, über mich in der dritten Person und in der Sprache des Lesers zu schreiben, nie Verfügbarkeit, Honorare oder Termine zu nennen, nie eine Zahl oder ein Datum zu erfinden oder zu berechnen, „derzeit“ nur über das zu sagen, was ein Eintrag als aktuell ausweist, jeden Satz, der eine Tatsache nennt, mit einem Quellenmarker zu beenden und mit einem festen Token zu antworten, wenn die Quellen die Frage nicht abdecken.
Erzwingen kann er nichts davon. Der OWASP-Eintrag LLM07:2025 System Prompt Leakage empfiehlt Guardrails außerhalb des Modells, denn ein unabhängiges System, das die Ausgabe prüft, „ist Anweisungen im System-Prompt vorzuziehen“. Die Anleitung von Anthropic zur Verringerung von Halluzinationen, zu der auch gehört, dem Modell ein „Ich weiß es nicht“ zu erlauben, ist ebenso offen: Diese Techniken „verringern Halluzinationen erheblich, beseitigen sie aber nicht vollständig“.
Der Prompt ist deshalb unter der Annahme geschrieben, dass er manchmal ignoriert wird. Seine Aufgabe ist, Regeltreue zum einfachsten Weg zu machen, und jede riskante Anweisung hat ein deterministisches Gegenstück:
Anweisung im Prompt | Deterministisches Gegenstück |
|---|---|
Ein Quellenmarker an jedem Satz, der eine Tatsache nennt | Das Gate prüft, ob der Marker vorhanden und im gültigen Bereich ist |
Nie eine Zahl erfinden | Jede Zahl, URL und E-Mail-Adresse muss in einer Quelle vorkommen, die der Satz zitiert |
In der dritten Person schreiben | Die Prüfung des Gates auf die erste Person |
Keine Honorare, keine Verfügbarkeit | Die Muster aus Schicht 1, dann die Prüfungen des Gates auf Werte und erste Person |
Eine Anweisung hat kein vollwertiges Gegenstück: „Verwende nur, was die Quellen sagen“, für eine Aussage, in der keine Zahl vorkommt. Das Gate kann für diesen Satz einen gültigen Marker verlangen. Ob die Quelle das aussagt, kann es nicht entscheiden. Die Regeln zur Zeit haben ebenso wenig eines. Ein Satz, der zwei datierte Ereignisse in die falsche Reihenfolge bringt oder eine alte Rolle als aktuelle ausgibt, enthält keinen Wert, den das Gate prüfen könnte. Die Einträge verringern dieses Risiko, weil sie nach Datum geordnet und mit markierten aktuellen Einträgen ankommen; beseitigen können sie es nicht.
Schicht 4: den Stream Satz für Satz freigeben
Einen Satz, den der Leser schon gelesen hat, nimmt niemand zurück. Die Dokumentation von NVIDIAs NeMo Guardrails benennt den Zielkonflikt: Mit aktivem stream_first, dem Standard, gilt, „wenn eine Rail den Inhalt blockiert, hat der Nutzer die Tokens bereits erhalten“. Diese Website hat sich für die andere Seite entschieden. Text wird zurückgehalten, bis ein Satz endet, geprüft und erst dann freigegeben, zum Preis von etwa einem Satz Verzögerung.
Jeder Satz durchläuft vier Prüfungen, und jede ist eine Feststellung über Zeichenketten, kein Urteil über Bedeutung:
Marker im gültigen Bereich: Er verweist auf eine Quelle, die geliefert wurde.
Marker vorhanden bei jedem inhaltlichen Satz; ein kurzer Überleitungssatz ohne Werte kommt durch. Die Länge wird in Wörtern gezählt, die durch Leerzeichen getrennt sind, außer im Chinesischen, das keine verwendet: Dort zählen je drei Schriftzeichen als zwei Wörter.
Werte in den zitierten Belegen: Jede Zahl, URL und E-Mail-Adresse kommt in einer Quelle vor, die der Satz zitiert, wobei persische und arabische Ziffern auf lateinische normalisiert werden.
Keine erste Person, denn das hieße, dass der Assistent angefangen hat, als ich zu sprechen.
Bei einem Verstoß bleiben die freigegebenen Sätze stehen, der durchgefallene wird nie gesendet, und der Stream stoppt, was zugleich die Generierung upstream abbricht. Der Leser sieht einen festen Text, wonach sich der Rest der Antwort mit den Quellen dieser Website nicht belegen ließ und zurückgehalten wurde. Marker werden geprüft und dann entfernt, damit Leser Fließtext sehen und kein Quellenverzeichnis, und eine abgeschnittene Antwort bekommt einen eigenen Hinweis: Ein unterbrochener Satz ist kein unbelegter Satz.
Belegt heißt nicht wahr. Werte werden gegen die Quellen geprüft, die ein Satz zitiert, nicht gegen die Aussage: Ein Satz, der zwei Quellen zitiert, kann einen Wert aus jeder davon nehmen, und ein Satz ohne Werte kommt mit jedem Marker im gültigen Bereich durch. Das Gate kann nicht zeigen, dass eine Aussage richtig ist, und nicht einmal, dass die zitierte Passage sie hergibt. Der OWASP-Eintrag LLM09:2025 Misinformation fordert von Teams, „zentrale Ausgaben automatisch zu validieren“; dies ist eine enge, deterministische Fassung davon. Die Mechanik steht in LLM-Guardrails im Streaming.
Schicht 5: Regeln für Stimme und Vertretung
Ein Assistent, der für jemanden spricht, gibt Erklärungen ab
In Moffatt v. Air Canada (2024 BCCRT 149), berichtet von McCarthy Tétrault und Bristows, befasste sich das Civil Resolution Tribunal von British Columbia mit dem Chatbot einer Fluggesellschaft, der einem Kunden nahegelegt hatte, er könne einen Trauertarif nachträglich geltend machen. Die Position der Fluggesellschaft lief, wie das Tribunal es formulierte, darauf hinaus, „der Chatbot sei eine eigenständige juristische Person, die für ihr eigenes Handeln verantwortlich ist“. Das Tribunal sah das anders: „Es macht keinen Unterschied, ob die Information von einer statischen Seite oder von einem Chatbot stammt.“
Das ist technischer Kontext, keine Rechtsberatung, und die Entscheidung eines Tribunals ist keine allgemeine Regel. Die technische Lehre ist enger: Ein Assistent auf Ihrer Website spricht mit der Autorität Ihrer Website. Ein Honorar oder ein Starttermin, der klingt, als käme er von mir, wäre eine Erklärung, die ich nie abgegeben habe. Eine selbstsichere falsche Antwort ist schlimmer als keine Antwort; eine selbstsichere falsche Zusage ist noch schlimmer.
Dritte Person, feste Ablehnungstexte und eine Prüfung auf die erste Person
Der Assistent ist nie ich. Er schreibt über mich in der dritten Person, und jede Ablehnung und jeder Hinweis ist fester Text. Die Regel für die Stimme wird an drei Stellen durchgesetzt:
Schicht 1 lehnt Fragen nach Honoraren, Verfügbarkeit, Beauftragung und privaten Angaben vor dem Retrieval ab, in jeder Sprache der Website.
Schicht 3 verbietet die erste Person und jede Zusage in meinem Namen.
Schicht 4 stoppt den Stream, sobald ein Wort in der ersten Person auftaucht.
Im Persischen ist diese Prüfung schwächer. Die englische Liste der ersten Person deckt die Pronomen ab. Die persische Liste ist kuratiert, nicht vollständig: Das Persische markiert die Person in Verbendungen, und eine Regel, die weit genug gefasst wäre, um sie alle zu erfassen, würde auch gewöhnliche Wörter mit derselben Endung treffen. Die Liste enthält die Pronomen und einige besonders riskante Verben, etwa هستم und دارم, jeweils in beiden Formen, die die Normalisierung erzeugen kann: Die Prüfung normalisiert, bevor sie in Wörter trennt, sodass میکنم als zwei Tokens bei ihr ankommt und میکنم als eines. Ungedeckt bleibt die Endung, nicht die Schreibweise. Das Persische stützt sich stärker auf den Prompt, und das steht hier geschrieben, statt verschwiegen zu werden. Für die übrigen Sprachen der Website enthält die Liste die Personal- und Possessivpronomen der ersten Person, für Spanisch, Portugiesisch, Russisch, Arabisch und Hindi, die „ich“ meist allein mit dem Verb ausdrücken, außerdem einige Verben in der ersten Person. Im Chinesischen, das Wörter nicht durch Leerzeichen trennt, sucht die Prüfung überall im Satz nach 我, außer in einem Kompositum mit 自我, „selbst-“, wie 自我修正, „Selbstkorrektur“. Im Arabischen fehlt ein Wort der ersten Person mit Absicht, denn die Normalisierung der Buchstaben, die persische und arabische Schreibweisen vergleichbar macht, macht es mit einer häufigen Präposition identisch.
Kostenmissbrauch und Denial of Wallet: dieselbe Fehlerfamilie
Eine Halluzination ist Ausgabe, die niemand autorisiert hat. Eine unbegrenzte Rechnung sind Kosten, die niemand autorisiert hat. OWASP führt das Zweite unter LLM10:2025 Unbounded Consumption, das Denial of Wallet einschließt: Angreifer „nutzen das nutzungsabhängige Kostenmodell cloudbasierter KI-Dienste aus und bürden dem Anbieter untragbare finanzielle Lasten auf“. Zu den dort genannten Gegenmaßnahmen zählen Grenzen für die Eingabegröße, Rate-Limits und Nutzerkontingente, Timeouts und Drosselung sowie ein kontrolliertes Zurückfahren der Funktionalität.
Ein Budget vor dem Aufruf, keine Warnung danach
Eine Prüfung nach dem Modellaufruf hat das Geld schon ausgegeben. Auf dieser Website läuft eine monatliche Kostenprüfung nach der Schwelle und vor dem Modellaufruf. Sie addiert die bisherigen Kosten und eine obere Schranke für die Kosten dieser Anfrage: den gesamten Prompt, gezählt mit einem Token pro UTF-8-Byte, plus die volle Obergrenze für die Ausgabe, das Kontingent fürs Reasoning eingeschlossen. Stattdessen gegen die erwarteten Kosten zu prüfen, ist der Weg, auf dem eine Obergrenze überschritten wird.
Würde die Summe die Obergrenze überschreiten, wird kein Modell aufgerufen, und der Leser bekommt einen festen Hinweis, dass das Monatslimit erreicht ist, keine Fehlermeldung.
Die Byte-Zahl ist eine echte obere Schranke, keine großzügige Schätzung. Jedes Vokabular, auf das dieser Endpunkt gerichtet werden kann, ist ein Byte-Level-BPE, und in einem solchen ist ein Token eine nichtleere Folge von Bytes; kein Text kann also mehr Tokens ergeben, als er Bytes hat, in keiner Sprache. Der einzige Weg an dieser Schranke vorbei wäre ein Tokenizer, der den Text expandiert, bevor er ihn zerlegt, und das tut keiner von ihnen. Die Schranke hat eine pauschale Regel von zwei Zeichen pro Token abgelöst, die Regel, die diese Website ausgemustert hat: Die persische Token-Steuer hat gemessen, dass diese Regel auf cl100k_base bei jedem persischen Satz eines Parallelkorpus unter der tatsächlichen Zahl lag. Die Schranke ist nicht scharf – für Persisch reserviert sie ein Mehrfaches dessen, was der Prompt wirklich kostet – und sie ist in der einen Richtung unscharf, in der eine Kostenobergrenze falsch liegen darf.
Zwei Grenzen bleiben. Die Prüfung ist keine Reservierung: Die Kosten werden gelesen und verglichen, nicht gehalten, sodass gleichzeitig eintreffende Anfragen jede für sich bestehen und die Obergrenze gemeinsam überschreiten können; die Limits pro IP verkleinern dieses Fenster, ohne es zu schließen. Und der Zähler ist kein vollständiges Kontenbuch: Er hält die Kosten der Modellaufrufe dieses Endpunkts, das gehostete Embedding hinter jeder Frage liegt also außerhalb, und ein Schreibvorgang, der verloren geht, während der Zählerspeicher nicht erreichbar ist, wird nie nachgeholt. Die Obergrenze ist ein Guardrail, keine Rechnung.
Bei den Kosten fail closed, bei den Rate-Limits fail open
Ist der Zählerspeicher nicht erreichbar, sind die Kosten unbekannt, und unbekannte Kosten gegen eine harte Obergrenze haben nur eine sichere Lesart: ablehnen, als wäre die Obergrenze erreicht.
Der Rate-Limiter arbeitet stattdessen nach fail open, denn ein Cache-Ausfall soll nicht die Website lahmlegen. Der schlimmste Fall bei einem Rate-Limit, das offen ausfällt, sind ein paar zusätzliche Anfragen; bei einer Kostenobergrenze, die offen ausfällt, ist es eine unbegrenzte Rechnung. Es gibt drei Limits pro IP, die sich über eine Minute, eine Stunde und einen Tag wieder auffüllen, als Schlüssel dient dabei die Adresse, die der Edge-Proxy beobachtet hat, nicht ein Header, den der Client selbst schreiben kann. Sie bremsen Skripte; die monatliche Obergrenze ist die Rückfallebene für die Kosten, keine Garantie.
Aufhören zu zahlen, wenn der Leser geht
Ein geschlossener Browser-Tab stoppt die Modellanfrage beim Anbieter nicht. Der Server prüft innerhalb der Streaming-Schleife auf einen Verbindungsabbruch und schließt den Stream des Anbieters, was die Anfrage abbricht. Der Stopp des Gates tut dasselbe: Niemand soll für Sätze zahlen, die niemand sehen wird.
Was vor dem Abbruch generiert wurde, wurde generiert und steht auf der Rechnung, der Monat wird also dafür belastet. Beide Anbieterprotokolle melden den Verbrauch in einem abschließenden Event, das ein vorzeitig abgebrochener Stream nie erreicht; der Dienst behält deshalb jedes Zeichen, das er empfangen hat, und füllt nur die Lücken, die der Anbieter gelassen hat, mit einem Token pro UTF-8-Byte. Wo der Anbieter gemeldet hat, gelten seine Zahlen: Eine Anfrage, die bis zum Ende läuft, erfasst genau seine Angabe, keine Näherung davon.
So messen Sie das: Ablehnungsgenauigkeit, recall@k und Grounding
Drei Eigenschaften zählen. Die Ablehnungsgenauigkeit misst, ob der Assistent ablehnt, was er ablehnen muss. Das Maß recall@k misst, ob die Belege beim Modell ankommen. Das Grounding misst, ob die Antwort innerhalb dieser Belege bleibt. Auf dieser Website wird ein Golden Set aus Fragen in allen zehn Sprachen der Website, die meisten davon englisch und persisch, bei jedem CI-Lauf deterministisch bewertet, ohne Modellaufruf.
Ablehnungsgenauigkeit: zwei Mengen, keine Teilpunkte
Die Ablehnung wird an zwei Mengen gemessen, weil die beiden Ablehnungsschichten unterschiedlich versagen. Musterablehnungen muss Schicht 1 abfangen, bevor das Retrieval läuft; Fragen ohne Beleg, die mit der Website nichts zu tun haben, müssen unter der Schwelle bleiben und dürfen nicht als Fragen über mich erkannt werden. Eine dritte Menge prüft, dass Fragen zur Arbeit insgesamt die Einträge der Website erreichen.
Beide Mengen müssen perfekt abschneiden, damit der Build besteht. Eine verpasste Ablehnung ist eine erfundene Zusage auf der Website einer realen Person, und ein Durchschnitt würde sie verdecken. Derselbe Lauf prüft den umgekehrten Fehler: beantwortbare Fragen, die von den Mustern oder der Schwelle abgelehnt werden. Die Evals-FAQ von Hamel Husain und Shreya Shankar zieht Bestanden/Nicht bestanden den Bewertungsskalen vor, weil „binäre Evaluationen klareres Denken und eine konsistentere Vergabe von Labels erzwingen“.
Die Fragen, die abgelehnt werden müssen, zitiere ich hier nicht: Dieser Artikel wird in den Korpus des Assistenten aufgenommen, und sie zu zitieren gäbe genau diesen Fragen einen starken Stichworttreffer auf dieser Seite.
Recall@k unterhalb des voreingestellten k
Im Golden Set fragt recall@k, ob mindestens eine Passage, die die Frage beantwortet, unter den besten k ist; damit ist es eine Trefferquote. Anthropics Beitrag zu Contextual Retrieval verwendet den strengeren Anteil abgerufener relevanter Dokumente und berichtet „1 minus recall@20“ als Fehlermaß.
Das Golden Set misst den Recall bei k = 5, unterhalb des voreingestellten Top-k von 8, denn auf einem Testkorpus aus einigen Dutzend Chunks sind die besten acht ein großer Teil von allem, was es überhaupt gibt, und eine Messung dort würde dem Retriever schmeicheln.
Grounding: zur Laufzeit erzwungen, nicht offline bewertet
Offline wird Grounding meist als faithfulness bewertet. Ragas definiert diese Metrik als die Aussagen einer Antwort, die der abgerufene Kontext stützt, geteilt durch alle ihre Aussagen, von 0 bis 1; in der Standardform identifiziert und prüft ein LLM die Aussagen.
LLM-Judges sind nützlich und voreingenommen. Zheng und Kollegen fanden „Verzerrungen hinsichtlich Position, Ausführlichkeit und Selbstaufwertung“, während starke Judges trotzdem über 80 Prozent Übereinstimmung mit menschlichen Präferenzen erreichten. Husain und Shankar raten, die True-Positive- und True-Negative-Rate eines Judges an einem zurückgehaltenen, gelabelten Datensatz zu validieren und überall dort mit günstigen Prüfungen im Code zu beginnen, wo eine Regel entscheiden kann.
Diese Website geht den Weg über den Code: Das Gate erzwingt das Grounding zur Laufzeit, und in der CI läuft weder eine faithfulness-Metrik noch ein LLM-Judge.
Was mein Golden Set nicht beweist
Der Embedder ist ein Ersatz. Das Retrieval in der CI nutzt ein Bag-of-Tokens-Hashing-Modell ohne gelernte Bedeutung. Routing, Fusion, Ranking, Top-k-Auswahl und die Entscheidung über die Belege, samt Vergleich mit der Schwelle, sind der Produktionscode; im Test nachgebildet ist nur die Bewertung der Kandidaten, die in Produktion in der Datenbank läuft. Die CI erkennt also Regressionen in der Routing- und Ranking-Mechanik, nicht in der Datenbankabfrage und nicht im Recall des laufenden Assistenten, und der Ersatz durchläuft sogar eine Sparse-Liste, die in Produktion nicht verwendet wird.
Die Mengen sind klein. Es gibt einundzwanzig Musterablehnungen und elf Fragen ohne Beleg. „Muss perfekt sein“ bei elf Fragen ist ein Regressionsschutz, keine Ablehnungsquote.
Die Prüfungen am laufenden System sind Befehle, keine CI-Jobs. Der Test, der das Golden Set an den ausgerollten Retriever schicken würde, wird weiterhin übersprungen. Ein Befehl, der nur das Retrieval ausführt, schickt die Fragen des Golden Sets und die vorgeschlagenen Fragen durch den ausgerollten Embedder, ohne das Modell aufzurufen, und ein Skript, das nach jedem Import von Hand gestartet wird, stellt dem laufenden Assistenten die Fragen, die abgelehnt werden müssen.
Antworten aus Einträgen prüft nur das Gate. Die CI prüft gegen eine Fixture, welche Fragen die Einträge der Website erreichen und welche Einträge sie bekommen, mit einem geskripteten Ersatz für das Modell. Wie ein echtes Modell daraus eine Antwort formuliert, wird zur Laufzeit geprüft, durch das Gate.
Deshalb veröffentliche ich für diesen Assistenten keine Zahl zu Genauigkeit, Ablehnung oder Recall: Der automatisierte Lauf verwendet einen Ersatz-Embedder, die Prüfungen am laufenden System sind klein und werden von Hand gestartet, und diese Website schätzt keine Zahlen, die sie nicht gemessen hat.
Struktur statt Vertrauen in einem Vertragsassistenten
Ich habe als AI Engineer an Kartez Contract gearbeitet, einem dreisprachigen Arbeitsbereich für Verträge, den der Auftraggeber einen Monat vor der Fertigstellung aus kriegsbedingten Finanzierungsgründen gestoppt hat. Dort wurde die Bindung des Modells an den Text durch Struktur erreicht, nicht durch Vertrauen: Antworten stützen sich nur auf die ausgewählten Klauseln, Korrekturen müssen den bestehenden Wortlaut wörtlich zitieren, Ausgaben folgen festen Schemata, und beim Entwerfen läuft das Modell mit geringer Zufälligkeit. Das sind Designvorgaben, keine gemessene Garantie. Die Schwelle und das Gate weiter oben gehören zum Assistenten dieser Website, nicht zu Kartez. Die Fallstudie zu Kartez Contract beschreibt das Projekt. Wie diese Muster in Vertrags-KI aussehen und warum der Evaluationsdatensatz zuerst entsteht, steht in Was man gegen Halluzinationen juristischer KI bauen sollte.
Checkliste: Guardrails für einen RAG-Assistenten in Produktion
Zuerst per Muster ablehnen. Honorare, Verfügbarkeit, private Daten und das Auslesen von Anweisungen vor dem Retrieval abweisen.
Eine Ähnlichkeit als Schwelle nehmen, keinen Rang-Score. Kosinus kann eine Schwelle tragen, Ganzwort-Abdeckung ebenfalls, sobald häufige Wörter entfernt sind und mindestens zwei Inhaltswörter treffen; ein RRF-Score nicht. Unterhalb der Schwelle mit festem Text ablehnen und das Modell überspringen.
Überblicksfragen aus Einträgen beantworten, nicht über Ähnlichkeit. Eine nach Datum sortierte Liste hat keinen nächsten Nachbarn.
Die Schwelle auf dem Embedder kalibrieren, den Sie ausrollen. Eine an einem Ersatz geprüfte Schwelle ist ein Standardwert.
Jede Regel des Prompts mit einer Prüfung außerhalb des Modells spiegeln.
Den Stream satzweise freigeben. Einen Marker verlangen, Zahlen, URLs und E-Mail-Adressen wörtlich prüfen, ab dem durchgefallenen Satz alles zurückhalten und dem Abschneiden einen eigenen Hinweis geben.
Die erste Person verbieten in Assistenten, die über eine Person oder ein Unternehmen sprechen, und dokumentieren, wo die Prüfung schwächer ist.
Vor dem Aufruf eine obere Schranke reservieren, keine großzügige Schätzung. Bei einem Byte-Level-BPE ist die Zahl der UTF-8-Bytes des Prompts eine solche Schranke. Die Reservierung atomar machen, damit nicht alle gleichzeitigen Anfragen bestehen, im Fehlerfall geschlossen ausfallen und bei einem Verbindungsabbruch die Arbeit upstream abbrechen.
Für jeden Aufruf Kosten erfassen, auch für abgebrochene: den Text so behalten, wie er streamt, und nur füllen, was das abschließende Usage-Event des Anbieters nie gemeldet hat.
Ablehnung getrennt vom Recall messen. Den Embedder, die Größe der Mengen und das, was der Lauf nicht beweist, dazuschreiben.
Häufige Fragen
Beseitigt RAG Halluzinationen?
Nein. Bei den auf RAG gestützten Werkzeugen für die juristische Recherche von LexisNexis und Thomson Reuters lag der Anteil halluzinierter Antworten in einer präregistrierten Studie weiterhin zwischen 17 Prozent und 33 Prozent, und unzureichender Kontext kann ein Modell selbstsicherer machen statt vorsichtiger. Retrieval verbessert die Chancen; Garantien kommen von Prüfungen außerhalb des Modells.
Welche Ähnlichkeitsschwelle sollte ein RAG-System verwenden?
Eine übertragbare Zahl gibt es nicht, denn die Verteilungen der Ähnlichkeit hängen vom Embedding-Modell und vom Korpus ab. Setzen Sie die Schwelle auf eine beschränkte Ähnlichkeit wie den Kosinus, nie auf einen Reciprocal-Rank-Fusion-Score, und bestimmen Sie den Wert anhand beantwortbarer und abzulehnender Fragen auf dem Embedder, den Sie ausrollen. Eine nur an einem Ersatz geprüfte Schwelle ist ein Standardwert, keine Kalibrierung.
Reicht ein System-Prompt, um Halluzinationen zu stoppen?
Nein. OWASP empfiehlt, „nach Möglichkeit keine System-Prompts zu verwenden, um das Verhalten des Modells zu steuern“, und stattdessen „auf Systeme außerhalb des LLM“ zu setzen, und die Anleitung von Anthropic sagt, Prompt-Techniken verringerten Halluzinationen, ohne sie zu beseitigen. Behalten Sie den Prompt und geben Sie jeder Anweisung, auf die es ankommt, eine deterministische Prüfung außerhalb des Modells.
Kann ein LLM-Judge deterministische Prüfungen ersetzen?
Nicht bei Regeln, über die eine Prüfung auf Zeichenketten entscheiden kann, etwa ob ein Marker auf eine echte Quelle zeigt oder eine Zahl in den Belegen vorkommt. Judges zeigen Verzerrungen hinsichtlich Position, Ausführlichkeit und Selbstaufwertung. Setzen Sie sie für Fragen ein, die Code nicht beantworten kann, mit binären Labels und einem gegen menschliche Labels validierten Judge.
Wie verhindert man, dass ein LLM-Chatbot hohe Kosten verursacht?
Reservieren Sie vor dem Modellaufruf atomar eine obere Schranke für dessen Kosten – bei einem Byte-Level-BPE-Tokenizer ist die Zahl der UTF-8-Bytes des Prompts eine solche, in jeder Sprache – und lehnen Sie ab, wenn der Zähler nicht verfügbar ist. Erfassen Sie für jeden Aufruf Kosten, auch für abgebrochene, indem Sie den gestreamten Text behalten und füllen, was das abschließende Usage-Event des Anbieters nie gemeldet hat. Schalten Sie auf festen Text um, statt einen Fehler zu werfen, und brechen Sie die Generierung upstream ab, wenn der Client die Verbindung trennt. OWASP führt dieses Risiko als LLM10:2025 Unbounded Consumption, das Denial of Wallet einschließt.
Quellen
Wenn Sie einen Assistenten entwerfen, der so verlässlich ablehnen muss, wie er antwortet, beginnen Sie mit der Projektanalyse.