
Die persische Token-Steuer: was nicht-englische LLM-Apps kosten
Persisch brauchte auf dem Tokenizer von GPT-4o 1,53× und auf dem von GPT-4 3,26× so viele Tokens wie Englisch, über 1.012 parallele Sätze. Methode, Ergebnisse.
Persischer (Farsi) Text kostet für denselben Inhalt mehr Tokens als englischer. Dieser Aufschlag ist die persische Token-Steuer, und wie hoch sie ausfällt, hängt stärker vom Tokenizer ab als von der Schrift. Ich habe die Tokens für dieselben 1.012 Sätze aus dem Benchmark FLORES-200 auf Englisch und Persisch gezählt. Persisch brauchte 1,53× so viele Tokens wie Englisch auf o200k_base, dem Encoding, das die tiktoken-Bibliothek von OpenAI GPT-4o zuordnet, und 3,26× auf cl100k_base, das sie GPT-4 zuordnet. Diese beiden Werte waren die Extreme unter den vier Tokenizern, die Textgenerierungsmodelle verwenden; bge-m3, der Tokenizer eines Embedding-Modells, kam auf 1,10×. Claude und Gemini fehlen in dieser Messung: Anthropic veröffentlicht den Tokenizer von Claude nicht, und den lokalen Tokenizer, den das SDK von Google für Gemini anbietet, habe ich nicht getestet. Beide Anbieter zählen die Tokens ihrer eigenen Modelle über eine API.
Diese Zahlen sind eine Momentaufnahme mit Datum: gemessen am 17. September 2026, mit gepinnten Tokenizer-Versionen.
Warum Persisch (Farsi) mehr Tokens braucht: Bytes, Merges und Trainingsdaten
APIs von Sprachmodellen rechnen pro Token ab. Ahia und Kollegen fanden 2023 Belege dafür, dass „Sprecher einer großen Zahl der unterstützten Sprachen zu viel bezahlen und dabei schlechtere Ergebnisse erhalten“. Petrov und Kollegen zeigten, dass derselbe Text, in verschiedene Sprachen übersetzt, in der Tokenlänge abweichen kann, „in einigen Fällen um das bis zu 15-Fache“. Eine Studie von 2025 über mehr als zweihundert Sprachen berichtet für Sprachen mit nicht-lateinischer Schrift und komplexer Morphologie von „oft 3- bis 5-mal höheren RTC-Werten“; RTC steht dabei für die „Relative Tokenization Cost“ der Autoren.
Das ist die Token-Steuer: dieselbe Bedeutung, eine größere Rechnung.
Bytes sind der Ausgangspunkt jedes Byte-Level-Tokenizers
Ein Byte-Level-BPE-Tokenizer (BPE steht für byte-pair encoding), die Bauart hinter GPT-4o, Qwen3 und DeepSeek-V3, beginnt bei den Bytes des Textes in UTF-8 und fasst häufige Byte-Folgen zu Tokens zusammen. Ein lateinischer Buchstabe ohne Akzent ist ein Byte; die Buchstaben des Yoruba mit Tonzeichen und Unterpunkt brauchen zwei oder mehr. Ein persischer Buchstabe braucht zwei, der Zero Width Non-Joiner innerhalb persischer Wörter drei. In FLORES belegte die persische Datei in UTF-8 1,69× so viele Bytes wie die englische, bei 0,94× so vielen Zeichen. Persisch ist nicht länger in Zeichen. Es ist schwerer zu kodieren.
Was danach passiert, hängt von den Merges ab, die ein Tokenizer aus seinen Trainingsdaten gelernt hat. Der Wechsel von cl100k_base zu o200k_base senkte die persischen Tokens um 53,5 % und die englischen um 1,1 %. Das neuere Vokabular veränderte Persisch, nicht Englisch.
Yoruba schreibt lateinisch und zahlt trotzdem mehr
Wenn die Schrift die Steuer bestimmte, zahlten Sprachen in lateinischer Schrift kaum etwas. Ein Workshop-Papier von Roy, Roy und Patel (angenommen für einen Workshop der IJCAI 2026, seit August 2026 auf arXiv) stellte in seinem Audit fest, dass „Yoruba trotz lateinischer Schrift den höchsten GPT-4o-Tokenisierungsaufschlag aufweist“, nämlich 2,37×. Die Autoren verweisen auf Diakritika und die Abdeckung im Vokabular. In diesem Papier ist Yoruba ein explorativer Vergleich: Seine Übersetzungen wurden maschinell erzeugt und manuell geprüft, während Bengalisch und Hindi die validierten Fälle sind.
Meine Messung zeigt in dieselbe Richtung. Yoruba kostete auf vier der fünf Tokenizer mehr als Persisch, und Arabisch kostete auf vier der fünf weniger als Persisch. Die Ausnahme bei Arabisch ist bge-m3, ein Embedding-Modell, das auf XLM-RoBERTa und dessen Vokabular aufsetzt. XLM-R wurde auf hundert Sprachen aus CC-100 trainiert: 13.259 Mio. Tokens Persisch gegenüber 2.869 Mio. Arabisch, und Yoruba war nicht darunter. Das passt dazu, dass der Anteil an den Trainingsdaten schwerer wiegt als die Schrift. Ein Beweis ist es nicht.
Ergebnisse: Persisch, Arabisch und Yoruba gegen Englisch
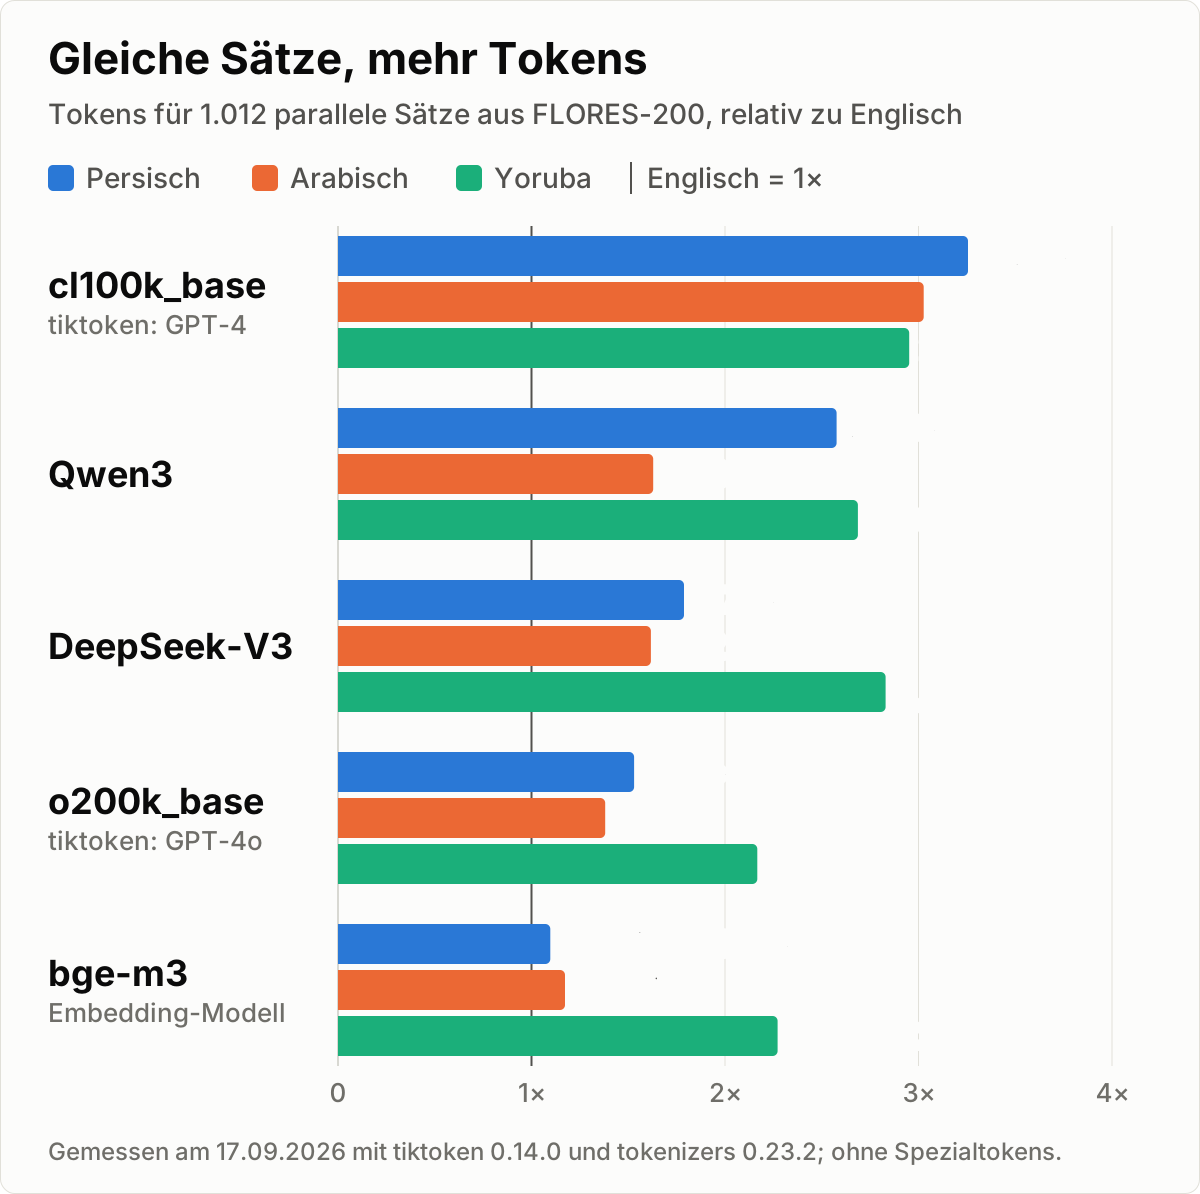
Jede Zelle ist die Gesamtzahl der Tokens einer Sprache, geteilt durch die englische Gesamtzahl auf demselben Tokenizer:
Tokenizer | Persisch (× Englisch) | Arabisch (× Englisch) | Yoruba (× Englisch) |
|---|---|---|---|
| 3,26× | 3,03× | 2,95× |
Qwen3 | 2,58× | 1,63× | 2,69× |
DeepSeek-V3 | 1,79× | 1,62× | 2,83× |
| 1,53× | 1,38× | 2,17× |
bge-m3 | 1,10× | 1,17× | 2,27× |
Der Tokenizer ist die größte Variable. Das persische Verhältnis auf dem schlechtesten Tokenizer (3,26×) ist rund dreimal so hoch wie auf dem besten (1,10×) und selbst unter den vier Tokenizern für die Textgenerierung noch rund doppelt so hoch (3,26× gegenüber 1,53×). Qwen3 behandelt Arabisch weit besser als Persisch, 1,63× gegenüber 2,58×; eine einzige Zahl für die arabische Schrift deckt also nicht beide Sprachen ab. Das Ergebnis für cl100k_base deckt sich mit früher veröffentlichten Zählungen: In den von Petrov und Kollegen veröffentlichten Tokenlängen für FLORES-200, die die Splits dev und devtest zusammenfassen, liegt Westpersisch bei 3,28× Englisch, gegenüber meinen 3,26× allein auf dem Split devtest.
Die Summen hinter diesen Verhältnissen, samt der Größe jeder Sprachdatei, bevor ein Tokenizer sie angefasst hat:
Zählung | Englisch | Persisch | Arabisch | Yoruba |
|---|---|---|---|---|
Zeichen | 131.966 | 123.830 | 116.320 | 126.848 |
Bytes (UTF-8) | 132.096 | 223.504 | 211.276 | 168.857 |
Tokens, | 27.182 | 88.513 | 82.288 | 80.247 |
Tokens, Qwen3 | 27.621 | 71.183 | 44.991 | 74.226 |
Tokens, DeepSeek-V3 | 27.041 | 48.342 | 43.713 | 76.526 |
Tokens, | 26.873 | 41.116 | 37.117 | 58.238 |
Tokens, bge-m3 | 30.661 | 33.631 | 35.979 | 69.672 |
Ihr eigener Korpus liefert eine andere Zahl
Das Audit von Roy und Kollegen hat o200k_base an 120 Python-Debugging-Aufgaben gemessen, die aus dem Englischen übersetzt wurden, und pro Aufgabe gemittelt. Es nennt für Arabisch 1,44× und für Yoruba 2,37×, beides aus maschinellen Übersetzungen. Auf der von Menschen übersetzten Prosa in FLORES ergab derselbe o200k_base für Arabisch 1,38× und für Yoruba 2,17×. Gleicher Tokenizer, anderer Text und anderes Übersetzungsverfahren, anderes Ergebnis. Zählen Sie Ihre eigenen Prompts, abgerufenen Passagen und Antworten, bevor Sie budgetieren.
So habe ich die persischen Tokenzahlen gemessen
Ein wirklich paralleler Korpus
Das NLLB-Team beschreibt FLORES-200 als „von Menschen übersetzten Benchmark“: dieselben Sätze, in derselben Reihenfolge, in jeder Sprache. Ich habe den Split devtest verwendet, lizenziert unter CC BY-SA 4.0, aus dem offiziellen Archiv und mit geprüftem SHA-256-Hash: 1.012 Sätze aus Wikinews, Wikivoyage und Wikibooks, auf Englisch, Westpersisch, Hocharabisch und Yoruba.
Parallelität zählt mehr als Umfang. Eine frei angepasste Übersetzung, etwa ein zweisprachiger Lebenslauf, ergänzt, streicht und formuliert um; ihr Verhältnis misst dann die Redaktion ebenso sehr wie den Tokenizer. FLORES hat seine eigene Grenze: Es ist Prosa aus Nachrichten, Reiseführern und Lehrbüchern, nicht Chat, Code oder Verträge.
Offene Tokenizer, gepinnte Revisionen, und warum Claude und Gemini fehlen
Fünf Tokenizer, alle ohne Benutzerkonto herunterladbar:
tiktoken 0.14.0:
cl100k_baseundo200k_base. tiktoken ordnet GPT-4 und GPT-3.5 Turbo dem ersten zu, GPT-4o, o1, o3, GPT-4.1 und GPT-5 dem zweiten.Qwen3 (
Qwen/Qwen3-8B) und DeepSeek-V3 (deepseek-ai/DeepSeek-V3), beide Byte-Level-BPE, geladen mit tokenizers 0.23.2 von Hugging Face auf gepinnten Hub-Revisionen.bge-m3 (
BAAI/bge-m3), ein Embedding-Modell, dessen Tokenizer ein SentencePiece-Unigram-Modell mit dem Vokabular von XLM-R ist, kein Byte-Level-BPE. Unigram ist ein anderer Algorithmus: Er wählt aus einem festen Vokabular die wahrscheinlichste Zerlegung des Textes. Er ist für das Retrieval relevant, nicht für die Generierung.
Jeder Satz wurde einzeln kodiert, ohne Spezialtokens, und die Zahlen wurden summiert. Die Mediane pro Satz ergeben dasselbe Bild wie die Summen. Der Kern passt in wenige Zeilen:
# after: tar -xzf flores200_dataset.tar.gz
import tiktoken
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer


def sentences(lang):
    with open(f"flores200_dataset/devtest/{lang}.devtest", encoding="utf-8") as f:
        return f.read().rstrip("\n").split("\n")


english, persian = sentences("eng_Latn"), sentences("pes_Arab")

o200k = tiktoken.get_encoding("o200k_base")
qwen3 = Tokenizer.from_file(
    hf_hub_download(
        "Qwen/Qwen3-8B",
        "tokenizer.json",
        revision="b968826d9c46dd6066d109eabc6255188de91218",
    )
)


def o200k_tokens(texts):
    return sum(len(o200k.encode_ordinary(t)) for t in texts)


def qwen3_tokens(texts):
    return sum(len(qwen3.encode(t, add_special_tokens=False).ids) for t in texts)


print(round(o200k_tokens(persian) / o200k_tokens(english), 2))
print(round(qwen3_tokens(persian) / qwen3_tokens(english), 2))
Das Messprotokoll, ausreichend, um den Lauf exakt zu wiederholen:
corpus: https://dl.fbaipublicfiles.com/nllb/flores200_dataset.tar.gz
sha256: b8b0b76783024b85797e5cc75064eb83fc5288b41e9654dabc7be6ae944011f6
split: devtest
measured: 2026-09-17
libraries:
  tiktoken: 0.14.0
  tokenizers: 0.23.2
  huggingface_hub: 1.31.0
encodings: [cl100k_base, o200k_base]
hub_revisions:
  Qwen/Qwen3-8B: b968826d9c46dd6066d109eabc6255188de91218
  deepseek-ai/DeepSeek-V3: e815299b0bcbac849fa540c768ef21845365c9eb
  BAAI/bge-m3: 5617a9f61b028005a4858fdac845db406aefb181
method: each sentence encoded on its own, no special tokens, counts summed per language
Claude und Gemini fehlen mit Absicht. Anthropic veröffentlicht den Tokenizer von Claude nicht; jedes Verhältnis, das ich für Claude angäbe, wäre eine Schätzung mit Nachkommastelle. Das Gen-AI-SDK von Google für Python enthält einen experimentellen, rein textbasierten lokalen Tokenizer, der einige Gemini-Modelle auf offene Gemma-Tokenizer abbildet; gemessen habe ich ihn nicht. Beide Anbieter zählen die Tokens für Sie. Der Endpunkt count_tokens von Anthropic ist kostenlos, unterliegt aber einem Rate-Limit, und die Dokumentation nennt das Ergebnis „eine Schätzung“; count_tokens bei Gemini zählt die Eingabe. Claude 4.7 und spätere Modelle verwenden einen neueren Tokenizer, auf dem derselbe Eingabetext „ungefähr 30 Prozent mehr Tokens als bei früheren Modellen“ ergibt. Eine Tokenzahl gehört zu einem Modell, nicht zu einem Anbieter.
Schranken, die halten, und eine, die nicht hält
Bei Byte-Level-BPE-Tokenizern, die den Text vor dem Zusammenfassen in Pre-Tokens zerlegen, so wie alle vier hier, rahmen zwei Grenzen die Zahl ein. Es können nicht mehr Tokens sein als Bytes des Textes in UTF-8, so wie der Tokenizer ihn normalisiert, denn jedes Token deckt mindestens ein Byte ab. Und es können nicht weniger sein als die Pre-Tokens dieses Tokenizers, also die Stücke, in die sein Trennmuster den Text schneidet, denn Merges überschreiten nie eine Pre-Token-Grenze. Ich habe beide Schranken Satz für Satz auf den vier Byte-Level-BPE-Tokenizern und allen vier Sprachen geprüft: 16.192 Prüfungen, 0 Verstöße.
Die Tokenizer-Spielwiese auf dieser Website zeigt beide Zahlen für jeden Text, den Sie eingeben, berechnet im Browser: die Pre-Token-Zerlegung von cl100k_base und die Bytes des Textes in UTF-8. Für cl100k_base liegt die echte Zahl dazwischen, und genau das sagt auch die Bildunterschrift unter jedem Feld.
Die untere Schranke gehört zu genau einem Tokenizer. Die Zerlegung von cl100k_base ist keine Untergrenze für o200k_base: Bei 28 englischen Sätzen brauchte o200k_base weniger Tokens, als cl100k_base Pre-Tokens erzeugt. Für das Unigram-Modell von bge-m3 gilt keine der beiden Schranken.
Wie sich die Token-Steuer auf Preis, Latenz, Kontextfenster und Rate-Limits auswirkt
Preis
API-Anbieter berechnen die Tokens, die ein Modell verarbeitet und erzeugt. Bei gleichem Preis pro Token kostet derselbe Inhalt auf Persisch mit o200k_base rund die Hälfte mehr als auf Englisch und mit cl100k_base mehr als das Dreifache. Sind Prompt und Antwort beide auf Persisch, trifft der Aufschlag beide Seiten der Rechnung.
Latenz
Das Tempo bestimmen die Ausgabe-Tokens. Der Latenz-Leitfaden von OpenAI sagt: „Wenn Sie 50 % Ihrer Ausgabe-Tokens kürzen, kann das ~50 % Ihrer Latenz einsparen.“ Den Prompt zu kürzen wiegt weit weniger: „Wenn Sie 50 % Ihres Prompts kürzen, verbessert das die Latenz unter Umständen nur um 1–5 %.“ Eine persische Antwort, die mehr Tokens braucht als ihr englisches Gegenstück, streamt länger. Das ist eine Anbieterleitlinie, angewandt auf die Verhältnisse oben, und keine Latenzmessung von mir.
Kontextfenster
Ein festes Tokenfenster fasst weniger Persisch. Teilt man durch das Verhältnis, fasst dasselbe Fenster für diesen Korpus mit cl100k_base nur 31 % so viel persischen Inhalt wie englischen, mit Qwen3 39 %, mit DeepSeek-V3 56 %, mit o200k_base 65 % und mit bge-m3 91 %. Das Audit von Roy und Kollegen zeigt dasselbe für Bengalisch: Dessen Aufschlag von 1,56× auf GPT-4o reduziert „ein nominelles Kontextfenster von 128k Tokens auf eine effektive englisch-äquivalente Kapazität von 82k Tokens“. In einem RAG-Prompt heißt das: Platz für weniger abgerufene Passagen.
Rate-Limits
Auch Rate-Limits werden in Tokens gezählt. Die API-Limits von Claude werden „in Anfragen pro Minute (RPM), Eingabe-Tokens pro Minute (ITPM) und Ausgabe-Tokens pro Minute (OTPM)“ gemessen. Unter einer Obergrenze für Tokens pro Minute erreicht eine Last, die pro Anfrage mehr Tokens braucht – wie Persisch auf jedem hier gemessenen Tokenizer –, das Limit nach weniger Anfragen. Bei den meisten Claude-Modellen werden Cache-Lesezugriffe nicht auf das Eingabelimit angerechnet.
Normalisierung, die Tokens spart, und Normalisierung, die den Recall zerstört
Zwei Eigenheiten der persischen Schriftsprache sehen nach billiger Tokenersparnis aus. Beide sind Fallen.
ZWNJ (نیمفاصله) ist ein Zeichen, kein Leerzeichen
U+200C ZERO WIDTH NON-JOINER hat in Unicode die allgemeine Kategorie Cf, ist also ein Formatierungssteuerzeichen und kein Leerraum. Es verhindert, dass die benachbarten Buchstaben miteinander verbunden werden, sodass میشود als ein Wort mit sichtbarer Lücke gelesen wird. Die persische Datei in FLORES verwendet es 1.739-mal, in 735 ihrer 1.012 Sätze.
Jedes ZWNJ durch ein Leerzeichen zu ersetzen, senkte die persischen Tokenzahlen um 1,59 % auf cl100k_base, um 1,82 % auf o200k_base, um 1,57 % auf Qwen3 und um 8,08 % auf DeepSeek-V3; auf bge-m3 änderte sich mit 0,00 % nichts. bge-m3 bewegte sich nicht, weil sein Normalisierer ZWNJ ohnehin auf ein Leerzeichen abbildet: Alle 735 geänderten Sätze behielten identische Token-IDs.
Auf drei Tokenizern ist die Ersparnis klein, auf DeepSeek-V3 größer, und sie verändert den Text: Aus einem Wort werden zwei, und was Sie speichern, anzeigen oder zitieren, ist nicht mehr das, was der Verfasser geschrieben hat. Behalten Sie ZWNJ im gespeicherten Text und entscheiden Sie getrennt davon, was ein Matcher als gleich behandelt. Genau das tut diese Website: Nur die Normalisierung innerhalb von Vergleichen behandelt ZWNJ wie ein Leerzeichen.
Arabisches Yeh und Kaf gegen persisches Yeh und Keheh
ARABIC LETTER YEH (U+064A) und ARABIC LETTER FARSI YEH (U+06CC) sind verschiedene Zeichen, ebenso ARABIC LETTER KAF (U+0643) und ARABIC LETTER KEHEH (U+06A9). Am Wortanfang und in der Wortmitte sehen sie gleich aus, am Wortende unterscheiden sie sich. Ein Stringvergleich sieht immer zwei verschiedene Zeichen. Selbst FLORES mischt sie: Die persische Datei enthält 11 arabische Yeh und 22 arabische Kaf neben 9.570 Farsi-Yeh und 2.957 Keheh.
Jedes Farsi-Yeh und Keheh in der persischen Datei als arabisches Yeh und Kaf zu schreiben, erhöhte die Tokenzahl um 2,20 % auf cl100k_base, um 9,49 % auf o200k_base, um 10,39 % auf DeepSeek-V3 und um 11,95 % auf bge-m3; nur auf Qwen3 sank sie, um 7,48 %. Eine Umschreibung, die auf einem Tokenizer Tokens spart, kostet auf den vier anderen Tokens.
Das eigentliche Problem ist der Recall. Wenn gespeicherter Text und Suchanfragen verschiedene Codepoints verwenden, scheitern exaktes und lexikalisches Matching lautlos. Diese Website normalisiert persischen Text beim Schreiben: Arabisches Yeh und Kaf werden zu ihren persischen Formen, ZWNJ bleibt. Die Suchanfrage wird genauso normalisiert. Ohne das sucht eine mit arabischem Yeh getippte Anfrage nach einem Zeichen, das der Index nicht enthält, und liefert nichts.
Die allgemeine Regel ist enger: Normalisieren Sie nur persischen Text, denn im Arabischen sind arabisches Yeh und Kaf die richtigen Buchstaben. Der Retriever dieser Website macht diesen Unterschied noch nicht; er wendet die persische Normalisierung auf Inhalte und Fragen in jeder Sprache an, Arabisch eingeschlossen. Der Artikel über hybride Suche für persisches RAG erklärt diese Lücke und deckt den Rest der Retrieval-Seite ab.
Persische Ziffern
ASCII-Ziffern als persische Ziffern zu schreiben, erhöhte die Tokenzahl um 0,48 % bis 1,47 %. Das ist kein Grund, die Darstellung für Leser zu ändern.
So senken Sie persische Tokenkosten: testen statt annehmen
Testen Sie jeden dieser Punkte auf Ihrem eigenen Traffic, bevor Sie sich darauf verlassen.
Wählen Sie das Modell mit Ihrem eigenen Text. Auf identischen Sätzen reichte das Verhältnis von Persisch zu Englisch von 1,10× bis 3,26×.
Zählen Sie mit dem Endpunkt des Anbieters. Über Claude und Gemini sagen die hier gemessenen Verhältnisse nichts aus.
Zählen Sie neu, wenn sich das Modell ändert. Ein neuerer Tokenizer kann jedes Budget verschieben, das Sie gesetzt haben.
Bemessen Sie Chunks und Kontextbudgets in Tokens, je Sprache. Ein auf Englisch abgestimmtes Zeichenlimit fasst auf Persisch mehr Tokens: von rund einem Sechstel mehr auf bge-m3 bis zu etwa dreieinhalbmal so vielen auf
cl100k_base.Begrenzen Sie die Ausgabelänge. Ausgabe-Tokens treiben Latenz und Kosten. Anthropic empfiehlt, eine Anzahl von Sätzen oder Absätzen zu verlangen statt einer Wortzahl.
Cachen Sie wiederkehrenden Kontext und messen Sie dann die Trefferrate. Jede Ersparnis hängt davon ab, wie oft sich Ihr Präfix tatsächlich wiederholt.
Behandeln Sie einen englischen System-Prompt als Hypothese. Er braucht weniger Tokens, aber ich habe keine Messung dazu, was er mit persischen Antworten macht.
Entfernen Sie kein ZWNJ und tauschen Sie keine Buchstabenformen, um Tokens zu sparen. Die Ersparnis ist klein oder unbeständig; der Schaden an Text und Matching ist es nicht.
So budgetieren Sie persische Tokens
Eine Zeichen-pro-Token-Regel ist eine Schätzung je Tokenizer
Persisch reichte von 1,40 Zeichen pro Token auf cl100k_base bis 3,68 auf bge-m3, mit o200k_base bei 3,01. Englisch reichte von 4,30 bis 4,91. Die Gemini-Dokumentation von Google sagt, „ein Token entspricht ungefähr 4 Zeichen“, und stellt das neben eine Zahl englischer Wörter: eine am Englischen ausgerichtete Regel, keine Aussage über Persisch.
Ein Token je zwei persische Zeichen zu reservieren, klingt großzügig. Diese Website hat genau das getan, und deshalb habe ich es an diesen Sätzen geprüft: Auf cl100k_base lag die Reservierung bei allen 1.012 persischen Sätzen unter der echten Zahl, auf Qwen3 bei 976. Auf o200k_base und bge-m3 hielt sie, auf DeepSeek-V3 reichte sie bei 6 Sätzen nicht. Eine Regel, die auf einem Tokenizer sicher ist, kann auf dem nächsten optimistisch sein; deshalb arbeitet diese Website nicht mehr mit einer solchen Regel.
Eine harte Obergrenze: die Byte-Zahl
Für Byte-Level-BPE ist die Byte-Zahl des Textes, so wie der Tokenizer ihn normalisiert, eine harte Obergrenze, aber eine lockere. Auf einer Skala von 0 bei der Pre-Token-Zahl bis 1 bei der Byte-Zahl lag Englisch zwischen 0,015 und 0,017: Fast jedes englische Pre-Token, grob ein Wort, ist ein einziges Token. Persisch lag bei 0,07 auf o200k_base und bei 0,31 auf cl100k_base, also in Stücke zerlegt, aber längst nicht in Bytes. Eine Reservierung auf Byte-Basis reserviert deshalb deutlich zu viel. Für eine Grenze, die niemand überschreiten darf, ist das der richtige Tausch, für eine Prognose der falsche. Für Claude und Gemini zählen Sie vor dem Aufruf mit deren Endpunkten und erfassen danach den Verbrauch, den sie melden.
Vor dem Aufruf reservieren, danach erfassen
Der Assistent auf dieser Website trennt diese beiden Aufgaben. Bevor das Sprachmodell aufgerufen wird, addiert er eine Schätzung für die Anfrage, nämlich eine obere Schranke für die Tokens des Prompts plus die volle Obergrenze der Ausgabe, zu den erfassten Ausgaben des Monats und vergleicht die Summe mit einem Monatslimit. Lässt sich der Ausgabenzähler nicht lesen, bricht er sicher ab (fail closed). Am Limit wird das Modell nicht aufgerufen, und der Leser bekommt einen Hinweis statt eines Fehlers. Nach dem Aufruf erfasst er den Verbrauch, den der Anbieter meldet. Die Schätzung entscheidet nur, ob eine Anfrage starten darf; die laufende Summe stammt aus den Tokenzahlen des Anbieters.
Beide Hälften haben Grenzen, in entgegengesetzte Richtungen. Die Schätzung vor dem Aufruf zählt den Prompt als seine Länge in Bytes (UTF-8), also die Obergrenze aus dem Abschnitt oben, keine Prognose. Jedes Vokabular, auf das der Assistent gerichtet werden kann, ist ein Byte-Level-BPE, also gilt diese Obergrenze für jedes Modell, mit dem er spricht, und für jede Sprache, in der Besucher schreiben. Für Persisch reserviert das ein Vielfaches dessen, was der Prompt wirklich kostet, gehalten für eine Anfrage und nie als Ausgabe erfasst. Früher zählte er den Prompt mit der pauschalen Regel von zwei Zeichen je Token, die oben geprüft wurde und auf cl100k_base bei allen 1.012 persischen Sätzen unter der echten Zahl lag. Eine zu kleine Reservierung ist eine Grenze, die in genau die Richtung falsch liegt, in die eine Grenze nie falsch liegen darf; diese Messung ist deshalb der Grund für die Änderung, und der Docstring des Schätzers verweist auf denselben Lauf über 1.012 Sätze. Die Monatssumme wird so oder so aus erfasstem Verbrauch gebildet, nicht aus der Schätzung.
Die Erfassung muss mit einem Schweigen zurechtkommen. OpenAI und Anthropic melden die Ausgabe-Tokens beide nach dem erzeugten Text, und die Streaming-Referenz von OpenAI warnt, dass Sie bei einem unterbrochenen oder abgebrochenen Stream „den letzten Usage-Chunk möglicherweise nicht erhalten“. Ein früh abgeschnittener Stream, durch ein Guardrail im Streaming oder einen geschlossenen Tab, endet, bevor die Meldung eintrifft – und jedes Zeichen, das er tatsächlich erzeugt hat, steht auf der Rechnung. Deshalb hält der Assistent den Text fest, während er gestreamt wird, und füllt die Lücke dort, wo der Anbieter nichts gemeldet hat, mit derselben Byte-Zahl; das erfasst eher zu viel als zu wenig. Die Zahlen des Anbieters gewinnen überall dort, wo er welche geliefert hat: Ein Durchgang, der zu Ende läuft, erfasst genau das Gemessene, nie eine Näherung davon. Der Artikel über Guardrails gegen Halluzinationen in RAG zeigt, wo diese Prüfung zwischen den übrigen Schichten des Assistenten sitzt.
Dasselbe Prinzip gilt für ein Produkt. Bei Booq, wo ich das AI Engineering leite, zeigt jeder Auftrag vor dem Start seinen Preis oder seine Anfangsschätzung, und ein fehlgeschlagener Auftrag erstattet seine Kosten automatisch, wie die Booq-Fallstudie beschreibt.
Häufige Fragen
Braucht Persisch bei OpenAI-Modellen mehr Tokens als Englisch?
Ja. Auf denselben Sätzen aus FLORES-200 brauchte Persisch 1,53× so viele Tokens wie Englisch auf o200k_base (GPT-4o, GPT-4.1 und GPT-5 in der Zuordnung von tiktoken) und 3,26× auf cl100k_base (GPT-4). Ihr eigener Traffic ergibt ein anderes Verhältnis, also zählen Sie es selbst.
Wie viele Tokens braucht Persisch bei Claude oder Gemini?
Das kann diese Messung nicht sagen. Anthropic veröffentlicht keinen Tokenizer für Claude, und das Gen-AI-SDK von Google bietet für einige Gemini-Modelle eine experimentelle lokale Zählung auf Basis offener Gemma-Tokenizer, die ich nicht gemessen habe. Die Verhältnisse oben lassen sich auf keinen der beiden Anbieter übertragen. Nutzen Sie den Endpunkt count_tokens von Anthropic oder count_tokens bei Gemini auf echten Anfragen, und zählen Sie erneut, wenn Sie das Modell wechseln.
Ist Arabisch günstiger als Persisch?
Auf vier der fünf hier gemessenen Tokenizer ja: Auf o200k_base brauchte Arabisch 1,38× so viele Tokens wie Englisch, Persisch 1,53×. Auf bge-m3 war es umgekehrt, 1,17× gegenüber 1,10×, passend dazu, dass die Trainingsdaten von XLM-R weit mehr Persisch als Arabisch enthielten.
Sollte ich ZWNJ entfernen oder auf arabische Buchstabenformen wechseln, um Tokens zu sparen?
Nein. ZWNJ durch ein Leerzeichen zu ersetzen senkte die Zahlen auf den Byte-Level-Tokenizern um 1,57 % bis 8,08 % und verändert die Wörter. Arabische Buchstabenformen sparten nur auf Qwen3 Tokens und kosteten sonst 2,20 % bis 11,95 % mehr. Beides bricht das exakte Matching, sofern nicht jede Anfrage genauso umgeschrieben wird.
Wie viele Zeichen hat ein persisches Token?
Das hängt vom Tokenizer ab: in dieser Messung von 1,40 auf cl100k_base bis 3,68 auf bge-m3, gegenüber 4,30 bis 4,91 für Englisch. Eine pauschale Regel, die auf einem Tokenizer sicher ist, kann auf einem anderen zu niedrig zählen. Diese Website hat ihre Reservierung von zwei Zeichen je Token nach diesem Lauf abgeschafft und reserviert stattdessen die Byte-Zahl. Das ist auch der allgemeine Rat: Reservieren Sie gegen eine Obergrenze oder eine Anbieterzählung, nicht gegen eine Faustregel.
Quellen
No Language Left Behind: Scaling Human-Centered Machine Translation (NLLB Team u. a., 2022)
Language Model Tokenizers Introduce Unfairness Between Languages (Petrov u. a., NeurIPS 2023)
Petrov u. a., Tokenlängen auf FLORES-200 (tokenization_lengths.csv)
Petrov u. a., Skript, das die Splits dev und devtest zusammenfasst (compute_tokenizations.py)
Tokenization Disparities as Infrastructure Bias (Teklehaymanot und Nejdl, 2025)
Unsupervised Cross-lingual Representation Learning at Scale (Conneau u. a., XLM-R und CC-100)
tiktoken, Zuordnung von Modell zu Encoding (openai/tiktoken)
Google Gen AI Python SDK: experimenteller lokaler Tokenizer (local_tokenizer.py)
Wenn Sie ein LLM-Feature für persischsprachige Nutzer planen, beginnen Sie mit der Projektanalyse.