
Arquitectura de un pipeline de doblaje con IA: lecciones de producción
Cómo funciona el doblaje con IA en producción: cuatro etapas de modelos, los escollos del persa y el respaldo entre proveedores que sustituyó al silencio.
Un pipeline de doblaje con IA encadena cuatro etapas basadas en modelos: la transcripción con detección de hablantes, una traducción que se ajuste a los tiempos del original, una voz distinta para cada hablante y la alineación temporal junto con la mezcla final. Los modelos son la parte que se puede alquilar. Que los doblajes se sigan entregando depende de la plataforma que los rodea: una pasarela por proveedor de IA con respaldo automático, colas persistentes, trabajo que se reanuda tras un fallo, un precio visible antes de que el trabajo se ejecute y un reembolso cuando falla. En Booq, donde soy CTO, la caída de un proveedor de voz produjo una vez doblajes con silencio donde faltaban frases. Ahora la síntesis de voz recurre a una cadena de proveedores: una voz ligeramente distinta es mejor que el silencio.
Cómo funciona un pipeline de doblaje con IA: cuatro etapas
La investigación sobre doblaje automático describe una cadena parecida. Federico y sus colegas (2020) partieron de un pipeline de traducción de voz a voz (speech-to-speech translation) y le añadieron lo que necesita el doblaje:
Traducción automática que produce una salida de la longitud deseada.
Alineación prosódica: hacer coincidir las frases y las pausas de la traducción con los segmentos del habla original.
Síntesis de voz (text-to-speech, TTS) con un ajuste fino de la duración de cada enunciado.
Renderizado de audio que añade el ruido de fondo y la reverberación extraídos del audio original.
Un pipeline que dobla un vídeo en el que aparecen varias personas también tiene que saber quién habla.
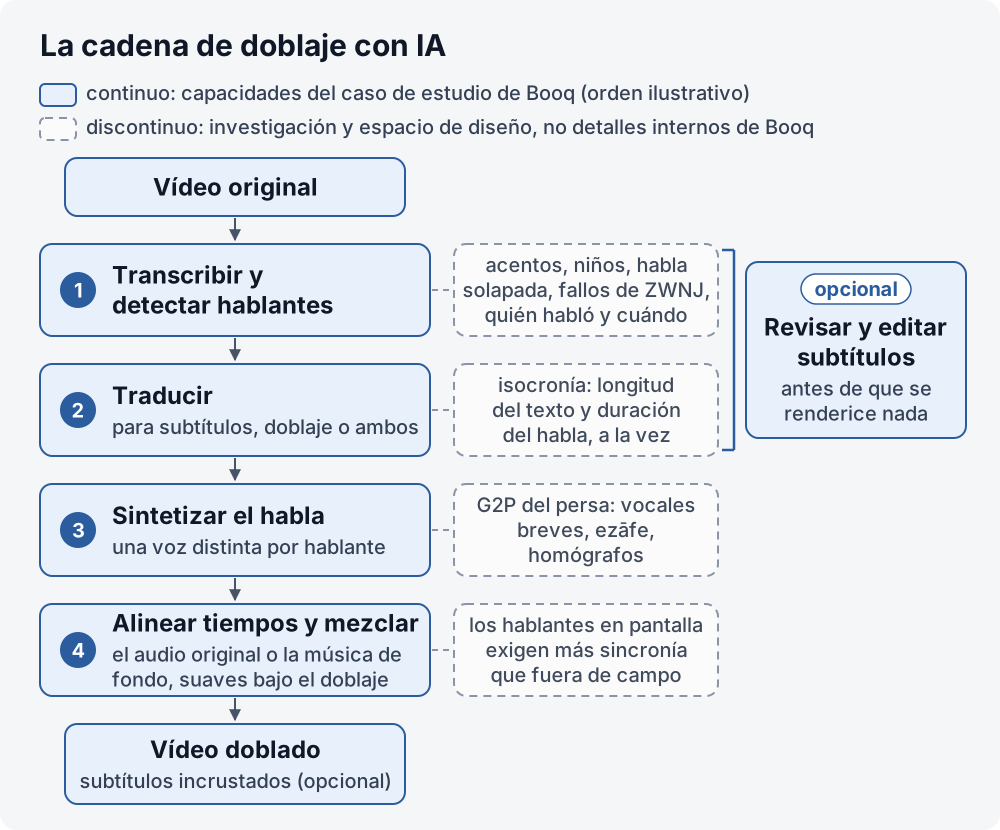
Abrir el diagrama de la cadena a tamaño completo

Las secciones dedicadas a cada etapa describen la investigación y el espacio de diseño: qué tiene que resolver cada etapa y dónde se rompe. No describen el funcionamiento interno de ningún producto, tampoco el de Booq. Donde aparece Booq, solo se recoge lo que dice su caso de estudio, y la sección sobre la pronunciación del persa se apoya en mi propia investigación sobre síntesis de voz. Las secciones sobre la plataforma sí son de primera mano.
Etapa 1: transcripción y detección de hablantes
Todas las etapas posteriores heredan la transcripción. Una palabra que el reconocedor se inventa se traduce, se le pone voz y se ajusta a los tiempos con la misma seguridad que una palabra que el hablante sí dijo. Para el persa, la evidencia pública más útil sobre dónde se equivoca el reconocimiento automático del habla (ASR) es PSRB, un benchmark publicado en 2025.
Dónde falla el reconocimiento de voz en persa
PSRB evalúa diez sistemas de ASR, comerciales y de código abierto. Su conclusión general es que los modelos suelen funcionar bien con el persa estándar, pero tienen dificultades con los acentos regionales, el habla infantil y ciertos retos lingüísticos concretos. Los detalles parecen una descripción del audio que la gente quiere doblar:
Acentos. De los 12 acentos evaluados, la precisión del reconocimiento fue más baja en los de Mashhad y Yazd.
Niños. Los hablantes infantiles fueron los peor reconocidos.
Varios hablantes. Todos los modelos cometieron más errores con audio de varios hablantes que con audio de un solo hablante. Los autores señalan el habla solapada como el principal reto de ese tipo de audio, aunque el benchmark mantuvo el solapamiento al mínimo, y algunos modelos omitieron a veces a un hablante entero de la transcripción.
Género. Los audiolibros dieron las tasas de error más bajas. Los programas de entrevistas, la animación y las películas, donde abundan el diálogo espontáneo, el habla solapada y el ruido de fondo, obtuvieron resultados sustancialmente peores.
Registro. El 71,3 % del habla del benchmark es informal.
El artículo también identifica tipos de error propios de la escritura y el habla persas:
Límites de palabra. El plural درختها («árboles») se escribe con un carácter de no unión de ancho cero (ZWNJ). Los errores aparecen cuando el ZWNJ se omite o se sustituye: درخت ها o درختها.
Cambios de registro. La forma informal میخوام برم («quiero ir») puede transcribirse como la formal میخواهم بروم, o al revés.
He-Kasreh. La /e/ breve que marca posesión o vínculo puede escribirse como la letra he (ه): کتاب او («su libro», de él) puede transcribirse como کتابه او. Es la ezāfe escrita de forma explícita, el mismo sonido no escrito al que vuelve la etapa 3.
Paráfrasis. خوش میگذره («es agradable») puede convertirse en حال میده («sienta bien»). El significado sobrevive; las palabras, no.
Alucinación. Texto fluido y coherente que no se basa en absoluto en el audio.
La tasa de error de palabras (WER) en su forma simple cuenta cada sustitución como una palabra entera equivocada, así que un desliz con el ZWNJ puede costar tanto como una palabra distinta, o más: si el ZWNJ se convierte en un espacio, una palabra se parte en dos, lo que cuenta como una sustitución más una inserción. PSRB propone una variante ponderada por sustituciones, SW-WER: para cada sustitución se calcula la tasa de error de caracteres y se multiplica por el número de palabras de esa alineación, de modo que un desliz de espaciado cuesta menos que una palabra distinta. La recuperación sobre texto en persa tiene que normalizar esos mismos caracteres, como explica el artículo sobre búsqueda híbrida para RAG en persa.
La consecuencia para el diseño, tal como yo la interpreto: el audio que la gente quiere doblar es justo donde el reconocimiento es más débil, y una frase alucinada o parafraseada no se queda en la transcripción. Se convierte en una frase doblada con total seguridad. Ese es el argumento a favor de un punto de revisión antes del renderizado. Booq ofrece los dos modos: ejecutarlo sin intervención o hacer una pausa para revisar y editar los subtítulos antes de renderizar nada.
Diarización de hablantes: quién habló y cuándo
Park y sus colegas definen la diarización de hablantes como la tarea de identificar «quién habló y cuándo». En un doblaje, decide qué voz recibe cada frase. El Third DIHARD Diarization Challenge evaluó sistemas en 11 dominios diversos y concluyó que en muchos de ellos, incluido el vídeo web, el problema «sigue lejos de estar resuelto».
La comprobación que yo pondría después de la diarización en cualquier pipeline es sencilla: ¿tiene frases cada hablante detectado y tiene hablante cada frase? Algunos sistemas de PSRB eliminaron a un hablante entero de la transcripción, y un hablante perdido se convierte en una pista de voz que falta.
Etapa 2: una traducción que quepa en el tiempo
El doblaje añade una restricción a la traducción: la nueva frase tiene que decirse en más o menos el tiempo que ocupaba la original. Si se traduce con libertad, la voz sintética tiene que apresurarse o la frase se echa encima de la siguiente.
Isocronía: longitud y duración son un mismo problema
En la investigación, esto se llama isocronía. Chronopoulou y sus colegas (2023) la describen como un habla nueva alineada en el tiempo con el vídeo original, «incluidos los movimientos de la boca, las pausas y los gestos de las manos». Entrenan un modelo que optimiza a la vez la traducción y la duración de su habla, e informan de un habla que se ajusta mejor a los tiempos del original que los trabajos anteriores, con una arquitectura más sencilla.
Los trabajos anteriores controlaban la longitud en el texto. Isometric MT (Lakew y sus colegas, ICASSP 2022) usa como objetivo de ejemplo una traducción cuya longitud, en número de caracteres, quede dentro de un ±10 % de la del original, y es franco sobre el precio: controlar la longitud de la salida cuesta calidad de traducción, y la mitigación habitual es generar varias traducciones candidatas (hipótesis N-best) y reordenarlas después. Ese ±10 % es el ejemplo de un artículo, no una norma del sector, y los caracteres solo son una aproximación de lo que se tarda en decir una frase.
Cuando el ritmo falla, se oye. La página de ayuda de YouTube sobre el doblaje automático incluye el ritmo del habla entre los motivos por los que un vídeo puede no cumplir los requisitos: un habla original demasiado rápida «daría como resultado un doblaje acelerado imposible de escuchar».
¿Hasta qué punto debe ser estricta la sincronización?
Más estricta en pantalla que fuera de campo y, a juzgar por la práctica profesional, menos absoluta de lo que a menudo la trata la investigación. Brannon, Virkar y Thompson (TACL 2023) estudiaron cómo doblan las personas a partir de 319,57 horas de vídeo de 54 títulos de producción profesional. Sus resultados cuestionan varios supuestos habituales en la literatura sobre doblaje, tanto humano como automático. Defienden que la naturalidad vocal y la calidad de la traducción importan más que las restricciones isométricas (de longitud en caracteres) y de sincronía labial en las que se suele insistir, y abogan por una visión más matizada de cuánto importan las restricciones de tiempo.
También importa si el hablante está en pantalla. Virkar y sus colegas (2022) tomaron el modelo de alineación prosódica que ya habían construido para el doblaje en pantalla y lo ampliaron al doblaje fuera de campo (off-screen), que «requiere restricciones de sincronización menos estrictas» que doblar a un hablante cuya boca se ve. Por tanto, el margen de tiempo es una decisión por escena, no un único ajuste global.
Sobre Booq, lo publicado es que los tiempos se alinean con el original. Es todo lo que dice el caso de estudio sobre la sincronización, y todo lo que afirmo aquí.
Etapa 3: una voz distinta para cada hablante
En Booq, cada hablante detectado recibe una voz distinta. Cualquier doblaje con varios hablantes necesita dos propiedades de sus voces: que dos hablantes no suenen parecidos y que un mismo hablante conserve la misma voz de la primera frase a la última. Recuerde la segunda; el post mortem de más abajo cuenta cómo salió perdiendo.
Hay pocos datos abiertos de habla en persa. Los autores de ParsVoice escriben que el persa «sigue estando muy infrarrepresentado en los recursos abiertos de habla y texto». Su corpus incluye un subconjunto de 2200 horas listo para TTS, más de 25 veces mayor que el mayor conjunto de datos abierto de TTS en persa disponible hasta entonces. Los datos son una restricción. La otra llega antes de que exista audio alguno: decidir cómo se pronuncia el texto.
Pronunciación del persa: vocales breves, ezāfe y homógrafos
Entre junio de 2021 y septiembre de 2022 trabajé en investigación sobre síntesis de voz en persa. La encargó y supervisó MCI (Hamrah-e Aval), el mayor operador móvil de Irán, y la gestionó la National Elites Foundation dentro de su programa Shahid Ahmadi Roshan. La parte difícil era lingüística. En aquel pipeline, el texto escrito pasa primero por la conversión de grafema a fonema (G2P), que decide cómo se pronuncia. Después, un modelo de síntesis de voz y un vocoder producen el habla; el vocoder es el componente que convierte la salida acústica del modelo en una forma de onda de audio. La escritura persa vuelve ambiguo ese primer paso de tres maneras:
Las vocales breves no se escriben, así que el texto por sí solo no determina la pronunciación.
La ezāfe tampoco se escribe y hay que inferirla.
Los homógrafos comparten una misma grafía entre palabras distintas y no se pueden distinguir sin contexto.
La investigación publicada dice lo mismo. Los autores de GE2PE (Findings of EMNLP 2024) describen la ezāfe como un sonido /e/ que une sustantivos con adjetivos y con sustantivos descriptivos, y dan un ejemplo de homógrafo: /kerm/, /kerem/ y /karam/ son idénticos por escrito, کرم. Concluyen que el G2P del persa necesita una entrada a nivel de sintagma o de oración para lograr resultados aceptables. Doostmohammadi y sus colegas (2020) añaden que la ezāfe casi nunca se marca en la escritura persa, lo que provoca equivocaciones al leer oraciones complejas y errores en el procesamiento del lenguaje. El proyecto se describe en el caso de estudio sobre síntesis de voz en persa.
La consecuencia para el diseño es una inferencia mía, no un resultado de esos artículos: no alimente un TTS en persa con los fragmentos en los que se corta una pista de subtítulos. Un corte entre subtítulos puede partir una cadena de ezāfe o separar un homógrafo de las palabras que lo desambiguan. Si ketāb-e dust-e man («el libro de mi amigo») se reparte entre dos subtítulos y el primer fragmento termina en ketāb, ya no queda nada en ese fragmento que indique que ketāb lleva la ezāfe /e/. Sintetice oraciones completas y después ajuste el audio a la línea de tiempo.
Etapa 4: alineación temporal y mezcla final
La última etapa convierte los clips en una banda sonora que pertenece al vídeo. En el pipeline de Federico, el renderizado añade el ruido de fondo y la reverberación extraídos del audio original, para que la nueva voz se sitúe en la misma escena acústica que la imagen.
En Booq, el acabado puede incluir subtítulos incrustados con estilo para vídeo vertical y panorámico, con el audio original o la música de fondo sonando suavemente bajo el doblaje. Los subtítulos incrustados forman parte de la imagen, así que su disposición tiene que decidirse para cada relación de aspecto antes del renderizado; ningún reproductor puede arreglarla después.
A esta etapa le corresponden dos preguntas de diseño. La primera es qué hacer con una frase cuyo audio sintetizado sigue siendo demasiado largo después de la traducción. La investigación y la práctica ofrecen tres palancas, y elegir entre ellas es una decisión de diseño, no un resultado:
Acortar la frase al traducir. Aquí es donde trabajan Isometric MT y los modelos que optimizan a la vez traducción y duración.
Ajustar en el TTS la duración de cada enunciado. El pipeline de Federico afina la duración enunciado a enunciado.
Acelerar la voz, dentro de un límite. Esta palanca viene de la práctica, no de la investigación, y solo funciona hasta cierto punto: la página de ayuda de YouTube advierte de que un doblaje acelerado puede resultar imposible de escuchar.
La segunda pregunta es qué oye el oyente donde falta una frase. Esa resultó ser una cuestión de arquitectura, no de audio.
La plataforma alrededor de los modelos
Todo lo anterior es investigación que se puede leer y modelos que se pueden alquilar. En Booq, cada funcionalidad depende de proveedores de IA externos, y cada uno de ellos puede fallar o cambiar de forma independiente. Como CTO, definí la arquitectura de Booq y la llevé del primer commit a producción; el caso de estudio de Booq describe la plataforma. Todas las lecciones de su post mortem están alrededor de los modelos, no dentro de ellos.
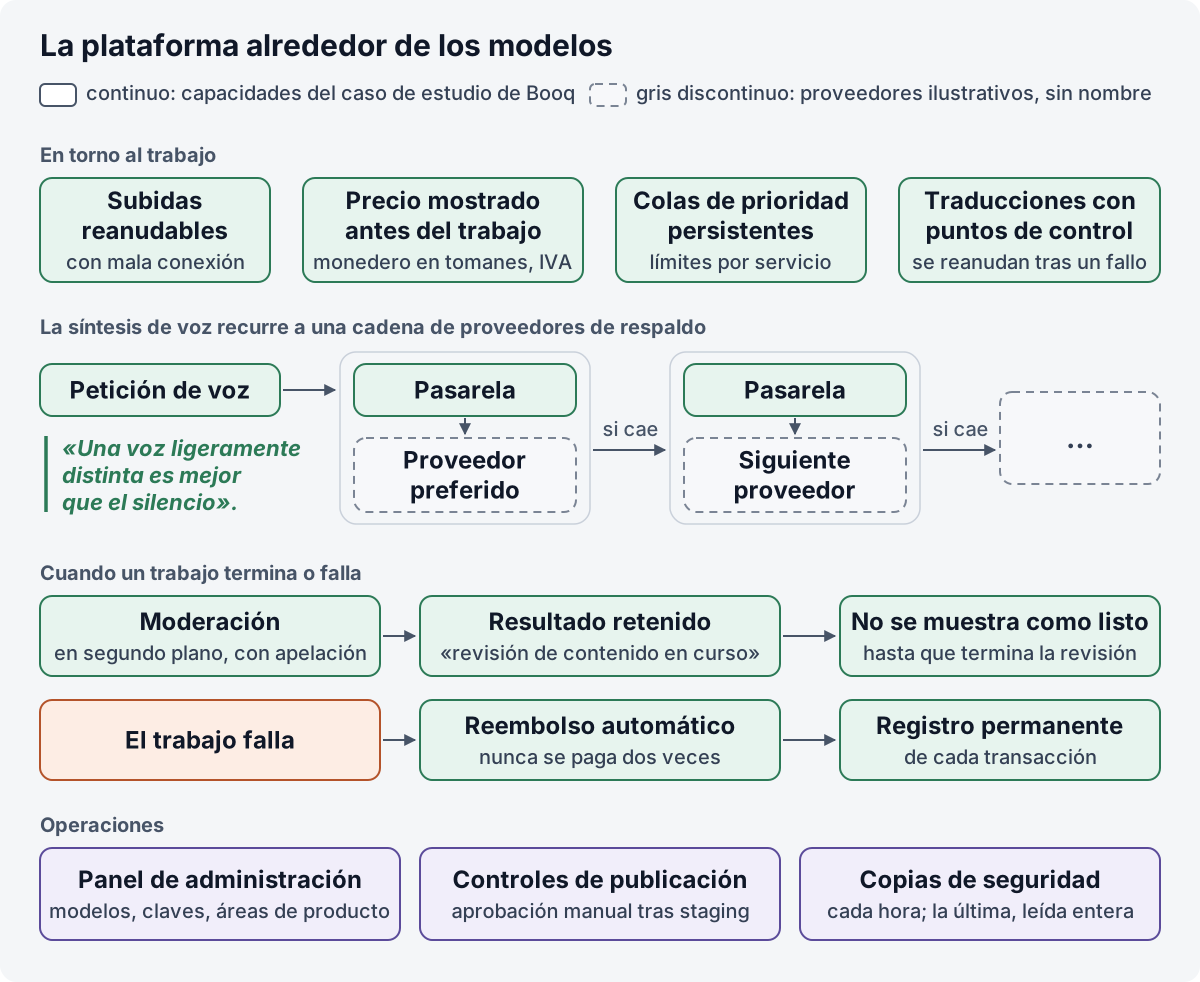
Abrir el diagrama de la plataforma a tamaño completo

Una pasarela por proveedor de IA
Booq es un conjunto de servicios independientes detrás de una única aplicación web, con una pasarela (gateway) propia para cada proveedor de IA. Esa única decisión es la que permite cambiar un modelo, rotar una clave o esquivar automáticamente a un proveedor que falla, sin tocar el resto del producto. Los modelos y las claves de los proveedores se cambian desde el panel de administración, sin volver a desplegar. El caso de estudio asocia cada pasarela a un respaldo automático, y el post mortem de más abajo muestra por qué la síntesis de voz lo necesitaba.
Colas de prioridad persistentes y puntos de control
Doblar un vídeo largo no tiene cabida dentro de una petición web. En Booq, el procesamiento pesado espera en colas de prioridad persistentes con límites por servicio. Los límites por servicio son los que impiden que un servicio muy ocupado deje sin recursos a los demás.
Las traducciones guardan puntos de control (checkpoints) y retoman el trabajo donde lo dejaron tras un fallo. Sin puntos de control, un fallo cerca del final de una transcripción larga repite todas las llamadas al proveedor hechas antes, y cada una de esas llamadas se vuelve a pagar.
Subidas reanudables con conexiones irregulares
Los archivos de vídeo grandes llegan a Booq a través de conexiones irregulares, y las subidas, incluidas las de varios gigabytes, se reanudan en una red deficiente en lugar de empezar de nuevo.
El mecanismo general se está estandarizando. Resumable Uploads for HTTP es un Internet-Draft activo del grupo de trabajo HTTP del IETF, todavía no un RFC: si el servidor puede indicar cuántos datos procesó antes de la interrupción, el cliente reanuda desde ese punto en lugar de volver a enviarlo todo. Es un trabajo en curso, no una descripción de la implementación de Booq.
Precio antes del trabajo, reembolso si falla
La facturación forma parte del pipeline. En Booq, cada trabajo muestra su precio, o su estimación inicial, antes de ejecutarse. El monedero es de prepago en tomanes, con el IVA visible desde el principio; cada transacción queda en un registro contable permanente y un trabajo fallido se reembolsa automáticamente. Los reembolsos están protegidos para que nunca se abonen dos veces.
Esa última propiedad merece las pruebas más duras: un reintento tras agotarse el tiempo de espera es justo el momento en que un reembolso ingenuo paga dos veces.
Interruptores, no nuevas versiones
En Booq, las áreas del producto se activan o desactivan sin publicar una nueva versión. En la taxonomía de feature toggles de Pete Hodgson, eso se acerca a un ops toggle: uno que permite a los operadores desactivar o degradar rápidamente una funcionalidad en producción.
El acceso se separa con el mismo criterio. Clientes, administradores y personal de soporte usan cada uno una aplicación desplegada por separado, un inicio de sesión en una no sirve en otra y las consolas exigen un segundo factor, con permisos basados en roles.
Post mortem: cuando la coherencia de la voz perdió frente al silencio
Al principio, la síntesis de voz de Booq se fijó a propósito a un único proveedor, porque otro proveedor significa otra voz. En un doblaje, la coherencia parecía la propiedad que había que proteger. Entonces ese proveedor sufrió una caída, y los doblajes se montaron con silencio donde faltaban frases.
Ahora la síntesis de voz recurre a una cadena de proveedores de respaldo, con el principio de que una voz ligeramente distinta es mejor que el silencio.
Diseñar a propósito una cadena de respaldo
La elección original no fue un descuido; protegía una propiedad real. El caso de estudio resume así los cambios de rumbo a los que llevó operar la plataforma en producción: cada uno «cambió una suposición cómoda por un comportamiento por defecto más seguro». La lección es decidir qué fallo acepta usted antes de que una caída decida por usted. Cuando el proveedor de voz preferido está caído, un pipeline puede dejar un hueco, dar el trabajo por fallido y reembolsarlo, o usar otra voz. Solo el hueco le entrega al oyente un doblaje con agujeros.
De ahí se sigue una segunda decisión, y lo que viene a continuación es análisis mío, no una descripción de Booq: cuánto sustituye el respaldo. Si solo la frase que falta cambia de proveedor, la voz de ese hablante cambia en mitad de la escena. Si cambia la pista completa del hablante, el doblaje se mantiene coherente, pero se rehace más trabajo.
El libro de SRE de Google describe una idea relacionada para servicios sobrecargados, la degradación controlada (graceful degradation): hacer menos trabajo rebajando la calidad de las respuestas. Lo que se traslada es su advertencia de que «la ruta de código que nunca se usa es la ruta de código que (a menudo) no funciona» y su consejo de ejercitar con regularidad el modo degradado. Lo que yo añadiría a cualquier cadena de respaldo de voz, como recomendación y no como descripción de Booq, son trabajos de prueba programados sobre clips internos a través de cada proveedor de la cadena, para saber que el respaldo funciona antes de que una caída lo necesite.
El fallo correcto depende del producto. El asistente de este sitio hace lo contrario: cuando nada en el sitio respalda una pregunta, la rechaza con un texto fijo en lugar de adivinar, y si no considera que la pregunta trate sobre mí, el modelo de lenguaje no llega a llamarse. Al responder preguntas, no decir nada es el fallo seguro, porque una respuesta equivocada dada con seguridad es peor que ninguna respuesta. El diseño se explica en guardrails contra las alucinaciones en RAG, y la página RAG frente a sin RAG del laboratorio se basa en la misma regla. En un doblaje, el silencio es el fallo. Qué fallo es aceptable es una decisión de producto, no de modelo.
Moderación sin hacer esperar al usuario
Antes, en Booq la revisión de contenidos se ejecutaba dentro de la creación del proyecto, así que los usuarios esperaban entre el final de la subida y la página de su proyecto. Ahora se ejecuta en segundo plano. Se revisan imágenes, vídeo, audio y texto, con una vía de apelación, y un resultado terminado queda retenido en «revisión de contenido en curso» hasta que la revisión concluye. El resultado no se presenta como listo mientras su revisión siga en marcha.
El patrón sirve para cualquier comprobación lenta en un pipeline de medios: sáquela de la ruta de la petición y haga explícito el estado intermedio.
Controles de publicación y copias de seguridad que alguien ha leído
Los despliegues a producción de Booq pasaron de ser automáticos a requerir una aprobación manual que solo se desbloquea cuando se superan las comprobaciones en preproducción (staging). Cada versión pasa por compilación, pruebas, un despliegue en preproducción y una prueba de humo (smoke test) antes de que una persona la apruebe para producción, y se puede lanzar manualmente una reversión de emergencia a la versión anterior. La plataforma se ejecuta en un clúster de contenedores definido como código.
Las copias de seguridad pasaron a hacerse cada hora, y la más reciente se leyó de principio a fin, porque una copia de seguridad que nadie ha leído nunca no es una copia de seguridad. El libro de SRE de Google lo dice con más crudeza: «En realidad nadie quiere hacer copias de seguridad; lo que la gente quiere de verdad son restauraciones». También pone el listón más alto: solo se sabe que se puede recuperar el estado reciente si de verdad se recupera, así que las pruebas de recuperación deberían automatizarse siempre que sea posible y ejecutarse de forma continua. Leer una copia de seguridad de principio a fin es el mínimo, no la meta.
Construir o comprar: lista de comprobación para un pipeline de doblaje con IA
Fallo y respaldo
Cuando un proveedor de voz falla a mitad de un trabajo, ¿qué recibe el oyente: silencio, otra voz o un trabajo fallido y un reembolso? Decídalo antes de que una caída decida por usted.
Cuando el respaldo entra en acción, ¿sustituye una sola frase o la pista completa del hablante?
¿Se ejercita a propósito la ruta de respaldo, con trabajos de prueba programados, o solo durante las caídas?
Plataforma y facturación
¿Está cada proveedor de IA detrás de su propia pasarela, de modo que cambiar un modelo, rotar una clave o esquivar a un proveedor no requiera publicar una versión?
¿Se ejecuta el trabajo pesado desde colas persistentes con límites por servicio, fuera de la petición web?
¿Puede una traducción larga reanudarse desde un punto de control, y puede una subida grande reanudarse tras perder la conexión?
¿Se muestra el precio o la estimación antes de ejecutar el trabajo, y es imposible que un reembolso se pague dos veces?
¿Está la moderación fuera de la ruta de la petición, con un estado explícito «en revisión»?
Reconocimiento, tiempos y voces
¿Se ha probado el reconocimiento con su propio audio: acentos, niños, habla informal, varios hablantes, sonido de películas y de programas de entrevistas, y no solo audiolibros?
¿Su cálculo de la WER trata un desliz de espaciado del ZWNJ como una palabra entera equivocada? Normalice primero o use una métrica ponderada como SW-WER.
Después de la diarización, ¿tiene cada hablante detectado frases y una voz?
¿Hay un punto para revisar y editar los subtítulos antes del renderizado?
¿Qué grado de rigor necesita la sincronización para este contenido: caras en pantalla o narración fuera de campo?
¿Recibe el TTS en persa oraciones completas, y no fragmentos de subtítulos que corten una cadena de ezāfe?
Publicación y recuperación
¿Aprueba una persona el paso a producción tras las comprobaciones en preproducción y la prueba de humo, y se puede revertir a mano?
¿Ha leído alguien una copia de seguridad de principio a fin?
Preguntas frecuentes
¿Cómo funciona el doblaje con IA?
Un pipeline de doblaje con IA transcribe el habla original y detecta quién habla, traduce cada frase para que pueda decirse en aproximadamente el tiempo original, da a cada hablante una voz sintética distinta y, por último, alinea los tiempos y mezcla el habla nueva con el fondo original. En producción, esas etapas se ejecutan dentro de una plataforma de colas, pasarelas de proveedores con respaldo y, idealmente, un punto de revisión antes del renderizado.
¿Puede la IA doblar un vídeo del inglés al persa?
Técnicamente, sí: la cadena es la misma para cualquier par de idiomas. Doblar al persa añade un problema propio del idioma en la etapa de voz, porque la escritura deja sin escribir las vocales breves y la ezāfe, de modo que la pronunciación hay que inferirla del contexto. La cobertura de las plataformas generalistas es desigual: en septiembre de 2026, la página de ayuda del doblaje automático de YouTube incluye el farsi como idioma de origen que se dobla al inglés, y los vídeos en inglés no figuran como doblables al farsi.
¿El doblaje con IA se ajusta al movimiento de los labios?
No necesariamente, y tampoco siempre hace falta. La investigación sobre isocronía se plantea ese objetivo: un habla nueva alineada en el tiempo con el vídeo original, incluidos los movimientos de la boca, las pausas y los gestos. Cuánto ajustarse es una decisión de diseño. El doblaje fuera de campo necesita una sincronización menos estricta que doblar a un hablante cuya boca se ve, y un amplio estudio sobre doblaje humano profesional sostiene que la naturalidad vocal y la calidad de la traducción importan más que las restricciones de sincronía labial en las que se suele insistir.
¿Por qué un doblaje con IA tiene a veces silencios o una voz distinta?
Una causa es que un proveedor de voz falle a mitad de un trabajo. Un pipeline fijado a un solo proveedor mantiene las voces coherentes, pero puede dejar huecos durante una caída; uno con cadena de respaldo cubre la frase con una voz ligeramente distinta. Booq pasó del primer diseño al segundo después de que una caída produjera doblajes con silencio donde faltaban frases. El silencio también puede originarse antes en la cadena, cuando el reconocimiento pierde a un hablante y no deja nada que traducir.
¿Cómo se debe evaluar el reconocimiento de voz en persa?
Con su propio audio, no solo con habla leída y limpia. Incluya acentos regionales, voces infantiles, varios hablantes y sonido de películas o de programas de entrevistas, todas ellas condiciones en las que PSRB encontró más errores, además de habla informal. Normalice el ZWNJ y las formas árabe y persa de las letras ye y kaf antes de puntuar, o use una métrica ponderada por sustituciones como SW-WER, y lea los errores además de la tasa: un solo número no distingue un desliz de espaciado de una oración fluida que el hablante nunca dijo.
Si está valorando construir un sistema de voz o de doblaje, el servicio de IA de voz abarca TTS, ASR y pipelines de doblaje, incluidos los casos difíciles del persa.
Fuentes
Booq: traducción y doblaje de vídeo con IA, centrados en el persa, caso de estudio en este sitio
Investigación sobre síntesis de voz en persa para MCI, caso de estudio en este sitio
Sedghiyeh et al., PSRB: A Comprehensive Benchmark for Evaluating Persian ASR Systems, arXiv, 2025 (texto completo)
Federico et al., From Speech-to-Speech Translation to Automatic Dubbing, arXiv, 2020
Chronopoulou et al., Jointly Optimizing Translations and Speech Timing to Improve Isochrony in Automatic Dubbing, arXiv, 2023
Lakew et al., Isometric MT: Neural Machine Translation for Automatic Dubbing, ICASSP 2022
Virkar et al., Prosodic Alignment for off-screen automatic dubbing, arXiv, 2022
Brannon, Virkar y Thompson, Dubbing in Practice: A Large Scale Study of Human Localization With Insights for Automatic Dubbing, TACL, 2023
Ayuda de YouTube, Use automatic dubbing, consultado en septiembre de 2026
Park et al., A Review of Speaker Diarization: Recent Advances with Deep Learning, Computer Speech & Language, 2022
Ryant et al., The Third DIHARD Diarization Challenge, arXiv, 2020
Rahmati y Sameti, GE2PE: Persian End-to-End Grapheme-to-Phoneme Conversion, Findings of EMNLP 2024
Doostmohammadi et al., Persian Ezafe Recognition Using Transformers and Its Role in Part-Of-Speech Tagging, arXiv, 2020
Ranjbar Kalahroodi, Faili y Shakery, ParsVoice: A Large-Scale Multi-Speaker Persian Speech Corpus for Text-to-Speech Synthesis, EMNLP 2026 (aceptado; arXiv v4, septiembre de 2026)
Google, Site Reliability Engineering: Addressing Cascading Failures
Google, Site Reliability Engineering: Data Integrity: What You Read Is What You Wrote
Grupo de trabajo HTTP del IETF, Resumable Uploads for HTTP, Internet-Draft
Pete Hodgson, Feature Toggles (aka Feature Flags), martinfowler.com, 2016, revisado en 2017