
Guardrails contra las alucinaciones en RAG: un diseño en cinco capas
Cinco guardrails contra las alucinaciones en RAG: rechazo antes de recuperar, umbral de similitud, el prompt, la compuerta por frases y las reglas de voz.
La generación aumentada por recuperación (RAG) no impide que un modelo se invente respuestas, y un contexto débil puede volverlo más seguro en lugar de más prudente. Los guardrails contra las alucinaciones en RAG viven sobre todo en el código que rodea al modelo. Constrúyalos como cinco capas en un orden fijo, tal como funciona el asistente de este sitio:
Rechace antes de recuperar las preguntas que el asistente nunca debe responder.
Dé al modelo solo evidencia con la que se le puedan pedir cuentas: pasajes que superen un umbral mínimo de similitud o, para las preguntas sobre el trabajo en su conjunto, los propios registros del sitio. Si no hay ni lo uno ni lo otro, rechace sin llamarlo.
Trate el prompt de sistema como la única capa que el modelo puede ignorar.
Libere la respuesta frase a frase, solo después de comprobaciones deterministas.
No deje nunca que el asistente hable como la persona que hay detrás.
Un control de gasto antes de la llamada al modelo completa el diseño.
Este sitio lo he construido y lo mantengo yo, asistente incluido. No publico ninguna cifra de precisión sobre él, y la sección de medición explica por qué.
Por qué RAG sigue alucinando
En un sistema RAG, un recuperador devuelve pasajes de un corpus y el modelo de lenguaje escribe su respuesta a partir de ellos. Una alucinación es una afirmación falsa o sin respaldo presentada como si fuera cierta.
La recuperación estrecha el margen de lo que es probable que diga un modelo. No lo acota.
La recuperación puede volver al modelo más seguro, no más correcto
Unos investigadores de Google separaron dos casos: el contexto recuperado que basta para responder a la pregunta y el que no. Al resumir su artículo, presentado en ICLR 2025, los autores son tajantes: «aunque RAG mejora en general el rendimiento global, reduce, paradójicamente, la capacidad del modelo de abstenerse de responder cuando corresponde». En uno de los ejemplos, Gemma pasó de dar respuestas incorrectas en el 10,2 % de las preguntas sin contexto al 66,1 % con contexto insuficiente.
Saber cuándo no responder compensa: el método de generación selectiva de los autores mejoró la proporción de respuestas correctas —entre las veces en que el modelo sí respondía— entre el 2 % y el 10 % para Gemini, GPT y Gemma.
Un recuperador top-k devuelve k pasajes sean o no relevantes. Si es el modelo el único que juzga si bastan, la abstención queda en manos del componente que esta investigación muestra que a menudo se equivoca.
A los modelos se les premia por adivinar
Kalai y sus colegas sostienen que «los modelos de lenguaje alucinan porque los procedimientos de entrenamiento y evaluación premian adivinar por encima de reconocer la incertidumbre». Cuando la corrección no da ningún punto por un «no lo sé», adivinar sube la nota. Una instrucción para admitir la incertidumbre va en contra de ese incentivo. Ayuda. No es un control.
Las herramientas jurídicas comerciales seguían alucinando
Algunos proveedores de investigación jurídica promocionaron RAG como una forma de «eliminar» las alucinaciones. La primera evaluación prerregistrada de herramientas de investigación jurídica con IA concluyó que los productos de LexisNexis y Thomson Reuters alucinaban cada uno entre el 17 % y el 33 % de las veces. Lo que eso significa para un producto jurídico está en las alucinaciones de la IA jurídica: qué construir.
Las cinco capas de un vistazo
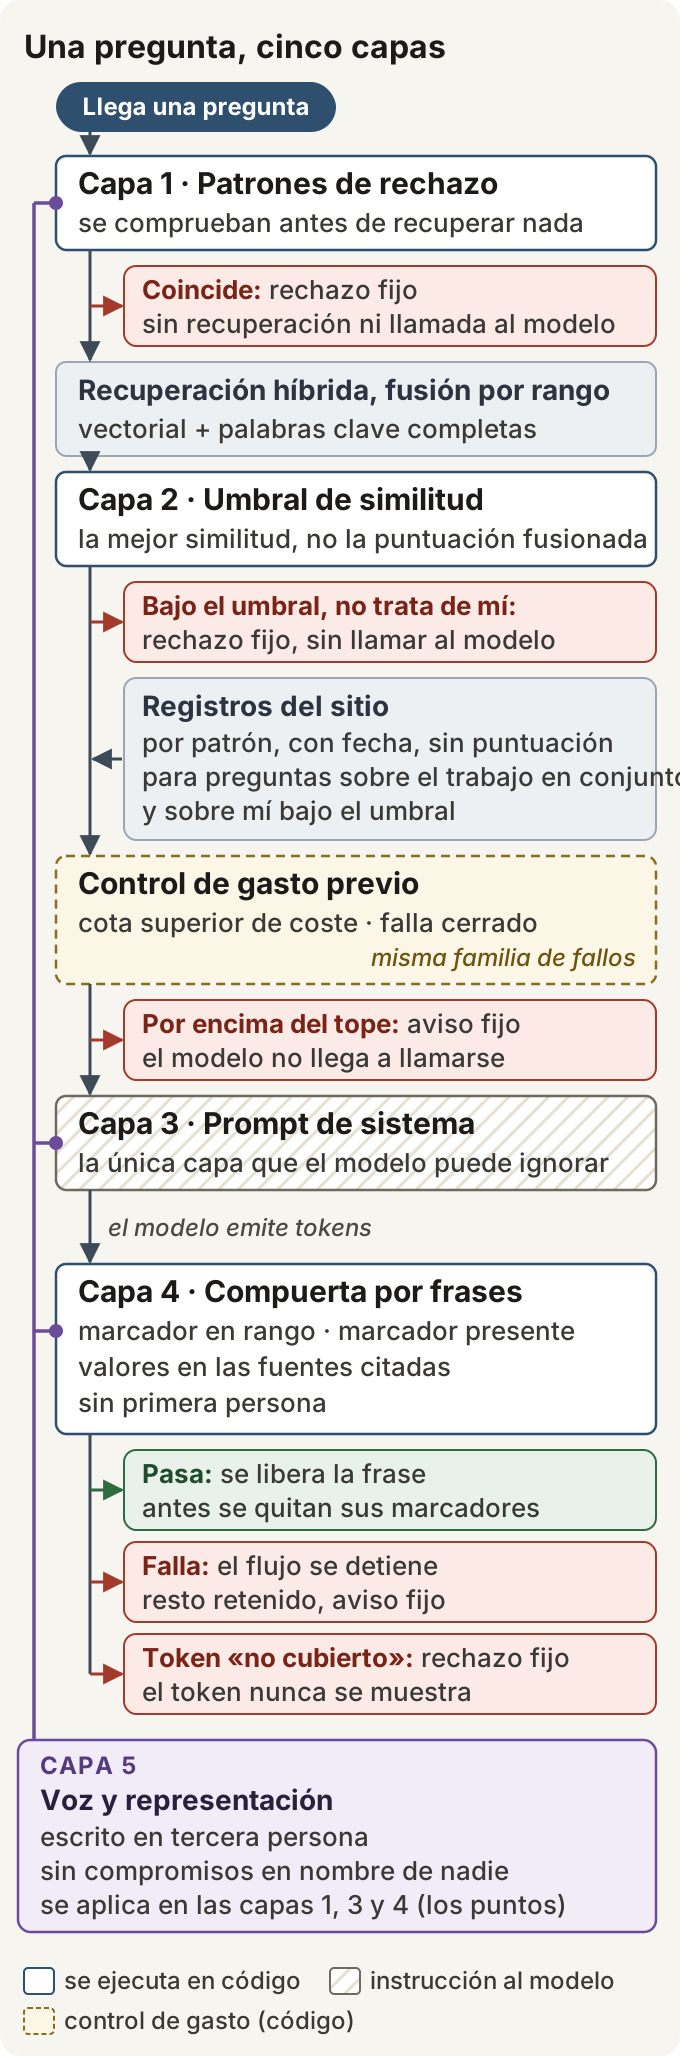
Capa | Qué evita | Se ejecuta en | Cuándo se activa |
|---|---|---|---|
1. Patrones de rechazo | Respuestas que el asistente nunca debe dar | Código | Rechazo fijo antes de recuperar |
2. Umbral de similitud | Respuestas construidas sobre evidencia débil | Código | Rechazo fijo, sin llamada al modelo |
3. Prompt de sistema | Saltarse las reglas, cuando el modelo obedece | El modelo | Nada lo hace cumplir por sí solo |
4. Compuerta por frases | Afirmaciones sin fuente, valores inventados, primera persona | Código | El flujo se detiene y el resto se retiene |
5. Reglas de voz | Compromisos asumidos en nombre de otra persona | Código y prompt | A través de las capas 1, 3 y 4 |
El orden importa tanto como las capas. Las dos capas de rechazo se ejecutan antes de llamar al modelo de lenguaje, y al prompt, la única capa que depende de la cooperación del modelo, le sigue una comprobación determinista. El control de gasto que hay entre el umbral y el prompt no impide que se invente nada, pero pertenece a la misma familia de fallos.
Capa 1: rechazar antes de recuperar
El primer fallo no es una respuesta que falta. Es una respuesta que no debería existir.
Preguntas que su corpus puede responder, pero que su asistente no debe
En este sitio, una pregunta sobre honorarios recuperaría la página de servicios. El texto es relevante, y responder a partir de él es justo el error: cualquier cifra, fecha o compromiso que el modelo componga a partir de esa página es una declaración que no ha hecho nadie. Que algo sea relevante no significa que esté permitido.
Por eso algunas preguntas se rechazan antes de convertir nada en vectores y antes de recuperar nada:
Condiciones de colaboración: honorarios, disponibilidad y contratación.
Datos privados que el sitio deliberadamente no publica, como un número de teléfono, la dirección del domicilio, el estado civil o militar o la fecha de nacimiento.
Especulación: predicciones y comparaciones con personas concretas.
Peticiones meta que intentan extraer o anular las instrucciones.
Peticiones de tareas: escribir código o textos, traducir o resolver algo, en lugar de preguntar por el trabajo publicado.
El texto del rechazo es fijo, no una salida del modelo: un rechazo que escribe el modelo es un rechazo del que el propio modelo puede desdecirse. Los clientes del modelo de embeddings (el que convierte texto en vectores) y del modelo de lenguaje se construyen de forma perezosa, así que un rechazo en esta capa no hace ninguna llamada externa.
Para su propio sistema, haga la lista de las preguntas cuya respuesta correcta es «esa respuesta no sale de este asistente», contenga lo que contenga el corpus.
Patrones, no un clasificador
El conjunto de rechazo es una lista de expresiones regulares para el inglés y el persa, y de listas de frases para los otros ocho idiomas del sitio, que se ejecutan todas sobre la pregunta ya normalizada para la comparación: en minúsculas, con las formas árabes de las letras convertidas a las persas, los dígitos persas y árabes convertidos a latinos, los signos vocálicos árabes eliminados y el carácter de no unión de ancho cero dentro de las palabras persas convertido en un espacio. La pregunta se prueba también leyendo mi nombre como un pronombre, de modo que «what are Mohammad Panahi’s rates?» se rechaza igual que «what are his rates?», y una pregunta de seguimiento se comprueba junto con la anterior.
No es un clasificador. Un clasificador que acierta la mayor parte de las veces sigue siendo una promesa que este sitio no puede hacer, porque cada uno de sus fallos es un compromiso en nombre de alguien.
El límite es claro: a los patrones se les escapan las paráfrasis. La ortografía persa no es una de esas grietas. Como la normalización convierte el carácter de no unión de ancho cero en un espacio, una palabra que la ortografía estándar escribe unida llega a los patrones partida en dos, y cada patrón persa acepta esa forma y también la que va sin espacio, de modo que چقدر میگیرد y چقدر میگیرد se rechazan las dos. Una pregunta formulada con palabras que la lista no contiene sí pasa, y para eso están las capas siguientes: el prompt prohíbe hablar de honorarios y de disponibilidad, y la compuerta detiene una frase que lleve una palabra en primera persona de las que reconoce o una cifra que no esté en las fuentes. Eso estrecha la grieta. No la cierra. Las listas de los idiomas distintos del inglés y el persa son más cortas, y en ellos las paráfrasis se cuelan más a menudo.
Capa 2: un umbral de similitud que evita la llamada al modelo
Tras la recuperación, el asistente toma la mejor similitud entre la pregunta y los pasajes que entregaría al modelo. Por debajo de un umbral, una pregunta que no trata sobre mí se rechaza con un texto fijo y el modelo de lenguaje no llega a llamarse. El rechazo no sale gratis, porque en producción una API alojada ya ha convertido la pregunta en un vector, pero elimina la llamada de generación, así que una evidencia débil nunca se convierte en una respuesta fluida. Las preguntas sobre mí siguen otro camino, descrito más abajo, porque una puntuación de similitud no distingue una pregunta general sobre el trabajo de alguien de una pregunta fuera de tema.
Por qué no se puede poner un umbral sobre una puntuación RRF
El recuperador es híbrido: búsqueda vectorial densa y búsqueda por palabras clave completas, fusionadas con la fusión recíproca de rangos (reciprocal rank fusion, RRF). Cómo se comporta eso con el persa y el inglés a la vez se explica en búsqueda híbrida para RAG en persa.
RRF es una buena forma de combinar clasificaciones y un mal número para ponerle un umbral. En la formulación de Cormack, Clarke y Büttcher, la puntuación de un documento es la suma de 1/(k + r(d)) sobre las clasificaciones, donde r(d) es su posición en cada lista y k = 60 «se fijó durante una investigación piloto». La puntuación se construye solo a partir de posiciones, así que un corpus de puro ruido sigue produciendo un documento en primera posición con la mejor puntuación fusionada disponible. Un umbral sobre ese número mide posición, no relevancia.
Qué compara el umbral en su lugar
Cada recuperador capaz de producir una similitud acotada informa de una:
La búsqueda vectorial informa de la similitud del coseno, recortada al rango de 0 a 1. El umbral usa la similitud con la pregunta tal como se formuló y, en una pregunta de seguimiento, con la pregunta unida a la anterior. Si la pregunta de seguimiento está formulada como una posición en una lista, como «el segundo», también se le une el elemento al que se refiere: la posición se lee en la pregunta y la lista en la respuesta anterior, por los títulos y nombres del propio sitio o por lo que la respuesta cita entre comillas, y al modelo se le dice de qué elemento se trata. El elemento solo se une cuando la posición y la lista se pueden leer sin lugar a dudas; si no, se le une en su lugar el comienzo de la respuesta anterior. Se comprueba la formulación, no la respuesta: una pregunta de seguimiento sin relación que por casualidad diga «el segundo» también recibe el comienzo de la respuesta y puede superar el umbral; el prompt y la compuerta siguen detrás. Cuando una pregunta trata sobre mí, la recuperación busca además con mi nombre añadido. Eso ayuda a ordenar los pasajes, pero nunca cuenta para el umbral: un nombre hace que cualquier pregunta sobre mí parezca cercana al CV, incluidas las que el sitio no puede responder.
La búsqueda por palabras clave informa de la cobertura: la proporción de palabras con contenido de la pregunta, de tres caracteres o más (dos en chino), encontradas como palabras completas en el pasaje. Antes se eliminan las palabras vacías de cada idioma del sitio, y la cobertura solo cuenta para el umbral cuando coinciden al menos dos palabras con contenido distintas. Una sola coincidencia es casualidad. En una pregunta de seguimiento que solo dice a qué elemento se refiere, como «Cuéntame más sobre el segundo», las palabras con contenido son las del título o el nombre que el propio sitio da a ese elemento.
Cada pasaje se queda con el mayor de los dos valores, y el umbral se compara con el mejor de entre los pasajes devueltos; el pasaje que lo fija siempre está entre ellos. La puntuación fusionada solo decide el orden.
Las palabras completas importan. Si en su lugar se buscan subcadenas, «arte» aparece dentro de «partes», y preguntas sin ninguna relación empiezan a parecer evidencia. Si el servicio de embeddings no está disponible, la recuperación recurre solo a la búsqueda por palabras clave, y el umbral se sigue aplicando.
Preguntas que una puntuación de similitud no puede responder
«¿Qué ha hecho últimamente?» no tiene un vecino más cercano. Su respuesta es una lista ordenada por fecha, y ningún pasaje se parece a eso: con el modelo de embeddings de este sitio, esa pregunta puntuó por debajo de una pregunta sobre el tiempo que hace. Por eso las preguntas sobre el trabajo en su conjunto se reconocen mediante patrones en cada uno de los diez idiomas del sitio, como el conjunto de rechazo. Eso cubre lo que hago ahora o he hecho recientemente, mi trayectoria, proyectos, investigación, escritos, formación, habilidades y servicios. Esas preguntas se responden con los registros del sitio: entradas del CV, los casos de estudio, los artículos y los servicios, leídas de la base de datos para cada pregunta. Los registros llegan en el idioma del lector cuando existe una traducción, y los que tienen fecha se ordenan por sus propias fechas, de la más reciente a la más antigua.
Los registros se eligen por regla, no por similitud, así que el umbral no se les aplica. No están exentos de nada más: los patrones de rechazo se ejecutan primero, cada registro con fecha lleva sus fechas con la precisión que muestra el sitio y cada frase construida sobre uno pasa por la misma compuerta.
Una pregunta sobre mí que los patrones no dirigen a los registros, y que ningún pasaje respalda, recibe un breve resumen de esos registros en lugar de un rechazo, porque un rechazo equivocado ahí le dice al lector que el sitio no cubre algo que sí cubre. Si los registros tampoco la responden, el modelo tiene instrucciones de contestar con un token fijo en lugar de prosa, y el lector ve el mismo rechazo fijo. Así, el juicio del modelo es una vía más hacia el rechazo. Nunca convierte un rechazo en una respuesta.
Cómo elegir el umbral de similitud en RAG
No hay un número que se pueda trasladar de un sistema a otro. La similitud del coseno depende del modelo de embeddings, de la mezcla de idiomas y del corpus, así que un umbral que le va bien a un modelo puede rechazarlo todo, o no rechazar nada, en otro.
El valor predeterminado de diseño en este sitio es 0,35, y el conjunto de pruebas ejecuta con ese valor un modelo de embeddings sustituto, un suplente que se usa únicamente en las pruebas. Todavía no se ha calibrado contra el modelo de embeddings de producción. Un comando que solo ejecuta la recuperación pasa por el modelo de embeddings desplegado las preguntas del conjunto de referencia y las preguntas sugeridas del sitio, sin llamar al modelo, y el umbral de producción solo se cambia si esa ejecución sale bien. No es un valor para copiar. Para elegir el suyo:
Pase por el modelo de embeddings que vaya a desplegar tanto las preguntas que el asistente debe responder como las que debe rechazar, y compare las dos distribuciones de mejor similitud.
Decida cuántas preguntas respondibles está dispuesto a perder para detener las que hay que rechazar. Donde una respuesta incorrecta y segura de sí misma es peor que ninguna respuesta, suba el umbral.
Deje registrado a qué modelo de embeddings y a qué corpus pertenece ese número. Cada página que se añade al corpus cambia lo que una pregunta fuera de tema puede llegar a encontrar, este artículo incluido.
La demo de laboratorio RAG frente a sin RAG está construida alrededor de esa frontera. No tiene ninguna ruta sin fundamentar: una pregunta que no tiene relación conmigo, y que ningún pasaje respalda, se detiene antes de llegar al modelo de lenguaje.
Capa 3: el prompt de sistema es la única capa que el modelo puede ignorar
El prompt sigue haciendo un trabajo real. Le dice al modelo que use solo las fuentes numeradas que se le entregan con la pregunta, que escriba sobre mí en tercera persona y en el idioma del lector, que nunca hable de disponibilidad, honorarios ni plazos, que nunca invente ni calcule una cifra o una fecha, que diga «actualmente» solo de lo que un registro marca como actual, que termine con un marcador de fuente cada frase que enuncia un hecho y que responda con un token fijo cuando las fuentes no cubran la pregunta.
No puede hacer cumplir nada de eso. La entrada LLM07:2025 System Prompt Leakage de OWASP recomienda guardrails fuera del modelo, porque un sistema independiente que inspeccione la salida «es preferible a las instrucciones del prompt de sistema». La guía de Anthropic para reducir las alucinaciones, que incluye dejar que el modelo diga que no lo sabe, es igual de franca: «aunque estas técnicas reducen significativamente las alucinaciones, no las eliminan por completo».
Así que el prompt se escribe dando por supuesto que a veces se ignorará. Su trabajo es hacer que cumplirlo sea el camino más fácil, y cada instrucción de alto riesgo tiene un equivalente determinista:
Instrucción del prompt | Equivalente determinista |
|---|---|
Un marcador de fuente en cada frase que enuncia un hecho | La compuerta comprueba que el marcador está y que está dentro de rango |
No inventar nunca un número | Cada número, URL y correo electrónico debe aparecer en una fuente que la frase cite |
Escribir en tercera persona | La comprobación de primera persona de la compuerta |
Nada de honorarios ni de disponibilidad | Los patrones de la capa 1 y, después, las comprobaciones de valores y de primera persona de la compuerta |
Hay una instrucción que no tiene un equivalente completo: «usa solo lo que dicen las fuentes», para una afirmación que no contiene ningún número. La compuerta puede exigir un marcador válido en esa frase. No puede decidir si la fuente lo dice. Las reglas sobre fechas tampoco lo tienen. Una frase que pone dos hechos fechados en el orden equivocado, o que presenta un puesto antiguo como reciente, no lleva ningún valor que la compuerta pueda comprobar. Los registros reducen ese riesgo porque llegan ordenados por fecha y con las entradas actuales marcadas; no lo eliminan.
Capa 4: una compuerta que revisa el flujo frase a frase
Una frase que el lector ya ha leído no se puede retirar. La documentación de NeMo Guardrails de NVIDIA le pone nombre a la disyuntiva: con stream_first activado, que es lo predeterminado, «si un rail bloquea el contenido, el usuario ya ha recibido los tokens». Este sitio toma la otra opción. El texto se retiene hasta que termina una frase, se comprueba y solo entonces se libera, a costa de aproximadamente una frase de retraso.
Cada frase se enfrenta a cuatro comprobaciones, y cada una es un hecho sobre cadenas de texto, no un juicio sobre el significado:
Marcador dentro de rango: apunta a una de las fuentes que se entregaron.
Marcador presente en toda frase con contenido; una frase corta de transición y sin valores pasa. La longitud se cuenta en palabras separadas por espacios, salvo en chino, que no los usa: allí cada tres caracteres cuentan como dos palabras.
Valores en la evidencia citada: cada número, URL y dirección de correo electrónico aparece en una fuente que la frase cita, con los dígitos persas y árabes convertidos a latinos.
Sin primera persona, que significaría que el asistente ha empezado a hablar como yo.
Ante una infracción, las frases ya liberadas se quedan, la que falla no se envía nunca y el flujo se detiene, lo que además cancela la generación upstream. El lector ve un texto fijo que dice que el resto de la respuesta no podía respaldarse con las fuentes de este sitio y se ha retenido. Los marcadores se comprueban y luego se eliminan, así que el lector ve prosa y no una bibliografía, y una respuesta truncada recibe un aviso distinto: una frase interrumpida no es una frase sin respaldo.
«Respaldado» no es «verdadero». Los valores se comparan con las fuentes que cita la frase, no con la afirmación: una frase que cita dos fuentes puede tomar un valor de cualquiera de ellas, y una frase sin valores pasa con cualquier marcador que esté dentro de rango. La compuerta no puede demostrar que una afirmación sea correcta, ni siquiera que el pasaje citado la sostenga. La entrada LLM09:2025 Misinformation de OWASP pide a los equipos «validar automáticamente las salidas clave»; esto es una versión estrecha y determinista de eso. La mecánica está en guardrails para LLM en streaming.
Capa 5: reglas de voz y representación
Un asistente que habla por alguien asume compromisos en su nombre
En Moffatt v. Air Canada (2024 BCCRT 149), según relatan McCarthy Tétrault y Bristows, el Tribunal de Resolución Civil de la Columbia Británica resolvió el caso del chatbot de una aerolínea que sugirió a un cliente que podía solicitar con efecto retroactivo una tarifa por duelo. La posición de la aerolínea, en palabras del tribunal, daba a entender que «el chatbot es una entidad jurídica independiente que responde de sus propios actos». El tribunal no estuvo de acuerdo: «No hay ninguna diferencia entre que la información venga de una página estática o de un chatbot».
Esto es contexto de ingeniería, no asesoramiento jurídico, y una sola resolución de un tribunal no sienta una regla general. La lección de ingeniería es más acotada: un asistente que está en su sitio habla con la autoridad de su sitio. Unos honorarios o una fecha de inicio escritos en mi voz serían una declaración que yo nunca hice. Una respuesta incorrecta y segura de sí misma es peor que ninguna respuesta; un compromiso incorrecto y seguro de sí mismo, todavía peor.
Tercera persona, textos de rechazo fijos y una comprobación de primera persona
El asistente nunca soy yo. Escribe sobre mí en tercera persona, y cada rechazo y cada aviso son textos fijos. La regla de voz se aplica en tres sitios:
La capa 1 rechaza antes de recuperar las preguntas sobre honorarios, disponibilidad, contratación y datos privados, en cada uno de los idiomas del sitio.
La capa 3 prohíbe la primera persona y cualquier compromiso en mi nombre.
La capa 4 detiene el flujo cuando aparece una palabra en primera persona.
La comprobación es más débil en persa. La lista de primera persona en inglés cubre los pronombres. La lista persa está seleccionada a mano, no es exhaustiva: el persa marca la persona con terminaciones verbales, y una regla lo bastante amplia para capturarlas todas capturaría también palabras corrientes que terminan igual. La lista contiene los pronombres y unos pocos verbos de alto riesgo, como هستم y دارم, cada uno en las dos formas que puede producir la normalización: la comprobación normaliza antes de separar las palabras, así que میکنم le llega como dos tokens y میکنم como uno. Lo que queda sin cubrir es el sufijo, no la ortografía. El persa se apoya más en el prompt, y eso se deja por escrito en lugar de ocultarlo. Para los demás idiomas del sitio, la lista contiene los pronombres y los posesivos de primera persona y, en español, portugués, ruso, árabe e hindi, que suelen decir «yo» solo con el verbo, también algunos verbos en primera persona. En chino, que no separa las palabras con espacios, la comprobación busca 我 en cualquier punto de la frase, salvo en un compuesto de 自我, «auto-», como 自我修正, «autocorrección». En árabe se deja fuera a propósito una palabra de primera persona, porque la normalización de letras que hace comparables las grafías persa y árabe la vuelve idéntica a una preposición frecuente.
Abuso de coste y denial of wallet: la misma familia de fallos
Una alucinación es una salida que nadie autorizó. Una factura sin límite es un gasto que nadie autorizó. OWASP encuadra el segundo caso en LLM10:2025 Unbounded Consumption, que incluye el denial of wallet, donde los atacantes «explotan el modelo de pago por uso de los servicios de IA en la nube, lo que genera cargas financieras insostenibles para el proveedor». Entre sus mitigaciones están los límites al tamaño de la entrada, los límites de peticiones y las cuotas por usuario, los tiempos de espera y la limitación del ritmo, y la degradación elegante.
Un presupuesto antes de la llamada, no una alerta después
Una comprobación posterior a la llamada al modelo llega cuando el dinero ya se ha gastado. En este sitio, una comprobación del gasto mensual se ejecuta después del umbral y antes de la llamada al modelo. Suma el gasto acumulado a una cota superior del coste de este turno: todo el prompt contado a un token por byte UTF-8, más el tope completo de salida, incluida la reserva de razonamiento. Comparar en cambio contra el coste esperado es justo la forma de rebasar un tope.
Si el total fuera a superar el tope, no se llama a ningún modelo y el lector recibe un aviso fijo de que se ha alcanzado el límite mensual, no un error.
El recuento de bytes es un techo, no una estimación generosa. Todos los vocabularios a los que se puede apuntar este endpoint son BPE a nivel de byte, y en un vocabulario de ese tipo un token es una secuencia no vacía de bytes, así que ningún texto puede producir más tokens que bytes tiene, en ningún idioma. La única forma de superar esa cota sería un tokenizador que expandiera el texto antes de dividirlo, y ninguno de ellos lo hace. La cota sustituyó a una regla plana de dos caracteres por token, la regla que este sitio retiró: el impuesto del token en persa midió que esa regla se quedaba por debajo del recuento real en todas y cada una de las frases persas de un corpus paralelo con cl100k_base. El techo es holgado —para el persa reserva varias veces lo que el prompt cuesta de verdad— y es holgado en la única dirección en la que a un tope de gasto le está permitido equivocarse.
Quedan dos límites. La comprobación no es una reserva: el gasto se lee y se compara, no se retiene, así que varias peticiones que llegan a la vez pueden pasar todas y rebasar el tope; los límites por IP estrechan esa ventana sin cerrarla. Y el contador no es un libro de cuentas completo: guarda el coste de las llamadas al modelo de este endpoint, así que el embedding alojado que hay detrás de cada pregunta queda fuera, y una escritura que se pierda mientras el almacén del contador no está disponible no se reintenta nunca. El tope es un guardrail, no una factura.
Fallar cerrado en el gasto, fallar abierto en los límites de peticiones
Si el almacén del contador no está disponible, el gasto es desconocido, y un gasto desconocido frente a un tope duro solo tiene una lectura segura: rechazar como si el tope se hubiera alcanzado.
El limitador de peticiones falla abierto, en cambio, porque una caída de la caché no debería tumbar el sitio. En el peor caso, un límite de peticiones que falla abierto deja pasar algunas peticiones de más; un tope de gasto que falla abierto deja pasar una factura sin límite. Hay tres límites por IP, que se rellenan a lo largo de un minuto, de una hora y de un día, con la clave puesta en la dirección que observó el proxy de borde y no en una cabecera que el cliente pueda escribir. Frenan a los scripts; el tope mensual es el respaldo del gasto, no una garantía.
Dejar de pagar cuando el lector se va
Cerrar la pestaña del navegador no detiene una petición al modelo que ya está en marcha. El servidor comprueba la desconexión dentro del bucle de streaming y cierra el flujo del proveedor, lo que cancela la petición. La parada de la compuerta hace lo mismo: nadie debería pagar por frases que nadie va a ver.
Lo que se generó antes del corte se generó, y sigue en la factura, así que el mes se cobra por ello. Los dos protocolos de proveedor informan del consumo en un evento final al que un flujo cortado a medias nunca llega, así que el servicio se queda con cada carácter que recibió y rellena solo los huecos que dejó el proveedor, a un token por byte UTF-8. Donde el proveedor sí informó, mandan sus cifras: un turno que llega hasta el final registra exactamente lo que el proveedor dijo, no una aproximación.
Cómo medirlo: precisión del rechazo, recall@k y fundamentación
Importan tres propiedades. La precisión del rechazo mide si el asistente rechaza lo que debe. El recall@k mide si la evidencia llega al modelo. La fundamentación (groundedness) mide si la respuesta se mantiene dentro de esa evidencia. En este sitio, un conjunto de referencia (golden set) de preguntas en los diez idiomas del sitio, la mayoría en inglés y persa, se puntúa de forma determinista en cada ejecución de CI, sin ninguna llamada al modelo.
Precisión del rechazo: dos conjuntos, sin nota parcial
El rechazo se puntúa sobre dos conjuntos, porque las dos capas de rechazo fallan de forma distinta. La capa 1 tiene que capturar los rechazos por patrón antes de que se ejecute la recuperación; las preguntas sin evidencia, que no tienen nada que ver con el sitio, tienen que quedar por debajo del umbral y no pueden reconocerse como preguntas sobre mí. Un tercer conjunto comprueba que las preguntas sobre el trabajo en su conjunto llegan a los registros del sitio.
Los dos conjuntos tienen que salir perfectos para que la build pase. Un solo rechazo que se escapa es un compromiso inventado en el sitio de una persona real, y una media lo escondería. La misma ejecución comprueba el fallo contrario: preguntas respondibles rechazadas por los patrones o por el umbral. Las preguntas frecuentes sobre evaluación de Hamel Husain y Shreya Shankar prefieren el aprobado o el suspenso a las escalas de valoración porque «las evaluaciones binarias obligan a pensar con más claridad y a etiquetar de forma más consistente».
Aquí no cito las preguntas que deben rechazarse: este artículo entrará en el corpus del asistente, y citarlas les daría a esas preguntas exactas una fuerte coincidencia de palabras clave en esta misma página.
Recall@k con una k menor que la predeterminada
En el conjunto de referencia, el recall@k pregunta si al menos un pasaje que responde a la pregunta está entre los k primeros, lo que lo convierte en una tasa de acierto. El artículo de Anthropic sobre Contextual Retrieval usa la proporción, más estricta, de documentos relevantes recuperados, e informa de «1 menos recall@20» como medida de fallo.
El conjunto de referencia mide el recall con k = 5, por debajo del top-k predeterminado de 8, porque en un corpus de prueba de unas pocas decenas de fragmentos los ocho primeros son una parte grande de todo lo que hay, y medir ahí favorecería al recuperador.
Fundamentación: se aplica por frase, no se puntúa en diferido
En diferido, la fundamentación suele puntuarse como faithfulness. Ragas la define como las afirmaciones de una respuesta que el contexto recuperado respalda, divididas entre todas sus afirmaciones, de 0 a 1; en su forma estándar, un LLM identifica las afirmaciones y las comprueba.
Los jueces LLM son útiles y sesgados. Zheng y sus colegas encontraron «sesgos de posición, de verbosidad y de autoensalzamiento», mientras que los jueces fuertes seguían alcanzando más del 80 % de acuerdo con las preferencias humanas. Husain y Shankar aconsejan validar las tasas de verdaderos positivos y de verdaderos negativos de un juez sobre un conjunto etiquetado reservado, y empezar por comprobaciones baratas basadas en código siempre que una regla pueda decidir.
Este sitio toma la vía del código: la compuerta aplica la fundamentación en tiempo de ejecución, y en CI no se ejecuta ninguna métrica de faithfulness ni ningún juez LLM.
Lo que mi conjunto de referencia no demuestra
El modelo de embeddings es un sustituto. La recuperación en CI usa un modelo de hashing de bolsa de tokens sin ningún significado aprendido. El enrutamiento, la fusión, la clasificación, la selección top-k y la decisión sobre la evidencia, comparación con el umbral incluida, son el código de producción; solo la puntuación de los candidatos, que en producción se hace en la base de datos, está replicada en la prueba. Así que CI detecta regresiones en la maquinaria de enrutamiento y clasificación, no en la consulta a la base de datos ni en el recall del asistente en funcionamiento, y el sustituto incluso pone a prueba una lista dispersa que producción no usa.
Los conjuntos son pequeños. Hay veintiún rechazos por patrón y once preguntas sin evidencia. «Debe ser perfecto» sobre once preguntas es una protección contra regresiones, no una tasa de rechazo.
Las comprobaciones en vivo son comandos, no tareas de CI. La prueba que enviaría el conjunto de referencia al recuperador desplegado se sigue saltando. Un comando que solo ejecuta la recuperación pasa por el modelo de embeddings desplegado las preguntas de referencia y las preguntas sugeridas, sin llamar al modelo, y un script que se lanza a mano después de cada importación hace al asistente en vivo las preguntas que deben rechazarse.
Las respuestas a partir de registros solo las comprueba la compuerta. CI comprueba, contra un fixture, qué preguntas llegan a los registros del sitio y qué registros reciben, con un sustituto del modelo que sigue un guion. Cómo redacta un modelo real una respuesta a partir de ellos se comprueba en tiempo de ejecución, con la compuerta.
Por eso no publico ninguna cifra de precisión, de rechazo ni de recall del asistente: la ejecución automatizada usa un modelo de embeddings sustituto, las comprobaciones en vivo son pequeñas y se lanzan a mano, y este sitio no estima números que no ha medido.
Estructura en lugar de confianza en un asistente de contratos
Trabajé como ingeniero de IA en Kartez Contract, un espacio de trabajo trilingüe para contratos que el cliente detuvo a un mes de terminarlo por problemas de financiación derivados de la guerra. Allí, mantener el modelo anclado se resolvió con estructura y no con confianza: las respuestas se apoyan solo en las cláusulas seleccionadas, las correcciones tienen que citar literalmente el texto existente, las salidas siguen esquemas fijos y el modelo se ejecuta con poca aleatoriedad al redactar. Son restricciones de diseño, no una garantía medida. El umbral y la compuerta de este artículo pertenecen al asistente de este sitio, no a Kartez. El caso de estudio de Kartez Contract cubre el proyecto. Qué aspecto tienen esos patrones en la IA para contratos, y por qué el conjunto de evaluación va primero, está en las alucinaciones de la IA jurídica: qué construir.
Checklist: guardrails para un asistente RAG en producción
Rechace primero por patrón. Rechace antes de recuperar las preguntas sobre honorarios, disponibilidad, datos privados y extracción de instrucciones.
Ponga el umbral sobre una similitud, no sobre una puntuación de rango. El coseno puede sostener un umbral, y también la cobertura de palabras completas, una vez eliminadas las palabras vacías y siempre que coincidan al menos dos palabras con contenido; una puntuación RRF, no. Por debajo del umbral, rechace con texto fijo y sáltese el modelo.
Responda a las preguntas de visión general con registros, no con similitud. Una lista ordenada por fecha no tiene vecino más cercano.
Calibre el umbral con el modelo de embeddings que despliega. Un umbral comprobado sobre un sustituto es un valor predeterminado.
Refleje cada regla del prompt con una comprobación fuera del modelo.
Revise el flujo con una compuerta por frases. Exija un marcador, compruebe los números, las URL y los correos electrónicos de forma literal, retenga todo desde la frase que falla en adelante y dele al truncamiento su propio aviso.
Prohíba la primera persona en los asistentes que hablan de una persona o de una empresa, y documente dónde la comprobación es más débil.
Reserve una cota superior antes de la llamada, no una estimación generosa. Para un BPE a nivel de byte, el recuento de bytes UTF-8 del prompt es una. Haga la reserva atómica para que varias peticiones simultáneas no puedan pasar todas, falle cerrado y cancele el trabajo upstream cuando el cliente se desconecte.
Registre un coste para cada llamada, también para las que se cortan a medias: conserve el texto según llega en streaming y rellene solo lo que el evento final de consumo del proveedor nunca notificó.
Mida el rechazo por separado del recall. Indique el modelo de embeddings, el tamaño de los conjuntos y lo que la ejecución no demuestra.
Preguntas frecuentes
¿RAG elimina las alucinaciones?
No. Las herramientas de investigación jurídica basadas en RAG de LexisNexis y Thomson Reuters seguían alucinando entre el 17 % y el 33 % de las veces en un estudio prerregistrado, y un contexto insuficiente puede volver a un modelo más seguro en lugar de más prudente. La recuperación mejora las probabilidades; las garantías vienen de comprobaciones fuera del modelo.
¿Qué umbral de similitud debería usar un sistema RAG?
No hay un número que se pueda trasladar de un sistema a otro, porque las distribuciones de similitud dependen del modelo de embeddings y del corpus. Ponga el umbral sobre una similitud acotada, como el coseno, nunca sobre una puntuación de fusión recíproca de rangos, y fije el valor a partir de preguntas respondibles y preguntas que deben rechazarse, ejecutadas con el modelo de embeddings que va a desplegar. Un umbral comprobado solo sobre un sustituto es un valor predeterminado, no una calibración.
¿Basta con el prompt de sistema para evitar las alucinaciones?
No. OWASP recomienda evitar «usar prompts de sistema para controlar el comportamiento del modelo siempre que sea posible» y apoyarse en «sistemas fuera del LLM», y la guía de Anthropic dice que las técnicas de prompting reducen las alucinaciones sin eliminarlas. Conserve el prompt y dele a cada instrucción que importa una comprobación determinista fuera del modelo.
¿Puede un juez LLM sustituir a las comprobaciones deterministas?
No para las reglas que puede decidir una comprobación de cadenas, como si un marcador apunta a una fuente real o si un número aparece en la evidencia. Los jueces muestran sesgos de posición, de verbosidad y de autoensalzamiento. Úselos para las preguntas que el código no puede responder, con etiquetas binarias y un juez validado contra etiquetas humanas.
¿Cómo se evita que un chatbot LLM dispare la factura?
Antes de la llamada al modelo, reserve de forma atómica una cota superior de su coste —para un tokenizador BPE a nivel de byte, el recuento de bytes UTF-8 del prompt es una, en cualquier idioma— y rechace si el contador no está disponible. Registre un coste para cada llamada, también para las que se cortan a medias, conservando el texto según llega en streaming y rellenando lo que el evento final de consumo del proveedor nunca notificó. Degrade a un texto fijo en lugar de dar un error, y cancele la generación upstream cuando el cliente se desconecte. OWASP recoge este riesgo como LLM10:2025 Unbounded Consumption, que incluye el denial of wallet.
Fuentes
Magesh y otros (2024): Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools
Blog de Google Research (14 de mayo de 2025): Deeper insights into retrieval augmented generation: The role of sufficient context
Joren y otros (arXiv 2024, revisado en 2025): Sufficient Context: A New Lens on Retrieval Augmented Generation Systems
Kalai y otros (2025): Why Language Models Hallucinate
Cormack, Clarke y Büttcher, SIGIR 2009: Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods
OWASP Gen AI Security Project: LLM07:2025 System Prompt Leakage
Documentación de Anthropic: Reduce hallucinations
NVIDIA NeMo Guardrails: Output Rail Streaming Configuration
OWASP Gen AI Security Project: LLM09:2025 Misinformation
Blog TechLex de McCarthy Tétrault (19 de febrero de 2024): Moffatt v. Air Canada: A Misrepresentation by an AI Chatbot
Blog Inquisitive Minds de Bristows (27 de marzo de 2024): AI Chatbot flies solo and Air Canada foots the bill - Moffatt v. Air Canada
OWASP Gen AI Security Project: LLM10:2025 Unbounded Consumption
Hamel Husain y Shreya Shankar (última modificación: 13 de septiembre de 2026): AI Evals: Everything You Need to Know
Anthropic (19 de septiembre de 2024): Introducing Contextual Retrieval
Documentación de Ragas: Faithfulness
Zheng y otros, NeurIPS 2023 Datasets and Benchmarks: Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena
Si está diseñando un asistente que tiene que rechazar con la misma fiabilidad con la que responde, defina el alcance de su proyecto.