
El impuesto de tokens del persa: qué cuesta un LLM fuera del inglés
El persa necesitó 1,53× los tokens del inglés con el tokenizador de GPT-4o y 3,26× con el de GPT-4, en 1012 frases paralelas. Método, resultados y qué probar.
El texto en persa (farsi) cuesta más tokens que el inglés para decir lo mismo. Ese sobrecoste es el impuesto de tokens del persa, y su tamaño depende más del tokenizador que del alfabeto. Conté los tokens de las mismas 1012 frases, en inglés y en persa, del benchmark FLORES-200. El persa necesitó 1,53× el recuento del inglés con o200k_base, la codificación que la biblioteca tiktoken de OpenAI asigna a GPT-4o, y 3,26× con cl100k_base, la que asigna a GPT-4. Esos dos fueron los extremos entre los cuatro tokenizadores que usan los modelos de generación de texto; bge-m3, el tokenizador de un modelo de embedding, se quedó en 1,10×. Claude y Gemini no están en esta medición: Anthropic no publica el tokenizador de Claude y no probé el tokenizador local que el SDK de Google ofrece para Gemini. Ambos proveedores cuentan los tokens de sus propios modelos a través de una API.
Estas cifras son una instantánea con fecha: se midieron el 17 de septiembre de 2026 con versiones fijadas de los tokenizadores.
Por qué el persa (farsi) consume más tokens: bytes, merges y datos de entrenamiento
Las API de modelos de lenguaje facturan por token. En 2023, Ahia y sus colegas encontraron indicios de que «a los hablantes de un gran número de los idiomas admitidos se les cobra de más mientras obtienen peores resultados». Petrov y sus colegas mostraron que el mismo texto traducido a distintos idiomas puede diferir en longitud de tokenización «hasta 15 veces en algunos casos». Un estudio de 2025 sobre más de doscientos idiomas informa de «ratios de RTC a menudo de 3 a 5 veces mayores» en los idiomas de alfabeto no latino y morfología compleja, donde RTC es el «Relative Tokenization Cost» de los autores.
Eso es el impuesto de tokens: el mismo significado, una factura mayor.
Los bytes son el punto de partida de todo tokenizador a nivel de byte
Un tokenizador BPE a nivel de byte (byte-pair encoding), el tipo que hay detrás de GPT-4o, Qwen3 y DeepSeek-V3, parte de los bytes de la codificación UTF-8 del texto y fusiona las secuencias de bytes frecuentes en tokens. Una letra latina sin acento ocupa un byte; las letras del yoruba con marca tonal o punto suscrito ocupan dos o más. Una letra persa ocupa dos, y el no unificador de ancho cero que aparece dentro de las palabras persas ocupa tres. En FLORES, el archivo persa ocupó 1,69× los bytes del archivo inglés en UTF-8, con 0,94× sus caracteres. El persa no es más largo en caracteres: es más pesado de codificar.
Lo que ocurre después depende de los merges que el tokenizador aprendió de sus datos de entrenamiento. Pasar de cl100k_base a o200k_base redujo los tokens del persa un 53,5 % y los del inglés un 1,1 %. El vocabulario más nuevo cambió el persa, no el inglés.
El yoruba se escribe en alfabeto latino y paga más
Si el alfabeto decidiera el impuesto, los idiomas de alfabeto latino apenas lo pagarían. Un artículo de Roy, Roy y Patel (aceptado en un taller de IJCAI 2026, en arXiv desde agosto de 2026) constata que «el yoruba, pese a usar el alfabeto latino, presenta el mayor sobrecoste de tokenización en GPT-4o» de su auditoría, con 2,37×. Los autores apuntan a los diacríticos y a la cobertura del vocabulario. En ese artículo el yoruba es una comparación exploratoria: sus traducciones se generaron por máquina y se revisaron a mano, mientras que el bengalí y el hindi son los casos validados.
Mi medición apunta en la misma dirección. El yoruba costó más que el persa en cuatro de los cinco tokenizadores, y el árabe costó menos que el persa en cuatro de los cinco. La excepción árabe es bge-m3, un modelo de embedding construido sobre XLM-RoBERTa y su vocabulario. XLM-R se entrenó con cien idiomas tomados de CC-100: 13.259 millones de tokens en persa frente a 2869 millones en árabe, y el yoruba no estaba entre ellos. Eso es coherente con que pese más la proporción de datos de entrenamiento que el alfabeto. No lo demuestra.
Resultados: persa, árabe y yoruba frente al inglés
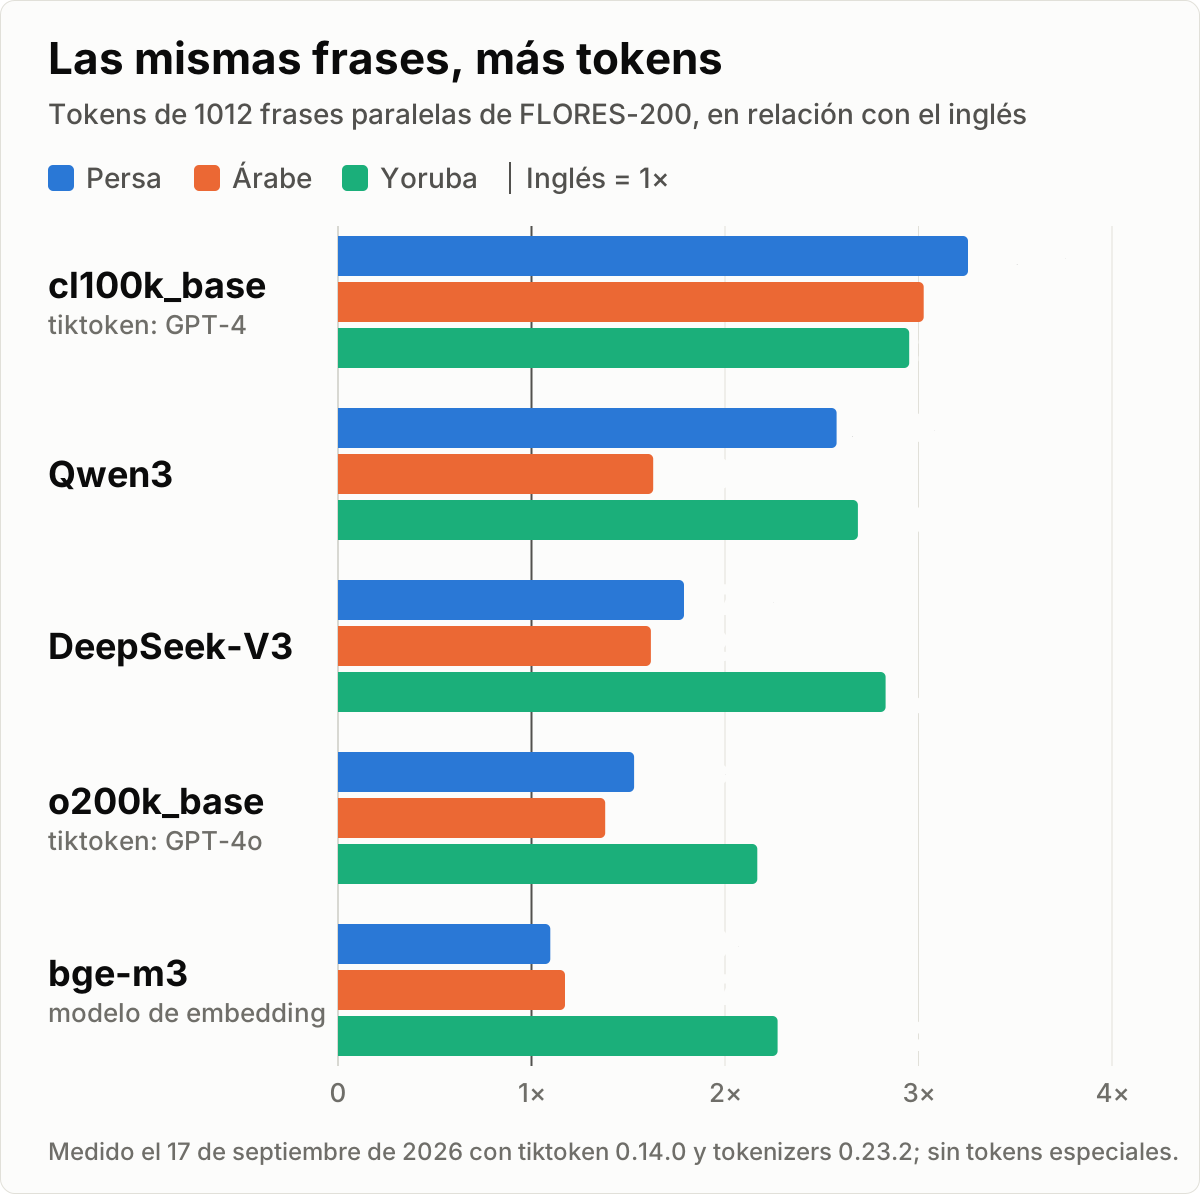
Cada celda es el total de tokens de un idioma dividido entre el total del inglés con el mismo tokenizador:
Tokenizador | Persa (× inglés) | Árabe (× inglés) | Yoruba (× inglés) |
|---|---|---|---|
| 3,26× | 3,03× | 2,95× |
Qwen3 | 2,58× | 1,63× | 2,69× |
DeepSeek-V3 | 1,79× | 1,62× | 2,83× |
| 1,53× | 1,38× | 2,17× |
bge-m3 | 1,10× | 1,17× | 2,27× |
El tokenizador es la variable que más pesa. La ratio del persa con el peor tokenizador (3,26×) es unas tres veces la que obtiene con el mejor (1,10×), y aun entre los cuatro tokenizadores de generación es del orden del doble (3,26× frente a 1,53×). Qwen3 trata el árabe mucho mejor que el persa, 1,63× frente a 2,58×, así que una sola cifra para el alfabeto árabe no sirve para los dos idiomas. El resultado de cl100k_base concuerda con recuentos publicados antes: las longitudes de tokenización de Petrov y sus colegas sobre FLORES-200, con los splits dev y devtest unidos, sitúan el persa occidental en 3,28 veces el inglés, frente a mis 3,26× solo sobre el split devtest.
Los totales de los que salen esas ratios, con el tamaño del archivo de cada idioma antes de que lo tocara ningún tokenizador:
Recuento | Inglés | Persa | Árabe | Yoruba |
|---|---|---|---|---|
Caracteres | 131.966 | 123.830 | 116.320 | 126.848 |
Bytes (UTF-8) | 132.096 | 223.504 | 211.276 | 168.857 |
Tokens, | 27.182 | 88.513 | 82.288 | 80.247 |
Tokens, Qwen3 | 27.621 | 71.183 | 44.991 | 74.226 |
Tokens, DeepSeek-V3 | 27.041 | 48.342 | 43.713 | 76.526 |
Tokens, | 26.873 | 41.116 | 37.117 | 58.238 |
Tokens, bge-m3 | 30.661 | 33.631 | 35.979 | 69.672 |
Su corpus dará otra cifra
La auditoría de Roy y sus colegas midió o200k_base sobre 120 ítems de depuración de Python traducidos del inglés, promediando por ítem. Informa de 1,44× para el árabe y 2,37× para el yoruba, ambos a partir de traducciones automáticas. Sobre la prosa de FLORES, que tradujeron personas, o200k_base dio 1,38× para el árabe y 2,17× para el yoruba. El mismo tokenizador, otro texto y otro proceso de traducción, otro resultado. Cuente sus propios prompts, sus pasajes recuperados y sus respuestas antes de hacer el presupuesto.
Cómo medí el recuento de tokens del persa
Un corpus realmente paralelo
El equipo de NLLB describe FLORES-200 como «un benchmark traducido por personas»: las mismas frases, en el mismo orden, en todos los idiomas. Usé su split devtest, con licencia CC BY-SA 4.0, del archivo oficial y con su hash SHA-256 comprobado: 1012 frases de Wikinews, Wikivoyage y Wikibooks, en inglés, persa occidental, árabe estándar moderno y yoruba.
Que sea paralelo importa más que el tamaño. Una traducción adaptada, como un CV bilingüe, añade, quita y reformula contenido, así que su ratio mide tanto la edición como el tokenizador. FLORES tiene su propio límite: es prosa de noticias, de guías de viaje y de libros de texto, no chat, ni código, ni contratos.
Tokenizadores abiertos, revisiones fijadas y por qué faltan Claude y Gemini
Cinco tokenizadores, todos descargables sin cuenta:
tiktoken 0.14.0:
cl100k_baseyo200k_base. tiktoken asigna GPT-4 y GPT-3.5 Turbo al primero, y GPT-4o, o1, o3, GPT-4.1 y GPT-5 al segundo.Qwen3 (
Qwen/Qwen3-8B) y DeepSeek-V3 (deepseek-ai/DeepSeek-V3), los dos BPE a nivel de byte, cargados con tokenizers 0.23.2 de Hugging Face en revisiones fijadas del Hub.bge-m3 (
BAAI/bge-m3), un modelo de embedding cuyo tokenizador es un modelo Unigram de SentencePiece con el vocabulario de XLM-R, no un BPE a nivel de byte. Unigram es otro algoritmo: elige la segmentación más probable del texto dentro de un vocabulario fijo. Importa para la recuperación, no para la generación.
Cada frase se codificó por separado, sin tokens especiales, y los recuentos se sumaron. Las medianas por frase cuentan lo mismo que los totales. El núcleo cabe en unas pocas líneas:
# after: tar -xzf flores200_dataset.tar.gz
import tiktoken
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer


def sentences(lang):
    with open(f"flores200_dataset/devtest/{lang}.devtest", encoding="utf-8") as f:
        return f.read().rstrip("\n").split("\n")


english, persian = sentences("eng_Latn"), sentences("pes_Arab")

o200k = tiktoken.get_encoding("o200k_base")
qwen3 = Tokenizer.from_file(
    hf_hub_download(
        "Qwen/Qwen3-8B",
        "tokenizer.json",
        revision="b968826d9c46dd6066d109eabc6255188de91218",
    )
)


def o200k_tokens(texts):
    return sum(len(o200k.encode_ordinary(t)) for t in texts)


def qwen3_tokens(texts):
    return sum(len(qwen3.encode(t, add_special_tokens=False).ids) for t in texts)


print(round(o200k_tokens(persian) / o200k_tokens(english), 2))
print(round(qwen3_tokens(persian) / qwen3_tokens(english), 2))
El registro de la medición, suficiente para repetir la ejecución exactamente:
corpus: https://dl.fbaipublicfiles.com/nllb/flores200_dataset.tar.gz
sha256: b8b0b76783024b85797e5cc75064eb83fc5288b41e9654dabc7be6ae944011f6
split: devtest
measured: 2026-09-17
libraries:
  tiktoken: 0.14.0
  tokenizers: 0.23.2
  huggingface_hub: 1.31.0
encodings: [cl100k_base, o200k_base]
hub_revisions:
  Qwen/Qwen3-8B: b968826d9c46dd6066d109eabc6255188de91218
  deepseek-ai/DeepSeek-V3: e815299b0bcbac849fa540c768ef21845365c9eb
  BAAI/bge-m3: 5617a9f61b028005a4858fdac845db406aefb181
method: each sentence encoded on its own, no special tokens, counts summed per language
Claude y Gemini faltan a propósito. Anthropic no publica el tokenizador de Claude, así que cualquier ratio que yo diera para Claude sería una conjetura con decimales. El SDK de Gen AI de Google para Python incluye un tokenizador local experimental, solo de texto, que asigna algunos modelos de Gemini a tokenizadores abiertos de Gemma; no lo medí. Ambos proveedores cuentan los tokens por usted. El endpoint count_tokens de Anthropic es gratuito pero tiene límite de tasa, y su documentación llama al resultado «una estimación»; el count_tokens de Gemini cuenta la entrada. Claude 4.7 y los modelos posteriores usan un tokenizador más nuevo con el que el mismo texto de entrada produce «aproximadamente un 30 por ciento más de tokens que en los modelos anteriores». Un recuento de tokens pertenece a un modelo, no a un proveedor.
Cotas que se cumplen y una que no
En los tokenizadores BPE a nivel de byte que dividen el texto en pretokens antes de fusionar, como hacen los cuatro de aquí, dos límites acotan el recuento. Los tokens no pueden superar en número a los bytes del texto en UTF-8, tal como el tokenizador lo normaliza, porque cada token cubre al menos un byte. Tampoco pueden ser menos que los propios pretokens del tokenizador, los trozos en que su patrón de división corta el texto, porque las fusiones nunca cruzan una frontera entre pretokens. Comprobé ambas cotas frase a frase en los cuatro tokenizadores BPE a nivel de byte y en los cuatro idiomas: 16.192 comprobaciones, 0 incumplimientos.
El banco de pruebas del tokenizador de este sitio muestra las dos cifras para cualquier texto que escriba, calculadas en el navegador: la división en pretokens de cl100k_base y los bytes del texto en UTF-8. Para cl100k_base, el recuento real está entre las dos, que es lo que dice el pie de cada panel.
La cota inferior pertenece a un tokenizador concreto. La división de cl100k_base no es un suelo para o200k_base: en 28 frases en inglés, o200k_base necesitó menos tokens que los pretokens que produce cl100k_base. Ninguna de las dos cotas se aplica al modelo Unigram de bge-m3.
Cómo afecta el impuesto de tokens al precio, la latencia, el contexto y los límites de tasa
Precio
Los proveedores de API cobran por los tokens que un modelo procesa y genera. Al mismo precio por token, el mismo contenido en persa cuesta alrededor de una vez y media lo que cuesta en inglés con o200k_base, y más del triple con cl100k_base. Cuando el prompt y la respuesta están los dos en persa, el sobrecoste se aplica a las dos mitades de la factura.
Latencia
El ritmo lo marcan los tokens de salida. La guía de latencia de OpenAI dice que «recortar el 50 % de los tokens de salida puede recortar la latencia en ~50 %». Acortar el prompt importa mucho menos: «recortar el 50 % del prompt quizá solo suponga una mejora de latencia del 1–5 %». Una respuesta en persa que necesita más tokens que su equivalente en inglés tarda más en emitirse por streaming. Eso es una recomendación del proveedor aplicada a las ratios de arriba, no una medición de latencia mía.
Ventana de contexto
Una ventana de tokens fija admite menos persa. Dividiendo por la ratio, la misma ventana admite en persa un 31 % del contenido que admite en inglés con cl100k_base, un 39 % con Qwen3, un 56 % con DeepSeek-V3, un 65 % con o200k_base y un 91 % con bge-m3, para este corpus. La auditoría de Roy y sus colegas señala lo mismo para el bengalí, cuyo sobrecoste de 1,56× en GPT-4o reduce «una ventana de contexto nominal de 128k tokens a una capacidad efectiva equivalente a 82k tokens en inglés». En un prompt de RAG, eso significa espacio para menos pasajes recuperados.
Límites de tasa
Los límites de tasa también se cuentan en tokens. Los límites de la API de Claude se «miden en peticiones por minuto (RPM), tokens de entrada por minuto (ITPM) y tokens de salida por minuto (OTPM)». Bajo un techo de tokens por minuto, una carga que necesita más tokens por petición, como le ocurrió al persa con todos los tokenizadores medidos aquí, llega al límite tras menos peticiones. En la mayoría de los modelos de Claude, las lecturas de caché no cuentan para el límite de entrada.
Normalización que ahorra tokens y normalización que rompe el recall
Dos rasgos del persa escrito parecen un ahorro fácil de tokens. Los dos son trampas.
El ZWNJ (نیمفاصله) es un carácter, no un espacio
U+200C ZERO WIDTH NON-JOINER tiene la categoría general Cf de Unicode: es un control de formato, no un espacio en blanco. Impide que las letras de uno y otro lado se enlacen, de modo que میشود se lee como una sola palabra con un corte visible. El archivo persa de FLORES lo usa 1739 veces, en 735 de sus 1012 frases.
Sustituir cada ZWNJ por un espacio cambió los recuentos de tokens del persa en -1,59 % con cl100k_base, -1,82 % con o200k_base, -1,57 % con Qwen3, -8,08 % con DeepSeek-V3 y +0,00 % con bge-m3. bge-m3 no se movió porque su normalizador ya convierte el ZWNJ en un espacio: las 735 frases modificadas conservaron ids de token idénticos.
El ahorro es pequeño en tres tokenizadores, mayor en DeepSeek-V3, y altera el texto: una palabra se convierte en dos, y lo que usted almacena, muestra o cita deja de ser lo que escribió quien lo redactó. Conserve el ZWNJ en el texto almacenado y decida aparte qué considera iguales el comparador. Este sitio hace justo eso: solo la normalización que se aplica dentro de las comparaciones trata el ZWNJ como un espacio.
Yeh y kaf árabes frente a yeh y keheh persas
ARABIC LETTER YEH (U+064A) y ARABIC LETTER FARSI YEH (U+06CC) son caracteres distintos, igual que ARABIC LETTER KAF (U+0643) y ARABIC LETTER KEHEH (U+06A9). Al principio o en medio de una palabra se ven iguales; al final de la palabra se diferencian. Una comparación de cadenas ve siempre dos caracteres distintos. Incluso FLORES los mezcla: su archivo persa tiene 11 yeh árabes y 22 kaf árabes junto a 9570 yeh persas y 2957 keheh.
Reescribir cada yeh persa y cada keheh del archivo persa como yeh y kaf árabes cambió los recuentos de tokens en +2,20 % con cl100k_base, +9,49 % con o200k_base, -7,48 % con Qwen3, +10,39 % con DeepSeek-V3 y +11,95 % con bge-m3. Una reescritura que ahorra tokens en un tokenizador cuesta tokens en los otros cuatro.
El problema de verdad es el recall. Si el texto almacenado y las consultas usan puntos de código distintos, la coincidencia exacta y la léxica fallan en silencio. Este sitio normaliza el texto persa al escribirlo: el yeh y el kaf árabes pasan a sus formas persas, y el ZWNJ se mantiene. Normaliza la consulta de búsqueda de la misma manera. Sin eso, una consulta escrita con yeh árabe busca un carácter que el índice no contiene, y no devuelve nada.
La regla general es más restringida: normalice solo el texto persa, porque en árabe el yeh y el kaf árabes son las letras correctas. El recuperador de este sitio todavía no hace esa distinción: aplica la normalización persa al contenido y a las preguntas en todos los idiomas, árabe incluido. El artículo sobre búsqueda híbrida para RAG en persa explica ese hueco y cubre el resto del lado de la recuperación.
Los dígitos persas
Escribir los dígitos ASCII como dígitos persas cambió los recuentos de tokens entre +0,48 % y +1,47 %. Eso no es razón para cambiar lo que ven los lectores.
Cómo reducir el coste en tokens del persa: probar, no suponer
Pruebe cada uno de estos puntos con su propio tráfico antes de confiar en él.
Elija el modelo con su propio texto. Sobre frases idénticas, la ratio del persa respecto al inglés fue de 1,10× a 3,26×.
Cuente con el endpoint del proveedor. Para Claude y Gemini, las ratios medidas aquí no le dicen nada.
Vuelva a contar cuando cambie el modelo. Un tokenizador más nuevo puede mover todos los presupuestos que haya fijado.
Dimensione los chunks y los presupuestos de contexto en tokens, por idioma. Un límite de caracteres ajustado sobre el inglés contiene más tokens en persa: desde alrededor de un sexto más con bge-m3 hasta unas tres veces y media más con
cl100k_base.Limite la longitud de la salida. Los tokens de salida marcan la latencia y el coste. Anthropic sugiere pedir un número de frases o de párrafos en lugar de un número de palabras.
Cachee el contexto que se repite y mida después la tasa de aciertos. Cualquier ahorro depende de con qué frecuencia se repita de verdad su prefijo.
Trate un prompt de sistema en inglés como una hipótesis. Consume menos tokens, pero no tengo ninguna medición de lo que le hace a las respuestas en persa.
No elimine el ZWNJ ni cambie las formas de las letras para ahorrar tokens. El ahorro es pequeño o inconsistente; el daño al texto y a la coincidencia no lo es.
Cómo presupuestar los tokens del persa
Una regla de caracteres por token es una conjetura por tokenizador
El persa fue de 1,40 caracteres por token con cl100k_base a 3,68 con bge-m3, con o200k_base en 3,01. El inglés fue de 4,30 a 4,91. La documentación de Gemini de Google dice que «un token equivale a unos 4 caracteres» y lo acompaña de un recuento de palabras inglesas: una regla con forma de inglés, no una afirmación sobre el persa.
Reservar un token por cada dos caracteres persas suena generoso. Este sitio lo hacía, y por eso lo probé sobre estas frases: se quedó por debajo del recuento real en las 1012 frases persas con cl100k_base y en 976 con Qwen3. Aguantó con o200k_base y bge-m3, y se quedó corto en 6 frases con DeepSeek-V3. Una regla que es segura en un tokenizador puede ser optimista en el siguiente, así que este sitio ya no aplica ninguna.
Un techo duro: el recuento de bytes
En el BPE a nivel de byte, el número de bytes del texto tal como lo normaliza el tokenizador es un techo duro, pero holgado. En una escala que va de 0 en el recuento de pretokens a 1 en el de bytes, el inglés se situó entre 0,015 y 0,017: casi todo pretoken inglés, más o menos una palabra, es un único token. El persa se situó en 0,07 con o200k_base y en 0,31 con cl100k_base: partido en trozos, pero ni de lejos en bytes. Reservar bytes, por tanto, reserva muy por encima. Es el compromiso acertado para un tope que nadie puede rebasar, y el equivocado para una previsión. Para Claude y Gemini, cuente con sus endpoints antes de la llamada y registre el uso que reporten después.
Reservar antes de la llamada, registrar después
El asistente de este sitio separa esas dos tareas. Antes de llamar al modelo de lenguaje, suma una estimación de la petición (una cota superior de los tokens del prompt, más el tope completo de salida) al gasto registrado del mes y compara el total con un límite mensual. Si no puede leerse el contador de gasto, falla en cerrado. En el límite, el modelo no se llama y el lector recibe un aviso en lugar de un error. Después de la llamada registra el uso que reporta el proveedor. La estimación solo decide si una petición puede empezar; el acumulado sale de los recuentos de tokens del proveedor.
Las dos mitades tienen límites, en direcciones opuestas. La estimación previa cuenta el prompt como su longitud en bytes UTF-8: el techo de la sección anterior, no una previsión. Todos los vocabularios que el asistente puede llegar a usar son BPE a nivel de byte, así que ese techo se cumple sea cual sea el modelo con el que esté hablando y el idioma en el que escriba el visitante. Para el persa eso reserva varias veces lo que el prompt costará en realidad, retenido durante una petición y nunca registrado como gasto. Antes contaba el prompt con la regla plana de dos caracteres por token probada más arriba, que se quedó por debajo del recuento real en las 1012 frases persas con cl100k_base. Una reserva demasiado pequeña es un tope equivocado en la única dirección en la que un tope nunca debe equivocarse, y por eso esta medición lo cambió: el docstring del estimador cita esta misma ejecución de 1012 frases. El total mensual, en cualquier caso, se construye con el uso registrado, no con la estimación.
El registro tiene que lidiar con un silencio. OpenAI y Anthropic informan de los tokens de salida después del texto generado, y la referencia de streaming de OpenAI advierte de que, si un stream se interrumpe o se cancela, «puede que no reciba el fragmento final de uso». Un stream cortado antes de tiempo, por un guardrail de streaming o por una pestaña cerrada, termina antes de que llegue ese informe, y cada carácter que llegó a producir está en la factura. Por eso el asistente guarda el texto a medida que se transmite y, allí donde el proveedor no informó de nada, rellena el hueco con el mismo recuento de bytes, que registra de más y no de menos. Las cifras del proveedor prevalecen siempre que haya dado alguna: un turno que se completa registra exactamente lo que se midió, nunca una aproximación. El artículo sobre guardrails contra las alucinaciones en RAG muestra dónde encaja esta comprobación entre las demás capas del asistente.
El mismo principio vale para un producto. En Booq, donde dirijo la ingeniería de IA, cada trabajo muestra su precio, o su estimación de partida, antes de ejecutarse, y un trabajo fallido devuelve su cargo automáticamente, como describe el caso de estudio de Booq.
Preguntas frecuentes
¿El persa cuesta más tokens que el inglés en los modelos de OpenAI?
Sí. Sobre las mismas frases de FLORES-200, el persa necesitó 1,53× el recuento del inglés con o200k_base (GPT-4o, GPT-4.1 y GPT-5 en el mapa de tiktoken) y 3,26× con cl100k_base (GPT-4). Su propio tráfico dará otra ratio, así que cuente el suyo.
¿Cuántos tokens usa el persa en Claude o Gemini?
Esta medición no puede decirlo. Anthropic no publica ningún tokenizador para Claude, y el SDK de Gen AI de Google ofrece un recuento local experimental para algunos modelos de Gemini, construido sobre tokenizadores abiertos de Gemma, que no medí. Las ratios de arriba no se trasladan a ninguno de los dos proveedores. Use el endpoint count_tokens de Anthropic o el count_tokens de Gemini sobre peticiones reales, y vuelva a contar cuando cambie de modelo.
¿El árabe es más barato que el persa?
En cuatro de los cinco tokenizadores medidos aquí, sí: con o200k_base, el árabe necesitó 1,38× el recuento del inglés frente al 1,53× del persa. Con bge-m3 fue al revés, 1,17× frente a 1,10×, algo coherente con que los datos de entrenamiento de XLM-R contengan mucho más persa que árabe.
¿Debo quitar el ZWNJ o cambiar a formas árabes de las letras para ahorrar tokens?
No. Sustituir el ZWNJ por un espacio cambió los recuentos entre -1,57 % y -8,08 % en los tokenizadores a nivel de byte, y cambia las palabras. Las formas árabes de las letras solo ahorraron tokens con Qwen3 y costaron entre +2,20 % y +11,95 % en el resto. Las dos rompen la coincidencia exacta salvo que todas las consultas cambien de la misma manera.
¿Cuántos caracteres tiene un token en persa?
Depende del tokenizador: de 1,40 con cl100k_base a 3,68 con bge-m3 en esta medición, frente a entre 4,30 y 4,91 en inglés. Una regla plana que es segura en un tokenizador puede quedarse corta en otro. Este sitio retiró su propia reserva de dos caracteres por token después de esta ejecución y reserva el recuento de bytes en su lugar, y ese es el consejo general: reserve contra un techo o contra un recuento del proveedor, no contra una regla empírica.
Fuentes
No Language Left Behind: Scaling Human-Centered Machine Translation (NLLB Team y otros, 2022)
Language Model Tokenizers Introduce Unfairness Between Languages (Petrov y otros, NeurIPS 2023)
Petrov y otros, longitudes de tokenización sobre FLORES-200 (tokenization_lengths.csv)
Petrov y otros, script que une los splits dev y devtest de FLORES-200 (compute_tokenizations.py)
Tokenization Disparities as Infrastructure Bias (Teklehaymanot y Nejdl, 2025)
Unsupervised Cross-lingual Representation Learning at Scale (Conneau y otros, XLM-R y CC-100)
Referencia de la API de OpenAI: Chat Completions streaming events
Documentación de la API de Gemini: Understand and count tokens
Google Gen AI Python SDK: tokenizador local experimental (local_tokenizer.py)
Google Gen AI Python SDK: mapa de modelo Gemini a tokenizador Gemma (_local_tokenizer_loader.py)
Si está planificando una funcionalidad con LLM para usuarios de habla persa, defina el alcance de su proyecto.