
Architecture d’un pipeline de doublage IA : leçons de la production
Pipeline de doublage IA en production : quatre étapes de modèles, pièges du persan et le basculement de fournisseur qui a remplacé le silence après une panne.
Un pipeline de doublage par IA enchaîne quatre étapes de modèles : la transcription avec détection des locuteurs, une traduction qui respecte le minutage d’origine, une voix distincte pour chaque locuteur, puis le calage temporel et le mixage final. Les modèles, c’est la partie que l’on peut louer. Que les doublages continuent d’être livrés dépend de la plateforme qui les entoure : une passerelle par fournisseur d’IA avec basculement automatique, des files d’attente persistantes, un travail qui reprend après un plantage, un prix affiché avant l’exécution de la tâche et un remboursement quand elle échoue. Chez Booq, dont je suis CTO, la panne d’un fournisseur de synthèse vocale a un jour produit des doublages avec des silences à la place des répliques manquantes. La synthèse vocale bascule désormais le long d’une chaîne de fournisseurs : une voix légèrement différente vaut mieux que le silence.
Comment fonctionne un pipeline de doublage IA : les quatre étapes
Les travaux de recherche sur le doublage automatique décrivent une chaîne similaire. Federico et ses coauteurs (2020) sont partis d’un pipeline de traduction parole-parole (speech-to-speech translation) et y ont ajouté ce dont le doublage a besoin :
Une traduction automatique qui produit une sortie de la longueur souhaitée.
Un alignement prosodique : faire correspondre les segments de phrase et les pauses de la traduction aux segments de la parole d’origine.
Une synthèse vocale (TTS) où la durée de chaque énoncé est ajustée finement.
Un rendu audio qui ajoute le bruit de fond et la réverbération extraits de l’audio d’origine.
Quand une vidéo réunit plusieurs personnes, il faut aussi savoir qui parle.
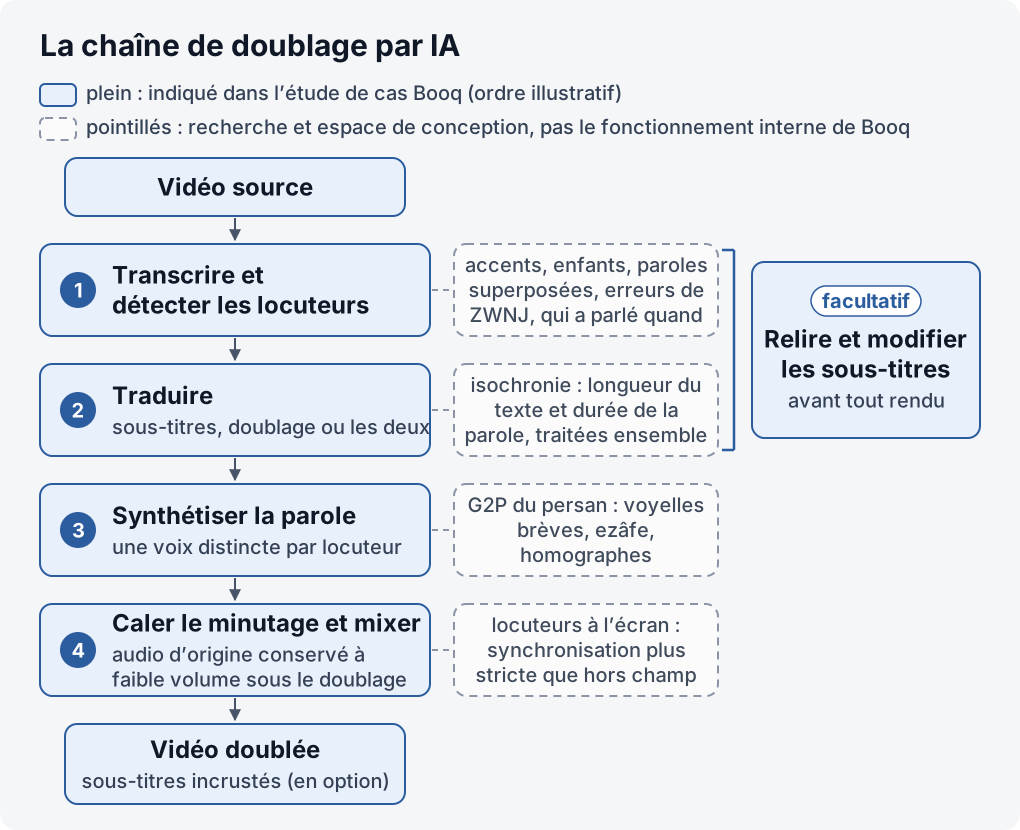
Ouvrir le schéma de la chaîne en taille réelle

Les sections consacrées aux étapes décrivent la recherche et l’espace de conception : ce que chaque étape doit résoudre et où elle casse. Elles ne décrivent le fonctionnement interne d’aucun produit, Booq compris. Quand Booq y apparaît, c’est uniquement ce qu’en dit son étude de cas, et la section sur la prononciation du persan s’appuie sur mes propres travaux de recherche en synthèse vocale. Les sections consacrées à la plateforme, elles, relèvent de mon expérience directe.
Étape 1 : transcription et détection des locuteurs
Toutes les étapes suivantes héritent de la transcription. Un mot inventé par le système de reconnaissance est traduit, mis en voix et calé dans le temps avec la même assurance qu’un mot réellement prononcé. Pour le persan, les données publiques les plus utiles sur les points faibles de la reconnaissance automatique de la parole (ASR) viennent de PSRB, un benchmark publié en 2025.
Là où la reconnaissance vocale du persan échoue
PSRB évalue dix systèmes ASR, commerciaux et open source. Sa conclusion : les modèles s’en sortent globalement bien sur le persan standard, mais peinent face aux accents régionaux, à la parole des enfants et à certaines difficultés linguistiques précises. Le détail des résultats se lit comme une description des contenus que l’on veut faire doubler :
Accents. Sur les 12 accents évalués, la précision de la reconnaissance était la plus faible pour ceux de Mashhad et de Yazd.
Enfants. Ce sont les enfants qui étaient le moins bien reconnus.
Plusieurs locuteurs. Tous les modèles faisaient plus d’erreurs sur l’audio à plusieurs locuteurs que sur l’audio à un seul locuteur. Les auteurs désignent la parole superposée comme la principale difficulté de ce type d’audio, alors même que le benchmark en contenait le moins possible, et certains modèles omettaient parfois un locuteur entier de la transcription.
Genre. Les livres audio donnaient les taux d’erreur les plus bas. Les talk-shows, l’animation et les films, où dialogues spontanés, paroles superposées et bruit de fond sont fréquents, obtenaient des résultats nettement moins bons.
Registre. La parole du benchmark est informelle à 71,3 %.
L’article recense aussi des types d’erreurs propres à l’écriture et à la parole persanes :
Frontières de mots. Le pluriel درختها (« arbres ») s’écrit avec un antiliant sans chasse (ZWNJ, zero-width non-joiner). Des erreurs apparaissent quand le ZWNJ est omis ou remplacé : درختها ou درخت ها.
Bascules de registre. Le familier میخوام برم (« je veux y aller ») peut ressortir sous sa forme soutenue میخواهم بروم, ou l’inverse.
He-Kasreh. Le /e/ bref qui marque la possession ou le rattachement peut être écrit avec la lettre he (ه) : کتاب او (« son livre ») peut être transcrit کتابه او. C’est l’ezâfe écrit en toutes lettres, ce même son non noté sur lequel l’étape 3 revient.
Paraphrase. خوش میگذره (« c’est agréable ») peut devenir حال میده (« ça fait du bien »). Le sens survit, les mots non.
Hallucination. Un texte fluide et cohérent qui ne repose en rien sur l’audio.
Dans sa forme simple, le taux d’erreur sur les mots (WER) compte chaque substitution comme un mot entièrement faux : une erreur de ZWNJ peut donc coûter autant qu’un mot différent, voire davantage. PSRB propose une variante pondérée par substitution, le SW-WER : pour chaque substitution, on calcule le taux d’erreur sur les caractères, puis on le multiplie par le nombre de mots de cet alignement, si bien qu’une erreur d’espacement coûte moins qu’un mot différent. La récupération sur du texte persan doit normaliser les mêmes caractères, comme l’explique l’article Recherche hybride pour le RAG en persan.
La conséquence pour la conception, telle que je la lis : les contenus que l’on veut faire doubler sont précisément ceux où la reconnaissance est la plus faible, et une réplique hallucinée ou paraphrasée ne reste pas dans la transcription. Elle devient une réplique doublée avec assurance. C’est l’argument en faveur d’un point de relecture avant le rendu. Booq propose les deux modes : une exécution sans intervention, ou une pause pour relire et modifier les sous-titres avant tout rendu.
Diarisation des locuteurs : qui a parlé quand
Park et ses coauteurs définissent la diarisation des locuteurs (speaker diarization) comme la tâche qui consiste à identifier « qui a parlé quand ». Dans un doublage, c’est elle qui décide de la voix attribuée à chaque réplique. Le Third DIHARD Diarization Challenge a évalué des systèmes sur 11 domaines variés et en a conclu que pour beaucoup d’entre eux, dont la vidéo web, le problème « reste loin d’être résolu ».
Le contrôle que je placerais après la diarisation, dans n’importe quel pipeline, est simple : chaque locuteur détecté a-t-il des répliques, et chaque réplique a-t-elle un locuteur ? Certains systèmes évalués par PSRB ont fait disparaître un locuteur entier de la transcription, et un locuteur perdu devient une piste de voix manquante.
Étape 2 : une traduction qui tient dans le temps imparti
Le doublage ajoute une contrainte à la traduction : la nouvelle réplique doit pouvoir être dite à peu près dans le temps qu’a pris l’original. Traduisez librement, et la voix de synthèse devra se presser, ou la réplique empiétera sur la suivante.
Isochronie : longueur et durée, un seul et même problème
Dans la recherche, cela porte un nom : l’isochronie. Chronopoulou et ses coauteurs (2023) la décrivent comme une nouvelle parole alignée dans le temps sur la vidéo d’origine, « y compris les mouvements de la bouche, les pauses, les gestes des mains ». Ils entraînent un modèle qui optimise conjointement la traduction et la durée de sa parole, et rapportent une parole qui respecte mieux le minutage d’origine que les travaux antérieurs, avec une architecture plus simple.
Les travaux antérieurs contrôlaient la longueur dans le texte. Isometric MT (Lakew et ses coauteurs, ICASSP 2022) prend comme exemple de cible une traduction dont le nombre de caractères reste à ±10 % de celui de la source, et ne cache pas le prix à payer : contrôler la longueur de la sortie coûte en qualité de traduction, et la parade habituelle consiste à générer plusieurs traductions candidates (hypothèses N-best), puis à les reclasser. Ces ±10 % sont l’exemple d’un article, pas une règle du secteur, et le nombre de caractères n’est qu’une approximation du temps qu’il faut pour dire une réplique.
Quand le rythme déraille, cela s’entend. La page d’aide de YouTube sur le doublage automatique cite le débit de parole parmi les raisons pour lesquelles une vidéo peut ne pas être éligible : une parole d’origine trop rapide « donnerait un doublage accéléré, impossible à écouter ».
Jusqu’où le minutage doit-il être strict ?
Plus strict à l’écran que hors champ et, à en juger par la pratique professionnelle, moins absolu que la recherche ne le considère souvent. Brannon, Virkar et Thompson (TACL 2023) ont étudié la façon dont les humains doublent, à partir de 319,57 heures de vidéo issues de 54 titres produits par des professionnels. Leurs résultats remettent en cause plusieurs hypothèses courantes dans la littérature sur le doublage, humain comme automatique. Ils plaident pour faire passer le naturel de la voix et la qualité de la traduction avant les contraintes isométriques (longueur en caractères) et de synchronisation labiale habituellement mises en avant, et pour une vision plus nuancée de l’importance des contraintes de minutage.
La présence du locuteur à l’écran compte aussi. Virkar et ses coauteurs (2022) ont repris le modèle d’alignement prosodique qu’ils avaient d’abord construit pour le doublage à l’écran et l’ont étendu au doublage hors champ, qui « exige des contraintes de synchronisation moins strictes » que le doublage d’un locuteur dont on voit la bouche. Le budget de minutage est donc une décision à prendre scène par scène, pas un réglage global.
Pour Booq, ce qui est publié, c’est que le minutage est calé sur l’original. L’étude de cas n’en dit pas plus sur le minutage, et je n’affirme rien de plus ici.
Étape 3 : une voix distincte pour chaque locuteur
Sur Booq, chaque locuteur détecté reçoit une voix distincte. Tout doublage multi-locuteurs exige deux propriétés de ses voix : deux locuteurs ne doivent pas se ressembler, et un même locuteur doit garder la même voix de la première à la dernière réplique. Retenez la seconde : le post-mortem plus bas raconte comment elle a perdu la partie.
Les données vocales ouvertes en persan sont maigres. Les auteurs de ParsVoice écrivent que le persan « reste considérablement sous-représenté dans les ressources ouvertes associant parole et texte ». Leur corpus comprend un sous-ensemble de 2 200 heures prêt pour la TTS, soit plus de 25 fois la taille du plus grand jeu de données TTS persan ouvert disponible jusque-là. Les données sont une contrainte. L’autre intervient avant même qu’un son existe : décider comment le texte se prononce.
Prononciation du persan : voyelles brèves, ezâfe et homographes
De juin 2021 à septembre 2022, j’ai travaillé sur un projet de recherche en synthèse vocale du persan. Il était commandé et supervisé par MCI (Hamrah-e Aval), le plus grand opérateur mobile d’Iran, et géré par la Fondation nationale des élites dans le cadre de son programme Shahid Ahmadi Roshan. La difficulté était d’ordre linguistique. Dans ce pipeline, le texte écrit passe d’abord par une conversion graphème-phonème (G2P), qui détermine sa prononciation. Un modèle de synthèse vocale et un vocodeur produisent ensuite la parole ; le vocodeur est le composant qui transforme la sortie acoustique du modèle en forme d’onde audio. L’écriture persane rend la première étape ambiguë de trois façons :
Les voyelles brèves ne sont pas écrites : le texte seul ne détermine donc pas la prononciation.
La construction ezâfe n’est pas écrite non plus et doit être déduite.
Les homographes partagent une même graphie pour des mots différents et ne peuvent être distingués sans contexte.
La recherche publiée dit la même chose. Les auteurs de GE2PE (Findings of EMNLP 2024) décrivent l’ezâfe comme un son /e/ qui relie les noms aux adjectifs et aux noms descriptifs, et donnent un exemple d’homographe : /kerm/, /kerem/ et /karam/ ont une forme écrite identique, کرم. Ils concluent que la G2P du persan a besoin d’une entrée au niveau du groupe de mots ou de la phrase pour obtenir des résultats acceptables. Doostmohammadi et ses coauteurs (2020) ajoutent que l’ezâfe n’est presque jamais marqué dans l’écriture persane, ce qui entraîne des erreurs de lecture des phrases complexes et des erreurs de traitement automatique de la langue. Le projet est présenté dans l’étude de cas sur la synthèse vocale du persan.
La conséquence pour la conception relève de ma propre déduction, pas d’un résultat de ces articles : ne donnez pas à une TTS persane les fragments en lesquels une piste de sous-titres est découpée. Une coupure de sous-titre peut scinder une chaîne d’ezâfe ou séparer un homographe des mots qui lèvent son ambiguïté. Si ketâb-e dust-e man (« le livre de mon ami ») est réparti sur deux sous-titres et que le premier fragment s’arrête à ketâb, plus rien dans ce fragment n’indique que ketâb porte l’ezâfe /e/. Synthétisez des phrases entières, puis ajustez l’audio à la timeline.
Étape 4 : calage temporel et mixage final
La dernière étape transforme des extraits en une bande-son qui appartient à la vidéo. Dans le pipeline de Federico, le rendu ajoute le bruit de fond et la réverbération extraits de l’audio d’origine, afin que la nouvelle voix s’inscrive dans la même scène acoustique que l’image.
Sur Booq, la finition peut inclure des sous-titres incrustés et stylisés pour la vidéo verticale comme pour le format panoramique, avec l’audio d’origine ou la musique de fond conservés à faible volume sous le doublage. Les sous-titres incrustés font partie de l’image : leur mise en page doit donc être décidée pour chaque format d’image avant le rendu, et aucun lecteur ne pourra la corriger ensuite.
Deux questions de conception relèvent de cette étape. La première : que faire d’une réplique dont l’audio synthétisé reste trop long après la traduction ? La recherche et la pratique offrent trois leviers, et choisir entre eux est une décision de conception, pas un résultat de recherche :
Raccourcir la réplique dès la traduction. C’est là qu’interviennent Isometric MT et les modèles qui optimisent conjointement traduction et durée.
Ajuster la durée de chaque énoncé dans la TTS. Le pipeline de Federico affine la durée énoncé par énoncé.
Accélérer la voix, dans certaines limites. Ce levier vient de la pratique plutôt que de la recherche, et il ne marche que jusqu’à un certain point : la page d’aide de YouTube prévient qu’un doublage accéléré peut devenir impossible à écouter.
La seconde question : qu’entend l’auditeur là où une réplique manque ? Celle-là s’est révélée être une question d’architecture, pas d’audio.
La plateforme autour des modèles
Tout ce qui précède, c’est de la recherche que l’on peut lire et des modèles que l’on peut louer. Sur Booq, chaque fonctionnalité dépend de fournisseurs d’IA externes, dont chacun peut tomber en panne ou évoluer indépendamment des autres. En tant que CTO, j’ai défini l’architecture de Booq et je l’ai menée du premier commit à la production ; l’étude de cas Booq décrit la plateforme. Toutes les leçons de son post-mortem se situent autour des modèles, pas à l’intérieur.
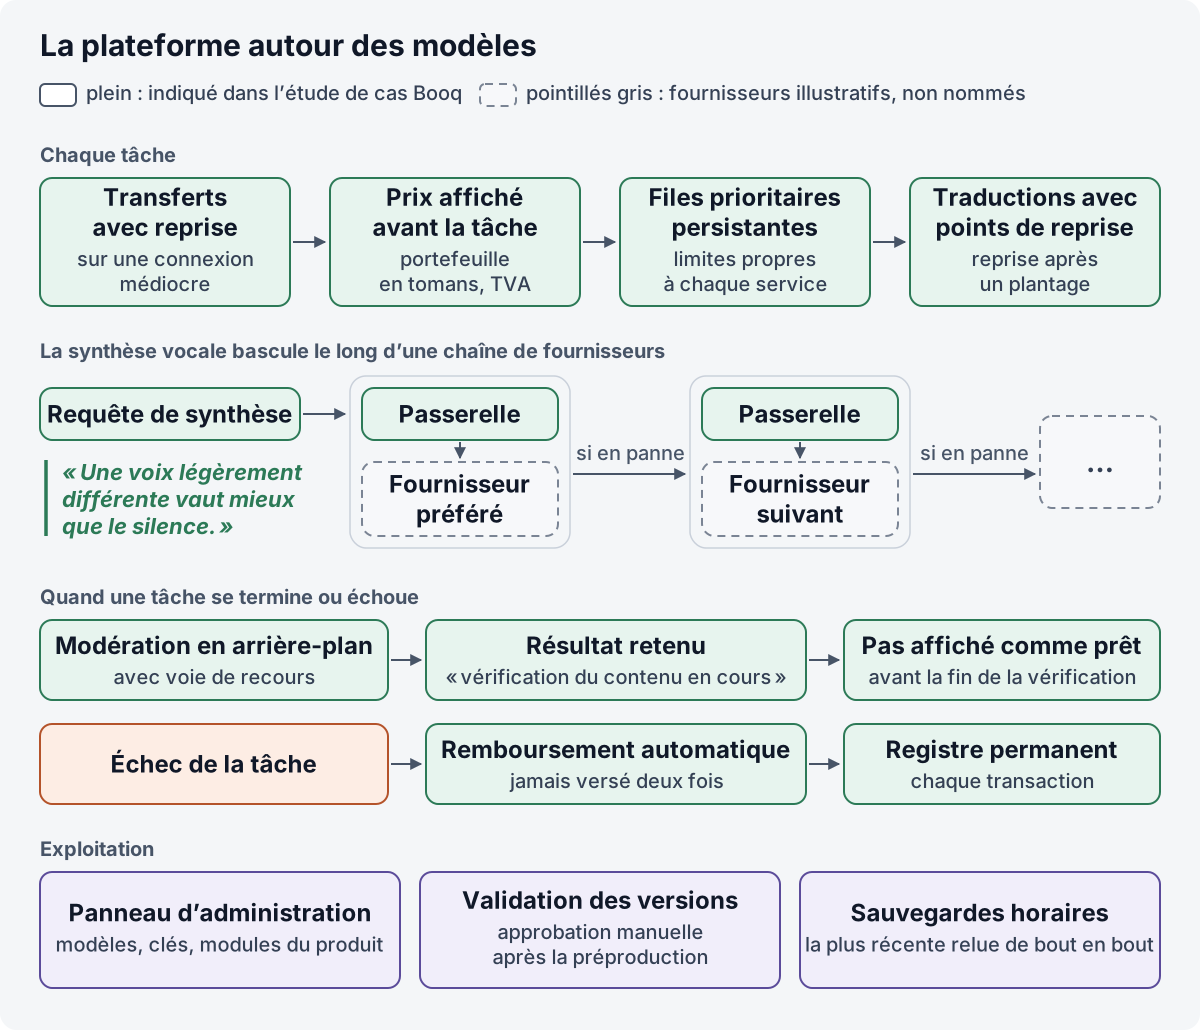
Ouvrir le schéma de la plateforme en taille réelle

Une passerelle par fournisseur d’IA
Booq est un ensemble de services indépendants derrière une seule application web, avec une passerelle distincte pour chaque fournisseur d’IA. C’est cette décision, à elle seule, qui permet de changer de modèle, de renouveler une clé ou de contourner automatiquement un fournisseur défaillant, sans toucher au reste du produit. Les modèles et les clés des fournisseurs se changent depuis le panneau d’administration, sans redéploiement. L’étude de cas associe chaque passerelle à un basculement automatique, et le post-mortem ci-dessous montre pourquoi la synthèse vocale en avait besoin.
Files prioritaires persistantes et points de reprise
Le doublage d’une longue vidéo n’a pas sa place dans une requête web. Sur Booq, les traitements lourds attendent plutôt dans des files d’attente prioritaires persistantes, avec des limites propres à chaque service. Ce sont ces limites par service qui empêchent un service très sollicité d’affamer les autres.
Les traductions enregistrent des points de reprise et repartent de là où elles s’étaient arrêtées après un plantage. Sans points de reprise, un plantage vers la fin d’une longue transcription oblige à refaire tous les appels au fournisseur effectués jusque-là, et chacun de ces appels est payé une seconde fois.
Des transferts qui reprennent sur des connexions de qualité inégale
Les fichiers vidéo volumineux arrivent sur Booq par des connexions de qualité inégale, et les transferts, y compris ceux de plusieurs gigaoctets, reprennent sur un réseau médiocre au lieu de repartir de zéro.
Le mécanisme général est en cours de normalisation. Resumable Uploads for HTTP est un Internet-Draft actif du groupe de travail HTTP de l’IETF, pas encore une RFC : si le serveur peut indiquer quelle quantité de données il a traitée avant l’interruption, le client reprend à partir de ce point au lieu de tout renvoyer. C’est un travail en cours, pas une description de l’implémentation de Booq.
Le prix avant la tâche, le remboursement en cas d’échec
La facturation fait partie du pipeline. Chaque tâche sur Booq affiche son prix, ou son estimation de départ, avant de s’exécuter. Le portefeuille est prépayé en tomans, avec la TVA affichée d’emblée, chaque transaction est inscrite dans un registre permanent, et une tâche qui échoue est remboursée automatiquement. Les remboursements sont protégés contre tout double versement.
C’est cette dernière propriété qui mérite les tests les plus poussés : une nouvelle tentative après un dépassement de délai (timeout) est précisément le moment où un remboursement naïf est versé deux fois.
Des interrupteurs plutôt que de nouvelles versions
Sur Booq, les modules du produit s’activent ou se désactivent sans nouvelle version. Dans la taxonomie des feature toggles de Pete Hodgson, cela se rapproche d’un ops toggle : une bascule qui permet aux opérateurs de désactiver ou de dégrader rapidement une fonctionnalité en production.
L’accès est cloisonné dans le même esprit. Clients, administrateurs et équipe support utilisent chacun une application déployée séparément, une session ouverte dans l’une n’est pas valable dans une autre, et les consoles exigent un second facteur, avec des permissions fondées sur les rôles.
Post-mortem : quand la cohérence des voix a perdu face au silence
Sur Booq, la synthèse vocale était d’abord volontairement confiée à un seul fournisseur, car changer de fournisseur, c’est changer de voix. Dans un doublage, la cohérence semblait être la propriété à protéger. Puis ce fournisseur a subi une panne, et des doublages ont été assemblés avec des silences à la place des répliques manquantes.
Désormais, la synthèse vocale bascule d’un fournisseur à l’autre le long d’une chaîne de secours, selon le principe qu’une voix légèrement différente vaut mieux que le silence.
Concevoir délibérément une chaîne de secours
Le choix initial n’avait rien de négligent : il protégeait une propriété réelle. L’étude de cas résume les changements de cap auxquels a conduit l’exploitation de la plateforme en production : chacun « a remplacé une hypothèse confortable par un comportement par défaut plus sûr ». La leçon : décidez quelle défaillance vous acceptez avant qu’une panne ne décide pour vous. Quand le fournisseur de synthèse vocale préféré est en panne, un pipeline peut laisser un trou, faire échouer la tâche et la rembourser, ou utiliser une autre voix. Seul le trou livre à l’auditeur un doublage troué.
Une seconde décision en découle, et ce qui suit est mon analyse, pas une description de Booq : l’étendue de ce que remplace le secours. Si seule la réplique manquante change de fournisseur, la voix de ce locuteur change en pleine scène. Si toute la piste du locuteur change de fournisseur, le doublage reste cohérent, mais davantage de travail est refait.
Le livre SRE de Google décrit une idée voisine pour les services surchargés, la dégradation progressive (graceful degradation) : faire moins de travail en abaissant la qualité des réponses. Ce qui se transpose, c’est son avertissement selon lequel « le chemin de code que vous n’utilisez jamais est celui qui (souvent) ne fonctionne pas », et son conseil d’exercer régulièrement le mode dégradé. Ce que j’ajouterais à toute chaîne de secours de synthèse vocale, à titre de recommandation et non de description de Booq : des tâches de test planifiées sur des extraits internes, à travers chaque fournisseur de la chaîne, afin de savoir que le secours fonctionne avant qu’une panne n’en ait besoin.
La bonne défaillance dépend du produit. L’assistant de ce site fait l’inverse : quand rien sur le site n’étaye une question, il répond par un refus en texte fixe plutôt que de deviner, et s’il ne considère pas que la question porte sur moi, le modèle de langage n’est jamais appelé. En questions-réponses, ne rien dire est la défaillance sûre, car une réponse fausse donnée avec assurance est pire qu’une absence de réponse. La conception est décrite dans Garde-fous contre les hallucinations en RAG, et la page RAG et sans RAG du Labo IA repose sur la même règle. Dans un doublage, c’est le silence qui est la défaillance. Savoir quelle défaillance est acceptable relève d’une décision produit, pas d’une décision de modèle.
Modérer sans faire attendre l’utilisateur
Sur Booq, le filtrage des contenus s’exécutait auparavant pendant la création du projet, si bien que les utilisateurs attendaient entre la fin de leur envoi et l’affichage de leur page de projet. Il s’exécute désormais en arrière-plan. Images, vidéos, audio et textes sont filtrés, avec une voie de recours, et un résultat terminé reste au statut « vérification du contenu en cours » jusqu’à la fin de la vérification. Aucun résultat n’est présenté comme prêt tant que sa vérification est encore en cours.
Le principe vaut pour toute vérification lente dans un pipeline média : sortez-la du chemin de la requête, et rendez l’état intermédiaire explicite.
Validation des mises en production et sauvegardes que quelqu’un a relues
Sur Booq, les déploiements en production sont passés d’un mode automatique à une approbation manuelle, qui ne se débloque qu’une fois les contrôles de préproduction réussis. Chaque version passe par la compilation, les tests, un déploiement en préproduction et un test de fumée (smoke test) avant qu’une personne n’approuve sa mise en production, et un retour d’urgence à la version précédente peut être déclenché manuellement. La plateforme tourne sur un cluster de conteneurs décrit sous forme de code.
Les sauvegardes sont devenues horaires, et la plus récente a été relue de bout en bout, car une sauvegarde que personne n’a jamais relue n’est pas une sauvegarde. Le livre SRE de Google le dit plus crûment : « Personne n’a vraiment envie de faire des sauvegardes ; ce que l’on veut vraiment, ce sont des restaurations. » Il place aussi la barre plus haut : la seule façon de savoir que l’on peut restaurer son état récent est de le faire réellement, si bien que les tests de restauration devraient être automatisés partout où c’est possible et exécutés en continu. Relire une sauvegarde de bout en bout est un minimum, pas la ligne d’arrivée.
Développer ou acheter : la checklist de tout pipeline de doublage IA
Défaillance et secours
Quand un fournisseur de synthèse vocale tombe en panne en cours de tâche, qu’obtient l’auditeur : du silence, une autre voix, ou une tâche en échec et un remboursement ? Décidez avant qu’une panne ne décide.
Quand le basculement se déclenche, remplace-t-il une seule réplique ou toute la piste du locuteur ?
Le chemin de secours est-il exercé délibérément, avec des tâches de test planifiées, ou seulement pendant les pannes ?
Plateforme et facturation
Chaque fournisseur d’IA est-il derrière sa propre passerelle, de sorte qu’un changement de modèle, un renouvellement de clé ou un contournement n’exige pas de nouvelle version ?
Les traitements lourds s’exécutent-ils depuis des files persistantes avec des limites par service, en dehors de la requête web ?
Une longue traduction peut-elle repartir d’un point de reprise, et un gros transfert peut-il reprendre après une coupure de connexion ?
Le prix ou l’estimation s’affiche-t-il avant l’exécution de la tâche, et est-il exclu qu’un remboursement soit versé deux fois ?
La modération est-elle sortie du chemin de la requête, avec un état explicite « en cours de vérification » ?
Reconnaissance, minutage et voix
La reconnaissance a-t-elle été testée sur votre propre audio : accents, enfants, parole informelle, plusieurs locuteurs, son de films et de talk-shows, et pas seulement des livres audio ?
Votre calcul du WER compte-t-il une erreur d’espacement liée au ZWNJ comme un mot entièrement faux ? Normalisez d’abord, ou utilisez une métrique pondérée comme le SW-WER.
Après la diarisation, chaque locuteur détecté a-t-il des répliques et une voix ?
Existe-t-il un point où relire et modifier les sous-titres avant le rendu ?
Quelle rigueur de minutage ce contenu exige-t-il : des visages à l’écran, ou une narration hors champ ?
La TTS persane reçoit-elle des phrases entières, et non des fragments de sous-titres qui coupent une chaîne d’ezâfe ?
Mise en production et restauration
Une personne approuve-t-elle la mise en production après les contrôles de préproduction et le test de fumée, et pouvez-vous revenir en arrière à la main ?
Quelqu’un a-t-il déjà relu une sauvegarde de bout en bout ?
Questions fréquentes
Comment fonctionne le doublage par IA ?
Un pipeline de doublage par IA transcrit la parole d’origine et détecte qui parle, traduit chaque réplique pour qu’elle puisse être dite à peu près dans le temps d’origine, donne à chaque locuteur une voix de synthèse distincte, puis cale le minutage et mixe la nouvelle parole avec le fond sonore d’origine. En production, ces étapes s’exécutent au sein d’une plateforme faite de files d’attente, de passerelles par fournisseur avec basculement et, idéalement, d’un point de relecture avant le rendu.
L’IA peut-elle doubler une vidéo anglaise en persan ?
Techniquement, oui : la chaîne est la même pour toute paire de langues. Le doublage vers le persan ajoute un problème propre à la langue à l’étape de la voix, car l’écriture ne note ni les voyelles brèves ni l’ezâfe : la prononciation doit donc être déduite du contexte. La couverture des grands services est inégale : en septembre 2026, la page d’aide de YouTube sur le doublage automatique mentionne le farsi comme langue source doublée vers l’anglais, et les vidéos en anglais n’y figurent pas comme pouvant être doublées en farsi.
Le doublage par IA suit-il le mouvement des lèvres ?
Pas forcément, et ce n’est pas toujours nécessaire. La recherche sur l’isochronie se fixe cet objectif : une nouvelle parole alignée dans le temps sur la vidéo d’origine, y compris les mouvements de la bouche, les pauses et les gestes. Le degré de précision est un choix de conception. Le doublage hors champ exige une synchronisation moins stricte que le doublage d’un locuteur dont on voit la bouche, et une vaste étude du doublage humain professionnel soutient que le naturel de la voix et la qualité de la traduction comptent davantage que les contraintes de synchronisation labiale habituellement mises en avant.
Pourquoi un doublage IA contient-il parfois des silences ou une autre voix ?
L’une des causes est la panne d’un fournisseur de synthèse vocale en cours de tâche. Un pipeline attaché à un seul fournisseur garde des voix cohérentes, mais peut laisser des trous pendant une panne ; un pipeline doté d’une chaîne de secours comble la réplique avec une voix légèrement différente. Booq est passé de la première conception à la seconde après qu’une panne a produit des doublages avec des silences à la place des répliques manquantes. Le silence peut aussi naître plus en amont, quand la reconnaissance perd un locuteur et ne laisse rien à traduire.
Comment évaluer la reconnaissance vocale du persan ?
Sur votre propre audio, pas seulement sur de la parole lue et propre. Incluez des accents régionaux, des voix d’enfants, plusieurs locuteurs et du son de films ou de talk-shows, autant de conditions où PSRB a relevé davantage d’erreurs, ainsi que de la parole informelle. Normalisez le ZWNJ et les formes arabes et persanes des lettres yeh et kaf avant de calculer le score, ou utilisez une métrique pondérée par substitution comme le SW-WER, et lisez les erreurs autant que le taux : un chiffre unique ne distingue pas une erreur d’espacement d’une phrase fluide que le locuteur n’a jamais prononcée.
Si vous envisagez de développer une solution de traitement de la parole ou de doublage, le service IA vocale couvre les chaînes TTS, ASR et doublage, y compris les cas persans difficiles.
Sources
Booq — traduction et doublage vidéo par IA, pensés d’abord pour le persan, étude de cas sur ce site
Recherche en synthèse vocale persane pour MCI, étude de cas sur ce site
Sedghiyeh et al., PSRB: A Comprehensive Benchmark for Evaluating Persian ASR Systems, arXiv, 2025 (texte intégral)
Federico et al., From Speech-to-Speech Translation to Automatic Dubbing, arXiv, 2020
Chronopoulou et al., Jointly Optimizing Translations and Speech Timing to Improve Isochrony in Automatic Dubbing, arXiv, 2023
Lakew et al., Isometric MT: Neural Machine Translation for Automatic Dubbing, ICASSP 2022
Virkar et al., Prosodic Alignment for off-screen automatic dubbing, arXiv, 2022
Brannon, Virkar et Thompson, Dubbing in Practice: A Large Scale Study of Human Localization With Insights for Automatic Dubbing, TACL, 2023
Aide YouTube, Use automatic dubbing, consulté en septembre 2026
Park et al., A Review of Speaker Diarization: Recent Advances with Deep Learning, Computer Speech & Language, 2022
Ryant et al., The Third DIHARD Diarization Challenge, arXiv, 2020
Rahmati et Sameti, GE2PE: Persian End-to-End Grapheme-to-Phoneme Conversion, Findings of EMNLP 2024
Doostmohammadi et al., Persian Ezafe Recognition Using Transformers and Its Role in Part-Of-Speech Tagging, arXiv, 2020
Ranjbar Kalahroodi, Faili et Shakery, ParsVoice: A Large-Scale Multi-Speaker Persian Speech Corpus for Text-to-Speech Synthesis, EMNLP 2026 (accepté ; arXiv v4, septembre 2026)
Google, Site Reliability Engineering: Addressing Cascading Failures
Google, Site Reliability Engineering: Data Integrity: What You Read Is What You Wrote
Groupe de travail HTTP de l’IETF, Resumable Uploads for HTTP, Internet-Draft
Pete Hodgson, Feature Toggles (aka Feature Flags), martinfowler.com, 2016, révisé en 2017